Blog — Data Vault a automatizace DWH
Články o Data Vault 2.0, automatizaci data warehousu, Snowflake, Databricks a praktickém datovém inženýrství.
-
Datová suverenita a AI: Enterprise DWH
Jak udržet kontrolu nad svými daty, když AI modely potřebují přístup ke všemu? Tento webinář ukazuje, jak zkombinovat datovou governance s moderními AI schopnostmi.
Číst více → -
Data Vault a Medallion architektura Databricks
Data Vault a Lakehouse jsou často vnímány jako protichůdné přístupy. Tento webinář ukazuje, že je tomu naopak.
Číst více → -
Jak přemýšlím o byznysové hodnotě v datech
Většina datových projektů neselhává kvůli technologii. Selhávají, protože hodnota přichází příliš pozdě, ve špatné formě nebo za příliš vysokou cenu.
Číst více → -
Certifikace ISO 27001:2022 a SOC 2 Type 2
V dnešní rychle se vyvíjející digitální krajině není bezpečnost dat jen prioritou — je nezbytností.
Číst více → -
Import datových modelů generovaných AI Flow.BI
Jak migrovat metadata z AI Flow.BI do Datavault Builderu pomocí Migration Vault — mapování hubů, linků a automatizovaných ETL pipeline.
Číst více → -
Integrace a sjednocování dat
V Data Vault modelování používáme huby pro integraci dat. Je to jeden z hlavních důvodů, proč si Data Vault modelování vybíráme.
Číst více → -
DWH analytika téměř v reálném čase
V dnešním data-driven světě poskytují kreditní karty, sítě, IoT senzory a mnoho dalších zdrojů dat data v reálném čase. Jak je efektivně zpracovat?
Číst více → -
SSO na Snowflake Snowpark Container Services
Použití Datavault Builderu se Snowpark Container Services (SPCS) umožňuje datovým týmům nasazovat řešení bez závislosti na infra týmech.
Číst více → -
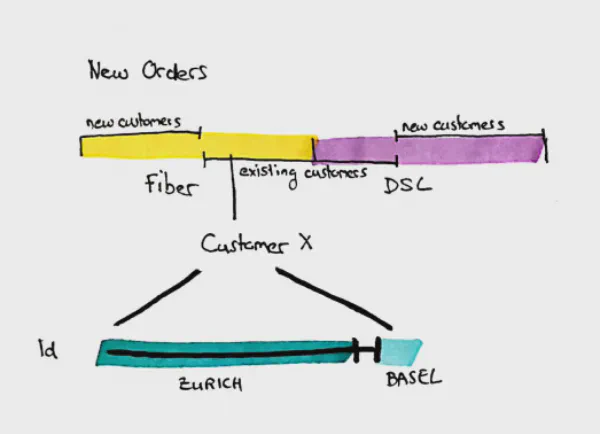
Bi-temporální zpracování dat
Ať už pracujete se zákaznickými účty, finančními transakcemi nebo pojistnými událostmi, tento webinář vás vybaví pro zpracování bi-temporálních dat.
Číst více → -
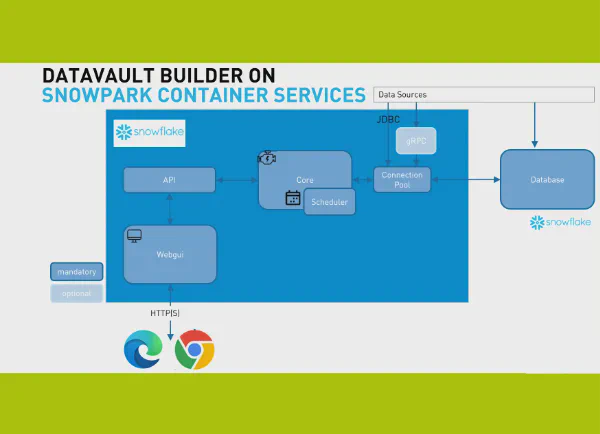
DVB na Snowflake Snowpark Container Services
V tomto videu demonstrujeme, jak jednoduché je provozovat Datavault Builder na Snowflake Container Services.
Číst více → -
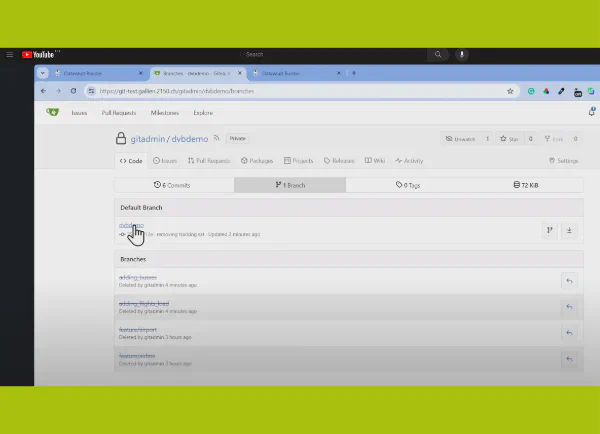
Přímý GIT Check-In a Check-Out modelu
Vítejte u naší krátké prezentace Datavault Builderu 7.1 a jeho nové funkce GIT check-in a check-out pro agilní vývoj.
Číst více → -
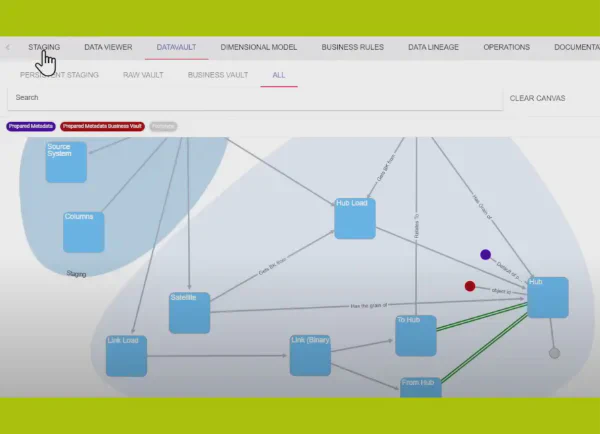
Koncept Migration Vaultu
Migration Vault je specializované úložiště metadat navržené jako Data Vault. Usnadňuje migraci dat ze starého formátu do nového a zajišťuje kompatibilitu.
Číst více → -
Srovnání alternativy k Talend Open Studio
Datavault Builder nabízí širokou škálu funkcí a modulů za stejnou cenu jako dříve bezplatné ETL nástroje.
Číst více → -
Automatizace Unified Star Schema
V tomto videu se diváci ponoří do světa automatizovaného data warehousingu s Unified Star Schema, konceptem od Francesca Puppiniho a Billa Inmona.
Číst více → -
Yale University: revoluce ve správě dat — 75% úspora a rychlejší insighty
Jak Yale University využila Datavault Builder ke snížení účtovaných hodin o 75 %, rozšíření datového týmu a urychlení time to insight.
Číst více → -
Případová studie BI-SPEKTRUM: C&A na Snowflake
BI-SPEKTRUM publikoval v čísle 2023/3 článek o tom, jak jeden z našich zákazníků používá Datavault Builder pro integraci dat ze SAP.
Číst více → -
Případ užití Willibald od DDVUG
Sledujte případ užití DDVUG Willibald: vybudování kompletního Data Warehousu se 2 zdroji dat za méně než 3 hodiny pomocí Datavault Builderu.
Číst více → -
Je datové modelování mrtvé?
Potřebujeme stále datové modely? Jaká je hodnota modelů? Proč datové modelování v minulosti selhávalo? Jak vytvářet hodnotu modelováním?
Číst více → -
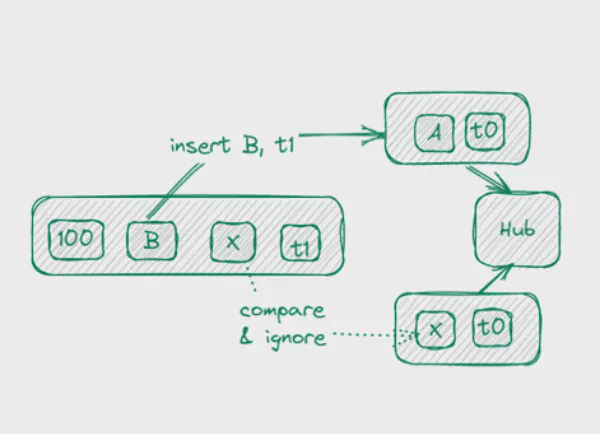
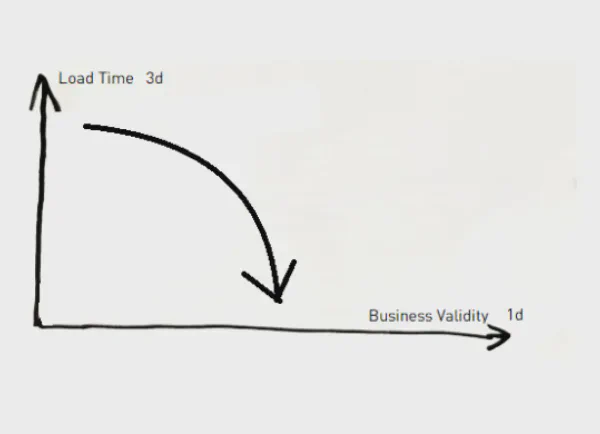
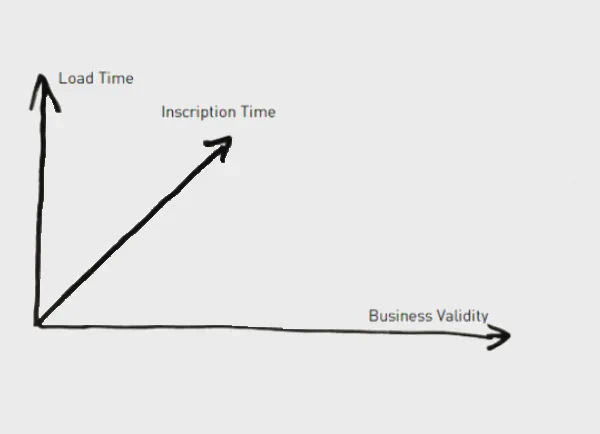
Data Vault bi-temporálně: Inscription Time
Jak načítat bi-temporální data do Data Vaultu pomocí Inscription Time — patterny, úskalí a praktické příklady.
Číst více → -
Data Vault vs. Data Mesh: Srovnání
Mám stále dělat Data Vault, když existuje Data Mesh? V posledních týdnech a měsících jsem dostal tyto velmi zajímavé otázky, které se opakovaně objevují.
Číst více → -
CI/CD s Datavault Builderem na Snowflake
Jak použít Zero Copy Cloning od Snowflake s Datavault Builderem k vybudování silné CI/CD pipeline pro váš data warehouse.
Číst více → -
Záleží vždy na Equi-Joinech?
Občas narazím na nějaká tvrzení o tom, jak databáze fungují a jak se mají dotazovat. A rád taková doporučení čtu.
Číst více → -
3NF a Data Vault: není čeho se bát
Občas dostáváme zajímavou otázku: podporuje Datavault Builder 3NF? Odpověď je ano — a takto to funguje.
Číst více → -
DWH Temporalita Pt.4: SCD Type 2 dimenze
Kimballovský styl dimenzí — SCD Type 2 výstup. Pokud jste je nečetli, doporučuji nejdříve přečíst první 3 části.
Číst více → -
DWH Temporalita Část 3: Výstup timeline
Ačkoli v mnoha případech není nutné vystupovat timeline v reportech, existují případy, kdy je výstup timeline důležitý.
Číst více → -
DWH Temporalita Část 2: Snižování složitosti
Jak snížit temporální složitost v Data Vaultu. Uživatelé Datavault Builderu se často ptají, jak správně mapovat změny v čase.
Číst více → -
DWH Temporalita Část 1: Výzva
V uplynulých letech jsem byl konfrontován s požadavkem vytvořit reporting s dimenzemi SCD type 2.
Číst více → -
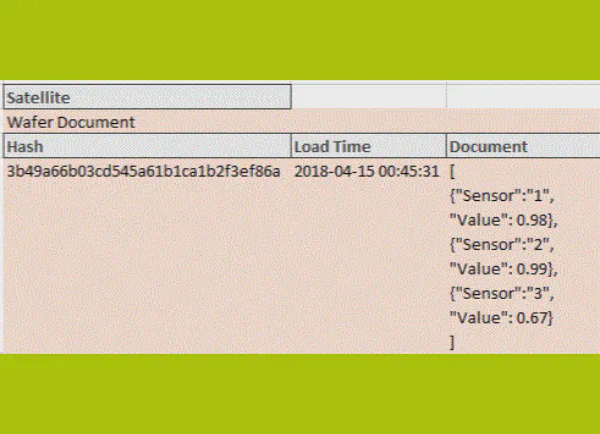
O Multi-Active satelitech v Data Vaultu
Petr Beles o implementaci Multi-Active satelitů jako Document satelitů v Data Vaultu: patterny, kompromisy a praktická doporučení.
Číst více → -
O Linkách
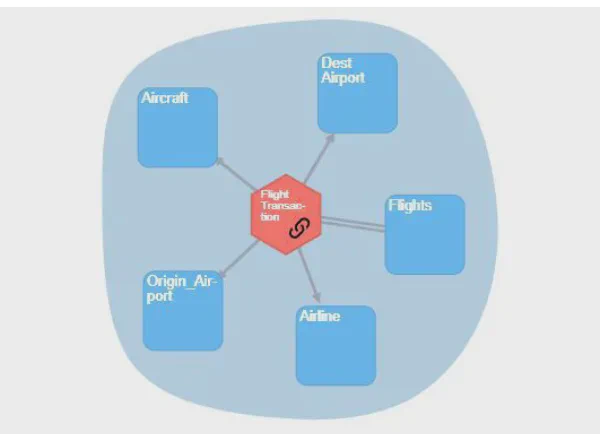
Petr Beles o Data Vault linkách reprezentujících transakce: patterny, úskalí a návrhová rozhodnutí při modelování transakčních linků.
Číst více → -
Qlik
Ukazují vaše Qlik aplikace a Power BI reporty různá čísla?
Chybu nemá Qlik ani Power BI. Každý má vlastní logiku načítání, vlastní definice a vlastní lineage, takže se stejná metrika počítá dvakrát a nikdo je nedokáže sladit. Pravidla patří do jednoho spravovaného modelu v datovém skladu, ze kterého čtou oba nástroje.
Číst více → -
Tableau
Máte na Tableau Serveru příliš mnoho verzí stejného čísla?
Každý publikovaný soubor .tdsx byl v den svého vzniku rozumný. Dohromady jsou to stovky soukromých definic stejné metriky a žádný způsob, jak poznat, která je správná.
Číst více → -
Power BI
Ukazují vaše Power BI reporty pro stejný ukazatel různá čísla?
Finance, Obchod i Provoz si každý postavili vlastní sémantický model a každý z nich je vnitřně konzistentní. Definice nebyly špatně na jednom místě. Nebyly dohodnuté nikde.
Číst více → -
Qlik
Čistíte stejná data znovu v každém načítacím skriptu v Qliku?
Stejné mapovací loady, opravy textových řetězců a deduplikace se znovu píšou v každé aplikaci a každé vrstvě QVD a jejich kopie se rozcházejí. Čištění se opakuje v každém skriptu, protože ho žádná integrovaná vrstva datového skladu neudělá jednou.
Číst více → -
Qlik
Jsou vaše výrazy Set Analysis v Qliku příliš dlouhé a pomalé?
Set Analysis je přesný nástroj pro skutečná srovnání. Většina dlouhých výrazů ve vaší aplikaci tam je, protože model nikdy nedodal historii, příznaky ani jednu granularitu, takže je graf skládá znovu při každém výběru.
Číst více → -
Tableau
Jsou vaše LOD výrazy v Tableau tak složité, že se jich bojíte dotknout?
FIXED, INCLUDE a EXCLUDE jsou přesné nástroje pro skutečné otázky nad více granularitami. Většina těch ve vašem workbooku tam je, protože datový sklad nikdy nevyřešil granularitu ani neuchoval historii.
Číst více → -
Power BI
Je váš Power BI report v DirectQuery pomalý při každém kliknutí?
DirectQuery a Direct Lake slibují živá data. Dostanete třicetisekundový vizuál a účet za výpočetní výkon, který nikdo nechce vysvětlovat. Problém není v režimu. Je ve schématu pod ním.
Číst více → -
Qlik
Vytvářejí vaše Qlik aplikace pořád syntetické klíče?
Syntetické klíče a cyklické reference jsou jen Qlik, který přesně asociuje to, co dostal. Vznikají, protože data přicházejí bez konformních dimenzí a skutečných klíčů, takže si je musí vymyslet každá aplikace.
Číst více → -
Qlik
Selhávají vám reloady v Qliku s tím, jak data rostou?
In-memory engine je rychlý, protože všechno leží v RAM. Reloady selhávají a aplikace se zpomalují, když tuto RAM zaplní detail na úrovni řádků a transformace, které předtím neudělal žádný datový sklad.
Číst více → -
Tableau
Selhává vám refresh extractů v Tableau, nebo nestíhá doběhnout?
Tableau Backgrounder skončí timeoutem, soubor .hyper stále roste a dashboard ukazuje včerejšek. Extract je velký, protože nese surové řádky, které se výše v řetězci nikdy neagregovaly.
Číst více → -
Power BI
Je váš DAX kód v Power BI už příliš složitý na údržbu?
Dvě stě řádků CALCULATE a FILTER není známka pokročilého DAX. Obvykle je to známka toho, že vám datový sklad nikdy nedal klíče, historii ani granularitu, kterou jste potřebovali.
Číst více → -
Tableau
Je váš Tableau dashboard pomalý při každé změně filtru?
Dvacet sekund "Executing Query" při každém kliknutí na filtr. Tableau nevykresluje pomalu. Čeká na databázi, která dostala otázku, na kterou nedokáže rychle odpovědět.
Číst více → -
Power BI
Selhává vám refresh v Power BI každou noc?
Naplánovaný refresh skončí timeoutem, Power Query dojde paměť a vy se to dozvíte, až když někdo otevře dashboard. Příčinou téměř nikdy není Power BI. Je to práce, kterou po Power BI chcete.
Číst více → -
dbt
Druhá strana mince dbt: Bujení kódu, skryté náklady a cesta k automatizaci
dbt přineslo do SQL modularitu a Git, čímž posunulo analytické inženýrství. S růstem projektů se však projevují limity: provozní režie Core versus poplatky za vývojáře v Cloudu, absence ingestu a záplava ručně psaných modelů. Platforma řízená modelem tuto volbu překonává.
Číst více → -
Azure Data Factory
Úskalí Azure Data Factory: Skryté náklady vizuálních pipelines a Sparku
Azure Data Factory je dobrá transportní vrstva v rámci Azure a nevhodné místo pro uchovávání logiky datového skladu. Její nasazení v roli modelovací a transformační platformy přináší nepřehledné plátno, nasazení selhávající na ARM šablonách a clustery Sparku pro dávky, které zvládne jediný SQL příkaz. A každá z těchto pipelines existuje jen v Azure.
Číst více → -
dbt
Proč vás dbt nutí hledat další nástroj dříve, než můžete začít modelovat?
dbt transformuje data, která již leží ve vašem skladu. Nic ze zdrojových systémů samo neextrahuje, nepřipojuje ani nenahrává. Pro kompletní sklad potřebujete další nástroj na ingest, další na orchestraci a propojení mezi nimi. Platforma řízená modelem řeší ingest i transformaci na jednom místě.
Číst více → -
SSIS
Uvažujete o přesunu svých balíčků SSIS do cloudu metodou lift-and-shift?
Starší projekty v SSIS s sebou nesou tři neduhy, které cloudový virtuální server nevyřeší: balíček pro každou tabulku, na který se nikdo neodvažuje sáhnout, nasazování mimo DevOps a architekturu svázanou s SQL Serverem. Azure-SSIS Integration Runtime přenáší všechny tři do cloudu beze změny. Model, který sklad generuje, je učiní zbytečnými.
Číst více → -
dbt
Způsobují modely v dbt nárůst účtů za výpočetní výkon ve Snowflake nebo BigQuery?
dbt spouští veškerý kód přímo uvnitř vašeho analytického skladu. Pokud jsou modely nastaveny jako kompletní přenačtení celých tabulek nebo využívají ručně psané inkrementální strategie, spotřeba kreditů stoupá s každým během. V Data Vaultu generovaném z modelu je přírůstkové nahrávání jediný způsob, jakým nahrávání vzniká.
Číst více → -
Azure Data Factory
Stojí vaše Azure Data Factory Mapping Data Flows více než data, která zpracovávají?
Mapping Data Flows běží na spravovaném Spark clusteru, který startuje několik minut a účtuje se za vCore-hodinu. Pro rozsáhlou noční transformaci to dává smysl. Pro pár set tisíc řádků je to spouštění clusteru jen proto, aby vykonal to, co by v datovém skladu vyřešil jediný SQL příkaz.
Číst více → -
dbt
Proměnil se váš DAG v dbt v nepřehlednou síť, kterou nikdo nedokáže ladit?
Vytvořit nový model v dbt je tak snadné, že repozitáře rychle zaplní stovky SQL souborů bez jasných pravidel správy. Změna obchodního klíče výše v řetězci pak znamená dohledat každý model, který jej zdědil. Řešením je strukturovaná architektura řízená modelem s jasnými pravidly odvozování.
Číst více → -
SSIS
Provozujete stále SSIS na licencovaném SQL Serveru jen proto, abyste plnili Snowflake či cloud?
SQL Server Integration Services (SSIS) vznikly pro lokální ekosystém Microsoftu. Jejich použití pro plnění moderních cloudových skladů, jako jsou Snowflake, Databricks nebo Fabric, vyžaduje vyhrazené servery, konektory třetích stran a zbytečné licence pro SQL Server. Řešením je generovat nahrávání nativně přímo v cílovém databázovém stroji.
Číst více → -
dbt
Je dbt Core skutečně zdarma po započtení nákladů na platformní inženýrství?
dbt Core je bezplatné na spuštění a drahé na provoz. dbt Cloud se snadno provozuje, ale účtuje se za vývojáře a spotřebu. V obou případech nese transformační vrstva reálné náklady rostoucí s týmem. Alternativou je platforma řízená modelem, která snižuje objem ručně psaného kódu.
Číst více → -
Azure Data Factory
Mění se každé nasazení Azure Data Factory v boj s ARM šablonami?
Pod vizuálním editorem je Azure Data Factory JSON: pipelines, datasety, linked services a ARM šablona, která je nasazuje. Přenesení změny z Dev do Prod znamená soubory parametrů, globální parametry a šablonu, která selže na jediné neshodě typů. Releases by měly být generovány z modelu, včetně rollbacku.
Číst více → -
Fivetran
Potíže s náklady a nepružným schématem ve Fivetranu? Řešením je automatizace modelování
Plně spravovaný ELT je rychlý na rozjezd, ale náročný na řízení ve větším měřítku. Postupem času se vytrácejí dvě věci: kontrola nad náklady na pipeline a rozhodování o struktuře dat. Automatizovaná vrstva Data Vault vám obojí vrátí, aniž byste se museli vzdát fungujících konektorů.
Číst více → -
SSIS
Je SSIS jedinou součástí vašeho technologického stacku, která stále nezvládá CI/CD?
Soubor .dtsx je kód XML, který se v Gitu špatně porovnává a ještě hůř slučuje; pokud dva inženýři upraví stejný balíček, obvykle to končí jeho ruční přestavbou. Prostředí závisejí na ručně udržovaných proměnných v SSISDB. Releases by měly vznikat z modelu, pro každé prostředí zvlášť, včetně rollbacku.
Číst více → -
Fivetran
Čistíte v SQL ručně schémata, která Fivetran do skladu nahrál automaticky?
Fivetran ukládá každý zdroj do vlastního schématu předdefinovaného dodavatelem. Obchodní klíče, vlastní pole a historické struktury je pak nutné přetvářet v ručním SQL, které se rozbije při každé změně konektoru. Řešením není další skript, ale model, který strukturu řídí.
Číst více → -
Azure Data Factory
Přerostlo plátno Azure Data Factory tým, který jej původně vybudoval?
Pipeline sestavená přetahováním myší vznikne rychle, ale mění se pomalu. Po překročení několika desítek aktivit se z plátna stává jediná dokumentace, vizuální vazby nahrazují obchodní logiku a každý nový zdroj znamená další aktivitu kopírování, na kterou nikdo nechce sahat. Řešením není uklizenější plátno, ale model, který pipelines generuje.
Číst více → -
Fivetran
Způsobují Monthly Active Rows (MAR) ve Fivetranu nepříjemná překvapení v rozpočtu?
Fivetran účtuje podle Monthly Active Rows (MAR): řádků vložených či aktualizovaných v daném měsíci. Hromadná aktualizace ve zdroji, migrace nebo historické přenačtení znásobí počet řádků a vystřelí fakturu vzhůru. Přímý ingest do skladu spojený s vaultem, který přenáší pouze delty, udržuje náklady pod kontrolou.
Číst více → -
SSIS
Převyšuje počet vašich balíčků SSIS počet lidí, kteří jim rozumí?
Stovky balíčků .dtsx, jeden pro každou tabulku, vytvořené ve Visual Studiu kýmkoli, kdo zrovna řešil daný úkol, s řídicími a datovými toky, jež se otevírají jen po jednom. Přidání sloupce znamená otevírat balíčky jeden po druhém. Řešením není šablona balíčku, ale model, který nahrávání generuje nativně pro SQL Server, Azure SQL nebo Fabric.
Číst více →
Zatím tu nic není.