Čistíte v SQL ručně schémata, která Fivetran do skladu nahrál automaticky?
Fivetran ukládá každý zdroj do vlastního schématu předdefinovaného dodavatelem. Obchodní klíče, vlastní pole a historické struktury je pak nutné přetvářet v ručním SQL, které se rozbije při každé změně konektoru. Řešením není další skript, ale model, který strukturu řídí.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Každý konektor vytváří vlastní uzavřené schéma a vazby mezi nimi se píší ručně pro každý zdroj v navazujícím SQL.
- Aktualizace konektoru přejmenovala sloupce nebo změnila datové typy a shodila navazující analytické modely v produkci.
- Reporty v BI nástroji se připojují přímo na vstupní tabulky konektoru, protože tým neměl kapacitu vybudovat integrační vrstvu.
- Datová lineage končí u tabulky konektoru; chybí dokumentace vysvětlující, jak se zdrojové klíče promítly do podnikového modelu.
Hlavním příslibem spravovaného ingestu je rychlé zprovoznění: připojíte aplikaci a její tabulky se samy objeví v datovém skladu. Tato jednoduchost je však vykoupena technickým omezením: strukturu cílových tabulek plně diktuje dodavatel konektoru.
Proč pevná schémata způsobují potíže
- Schéma odpovídá API zdroje, nikoli vašemu byznysu. Struktura v Salesforce, HubSpotu nebo NetSuite zrcadlí interní architekturu těchto aplikací, která se jen zřídka kryje s pojmy, s nimiž pracuje vedení vaší společnosti.
- Navazující SQL se stává neřízeným modelem. Aby analytici sjednotili zákazníky ze tří různých systémů, píší komplikované SQL dotazy plné přetypování, unifikací a deduplikací, které nikdo centrálně nespravuje.
- Křehkost při změnách konektoru. Jakmile dodavatel vydá novou verzi API nebo přidá nová pole, mezilehlé skripty mohou nečekaně selhat.
- Chybějící spolehlivá historie. Řada konektorů poskytuje pouze aktuální snímek stavu a postrádá časový vývoj nezbytný pro audity a regulatorní výkaznictví.
Kde má vznikat struktura dat
V agilním datovém skladu musí být organizace sama pánem svého informačního modelu:
- Důsledné oddělení vrstev. Zdrojová data se beze změn uloží do stagingu. Model skladu se naproti tomu navrhuje kolem trvalých podnikových konceptů (zákazník, produkt, smlouva).
- Sjednocení v modelu, nikoli ve skriptech. Propojení obchodních klíčů z různých systémů se řeší deklarativně v centrálních hubech a lincích.
- Automatické řízení změn. Pokud se textové pole prodlouží nebo přibude atribut, platforma přizpůsobí strukturu databáze bez nutnosti zásahu vývojáře.
Co nabízí Datavault Builder
Datavault Builder nahrazuje ruční dodatečné skripty automatizovanou vrstvou Data Vault 2.0 řízenou modelem:
- Sjednocená struktura odolná vůči změnám. Změny ve schématech konektorů se vstřebají do satelitů, aniž by došlo k narušení vazeb či výstupních pohledů.
- Přirozené sjednocení identit. Zákazníci z více systémů se integrují do společného hubu při zachování plné sledovatelnosti původního zdroje.
- Jednotná kvalita nahrávání. Veškeré nahrávací procesy sdílejí stejné standardy kvality, výkonu a ošetření chyb.
- Živá dokumentace a lineage. Každá transformace je automaticky dokumentována přímo z modelu, což usnadňuje audity shody s předpisy.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Oddělit staging od integrace
Považujte tabulky konektoru striktně za surová data ve stagingu. Nikdy nenechávejte reporty číst přímo ze schémat dodavatele.
-
Modelovat podle podnikového standardu
Vizuálně namapujte vstupní tabulky na entity Data Vault 2.0 nezávislé na konkrétním zdroji.
-
Automatizovat adaptaci na změny
Nechte platformu automaticky rozšiřovat sloupce a spravovat datové typy bez nutnosti přepisovat nahrávací skripty.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Potíže s náklady a nepružným schématem ve Fivetranu? Řešením je automatizace modelování
Plně spravovaný ELT je rychlý na rozjezd, ale náročný na řízení ve větším měřítku. Postupem času se vytrácejí dvě věci: kontrola nad náklady na pipeline a rozhodování o struktuře dat. Automatizovaná vrstva Data Vault vám obojí vrátí, aniž byste se museli vzdát fungujících konektorů.
-
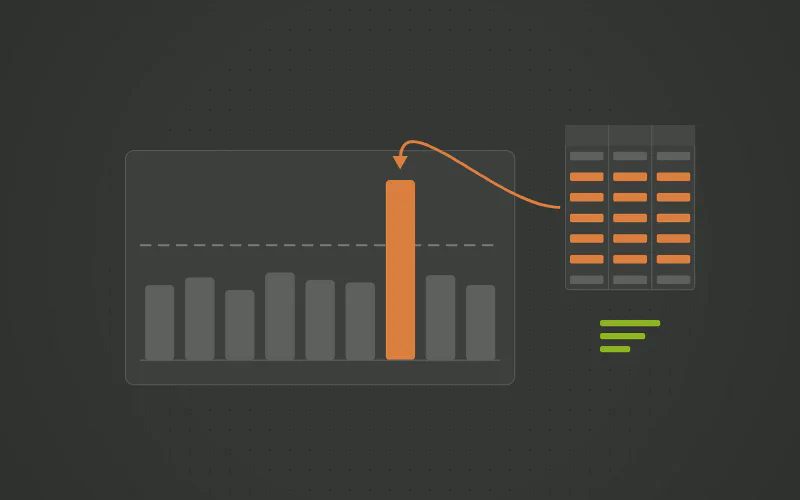
Způsobují Monthly Active Rows (MAR) ve Fivetranu nepříjemná překvapení v rozpočtu?
Fivetran účtuje podle Monthly Active Rows (MAR): řádků vložených či aktualizovaných v daném měsíci. Hromadná aktualizace ve zdroji, migrace nebo historické přenačtení znásobí počet řádků a vystřelí fakturu vzhůru. Přímý ingest do skladu spojený s vaultem, který přenáší pouze delty, udržuje náklady pod kontrolou.
Otázky a odpovědi
- dbt nahrazuje živelné psaní skriptů verzovaným vývojem v Gitu, ale samotná práce na návrhu a kódování modelů ve staging vrstvě, sjednocování klíčů a historizaci stále leží na lidech. Datavault Builder generuje integrační vrstvu plně automaticky z vizuálního modelu a vzniklé tabulky lze používat přímo nebo je zapojit do stávajících projektů v dbt.
- V ručně psané vrstvě mohou závislé dotazy havarovat. V Datavault Builderu se nový sloupec ve zdroji detekuje v rozhraní a do odpovídajícího satelitu se zahrne pouhou aktualizací vizuálního mapování bez narušení existujících vazeb či datových martů.
- Surová vrstva (raw vault) je Data Vault 2.0, což je právě to, co jí umožňuje absorbovat změny ve zdrojích bez narušení historie. Nad ní Datavault Builder generuje dimenzionální marty nebo schémata ve 3NF, takže byznys uživatelé vidí přehledné hvězdicové schéma (star schema).