Způsobují Monthly Active Rows (MAR) ve Fivetranu nepříjemná překvapení v rozpočtu?
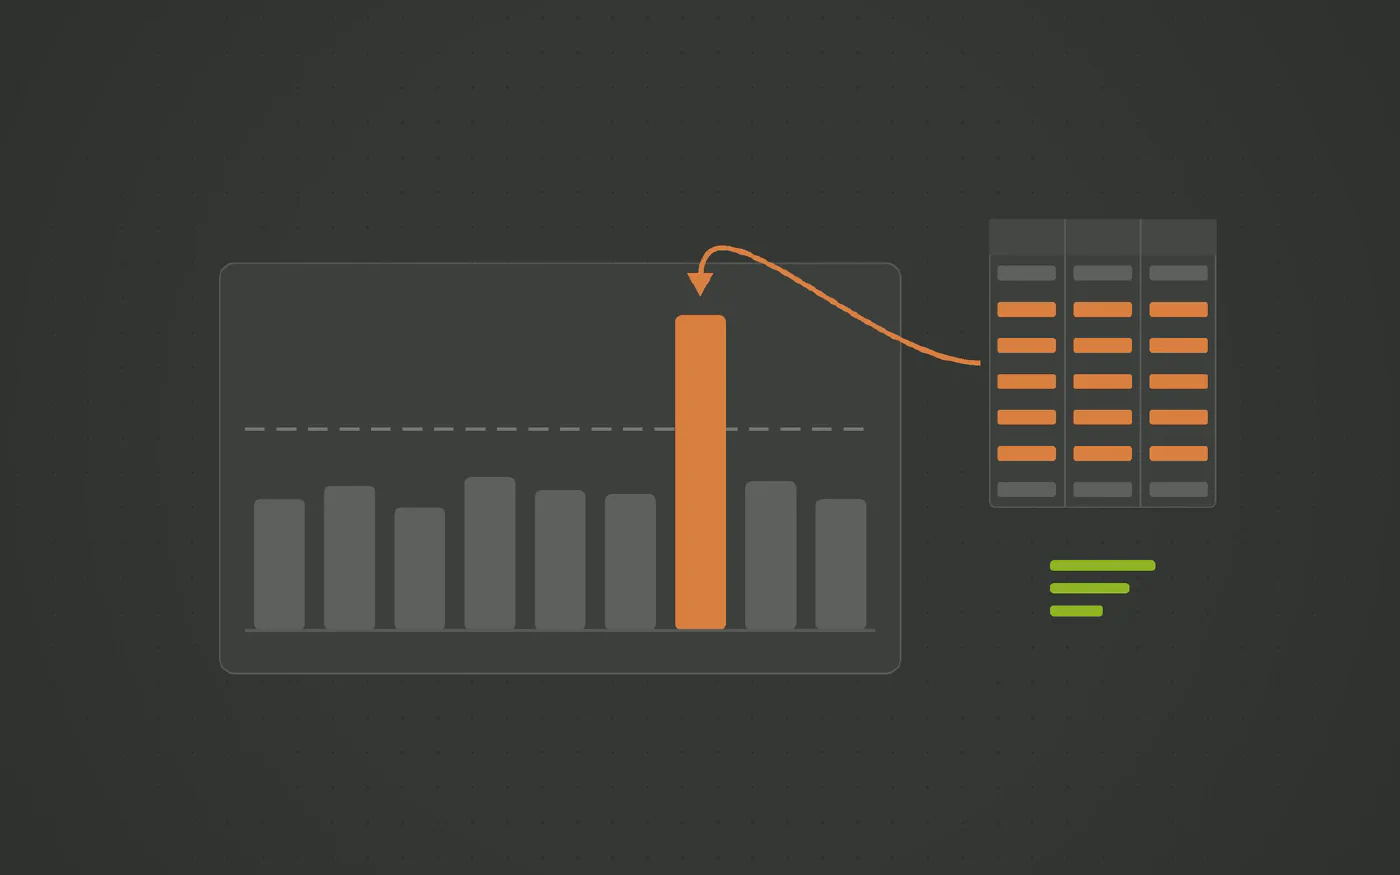
Fivetran účtuje podle Monthly Active Rows (MAR): řádků vložených či aktualizovaných v daném měsíci. Hromadná aktualizace ve zdroji, migrace nebo historické přenačtení znásobí počet řádků a vystřelí fakturu vzhůru. Přímý ingest do skladu spojený s vaultem, který přenáší pouze delty, udržuje náklady pod kontrolou.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Měsíční faktura za Fivetran skokově narostla po hromadné aktualizaci dat v ERP nebo CRM systému.
- Tým inženýrů se záměrně vyhýbá synchronizaci celých historických tabulek kvůli obavám z dopadu na počet MAR.
- Předpovědět náklady na službu pro další čtvrtletí je prakticky nemožné, což komplikuje plánování rozpočtu.
- Platí se licenční poplatky za každý řádek při přesunu dat mezi interními databázemi běžícími ve stejné síti.
Model účtování založený na Monthly Active Rows (MAR) je z pohledu poskytovatele SaaS srozumitelný: měří aktivitu v datech tím, že započítá každý unikátní řádek vložený nebo upravený v průběhu měsíce.
Potíže nastávají ve chvíli, kdy se datový sklad potká s reálným fungováním podnikových systémů.
Proč je rozpočet s MAR nepředvídatelný
- Hromadné provozní aktualizace. Plošná úprava v CRM za účelem opravy telefonních předvoleb nebo přeřazení PSČ modifikuje miliony existujících řádků. Z pohledu byznysu nevznikla nová data, ale konektor zaznamená miliony zpoplatněných MAR.
- Migrace a čištění dat. Přechod na novou verzi ERP nebo odstraňování duplicit zasáhne téměř všechny záznamy kmenových tabulek, což v daném měsíci fakturu znásobí.
- Nežádoucí motivace pro inženýry. Datové týmy jsou nuceny filtrovat sloupce nebo omezovat četnost synchronizací kvůli hlídání rozpočtu, čímž ochuzují byznys o cenná data.
- Placení mýtného za vlastní data. Účtování za řádek má své opodstatnění u složitých cloudových API; při přenosu dat mezi dvěma vlastními databázemi je ale neekonomické.
Cesta k předvídatelným nákladům
Udržitelná architektura vyžaduje oddělit rozvoj analytiky od proměnlivých poplatků za řádky:
- Nativní ingest pro objemné zdroje. Provozní databáze, velké soubory a kontinuální toky mají proudit přímo přes databázová spojení (JDBC) či CDC bez prostředníků účtujících za řádek.
- Důsledné filtrování delt ve skladu. Plné přenačtení ve stagingu nesmí způsobit přepsání celého historického skladu. Vygenerované nahrávání v Data Vaultu porovná hashové otisky a uloží pouze ty řádky, které skutečně zaznamenaly změnu obsahu.
- Kapacitní model nákladů. Dimenzování analytické infrastruktury probíhá ve vašem vlastním cloudu s pevnými a plánovatelnými rozpočty.
Řešení s Datavault Builderem
Datavault Builder navrací do financování datové platformy předvídatelnost:
- Vestavěný ingest bez poplatků za řádky. Dávky, delty i CDC z databází, souborů, REST API i streamingu (Kafka v micro-batches) běží přímo v rámci platformy.
- Inteligentní absorpce přenačtení. Zreplikuje-li zdroj celou tabulku, satelity v Datavault Builderu identifikují skutečně změněné záznamy a zabrání zbytečnému přepočítávání v martech.
- Transparentní softwarová licence. Pevná serverová licence nepřináší na konci měsíce nepříjemná překvapení způsobená výkyvy v provozních aplikacích.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Identifikovat hlavní zdroje MAR
Vyhledejte tabulky s vysokou frekvencí aktualizací nebo hromadnými procesy, které spotřebovávají většinu měsíčních aktivních řádků.
-
Nahrávat interní databáze bez poplatků za řádek
Převeďte ingest interních systémů na přímá databázová spojení (JDBC, CDC) integrovaná v automatizační platformě.
-
Izolovat plná přenačtení ve stagingu
Uložte plná data do stagingu a využijte Data Vault k tomu, aby se do historického modelu přenesly výhradně skutečné delty.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Potíže s náklady a nepružným schématem ve Fivetranu? Řešením je automatizace modelování
Plně spravovaný ELT je rychlý na rozjezd, ale náročný na řízení ve větším měřítku. Postupem času se vytrácejí dvě věci: kontrola nad náklady na pipeline a rozhodování o struktuře dat. Automatizovaná vrstva Data Vault vám obojí vrátí, aniž byste se museli vzdát fungujících konektorů.
-
Čistíte v SQL ručně schémata, která Fivetran do skladu nahrál automaticky?
Fivetran ukládá každý zdroj do vlastního schématu předdefinovaného dodavatelem. Obchodní klíče, vlastní pole a historické struktury je pak nutné přetvářet v ručním SQL, které se rozbije při každé změně konektoru. Řešením není další skript, ale model, který strukturu řídí.
Otázky a odpovědi
- Nikoli nutně. Mnoho týmů si ponechává konektory pro dlouhý chvost aplikací SaaS a na přímý ingest převádí pouze nákladné a objemné tabulky. Data Vault stojí za oběma cestami, takže navazujícímu modelu je jedno, jakou trasou do něj data doputovala.
- Dokumentace Fivetranu uvádí, že počáteční historická synchronizace i přenačtení vyvolaná konektorem jsou od MAR osvobozena. Avšak hromadné aktualizace provedené v provozních systémech, datové migrace a dodatečné přepočty mění existující řádky a do MAR se plně započítávají. Navíc v datovém skladu znamená každé neinkrementální přenačtení zbytečný výpočetní výkon vynaložený na zpracování nezměněných dat.
- Spotřebovávají výpočetní výkon ve vašem vlastním datovém skladu, za který již platíte a můžete jej předvídat. Co zcela mizí, je licenční poplatek za každý přepsaný řádek účtovaný externím dodavatelem i zbytečné přepočítávání nezměněných řádků v navazujících vrstvách.