Způsobují modely v dbt nárůst účtů za výpočetní výkon ve Snowflake nebo BigQuery?
dbt spouští veškerý kód přímo uvnitř vašeho analytického skladu. Pokud jsou modely nastaveny jako kompletní přenačtení celých tabulek nebo využívají ručně psané inkrementální strategie, spotřeba kreditů stoupá s každým během. V Data Vaultu generovaném z modelu je přírůstkové nahrávání jediný způsob, jakým nahrávání vzniká.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Noční běh spolehlivě prochází, ale faktura za Snowflake nebo BigQuery roste každé čtvrtletí bez přidání jediného nového modelu.
- Mnoho modelů v repozitáři zůstává v režimu `materialized='table'`, protože správné nastavení inkrementální logiky bylo příliš komplikované.
- Zrychlení běhu se řeší zvětšením výpočetního skladu (z M na L či XL), což násobí cenu za každou běžící hodinu.
- Vývojová a testovací prostředí generují vysoké náklady tím, že při ověřování drobných změn opakovaně přepočítávají plná data.
Jedním z velkých lákadel moderního zpracování dat je přesun veškeré výpočetní kapacity přímo do cloudového datového skladu. Platformy jako Snowflake, Google BigQuery, Databricks nebo Amazon Redshift nabízejí prakticky neomezené možnosti škálování výkonu.
Tato flexibilita má však svou ekonomickou daň: pokud projekt v dbt roste bez přísného dohledu, databázový stroj naúčtuje každou sekundu spotřebovanou neefektivními dotazy.
Proč dbt může zvyšovat výpočetní náklady
- Plná přenačtení jako výchozí volba. Nejjednodušším a nejbezpečnějším nastavením v dbt je
materialized='table', které tabulku při každém běhu smaže a znovu celou vytvoří. Jakmile objem naroste do milionů řádků, cena každodenního přepočítávání začne strmě stoupat. - Složitost ručních inkrementálních modelů. Správné sestavení inkrementálního modelu vyžaduje hlídat vodoznaky, ošetřovat opožděná data a řídit slučovací operace. Z obavy před nekonzistencí týmy tuto optimalizaci často odkládají.
- Opakované vyhodnocování historie. Spojují-li modely data s pomalu se měnícími dimenzemi, často znovu a znovu procházejí celou minulost, čímž opakují práci, která již byla hotova včera.
- Skryté náklady ve vývojových větvích. Když více vývojářů spouští
dbt buildve svých pracovních větvích nad reálnými daty, spotřeba kreditů se násobí.
Nic z toho není vadou samotného dbt; je to přirozený důsledek toho, že efektivita SQL kódu leží na bedrech a časových možnostech jednotlivých vývojářů.
Řešení: automatizovaný přírůstkový design
Ve správně navrženém skladu musí spotřebovaný výpočetní výkon odpovídat objemu změn ve zdrojích, nikoli celkové historické velikosti skladu:
- Automatická detekce změn. Integrační vrstva zpracovává pouze řádky nově přidané nebo upravené od posledního běhu.
- Historizace v satelitech. Změny se zapisují do satelitů Data Vaultu bez nutnosti přepisovat či modifikovat dřívější záznamy.
- Efektivní publikace. Obchodní pohledy čtou přímo z optimalizovaného vaultu nebo plní marty pomocí řízených přírůstků.
Model Datavault Builderu
Hospodárnost výpočtů vychází v Datavault Builderu z důsledné automatizace:
- Inkrementální nahrávání už z principu. Každé generované nahrávání do hubů, linků i satelitů je ve výchozím stavu přírůstkové. Není třeba psát žádnou logiku ručně.
- Kód šitý na míru konkrétnímu databázovému stroji. Vygenerované SQL využívá mechanismy micro-partitions, clusterování a indexů ve Snowflake, Databricks či BigQuery.
- Předvídatelné a stabilní náklady. Výpočetní nároky kopírují reálnou aktivitu ve zdrojových systémech a chrání rozpočet před nečekanými výkyvy způsobenými celkovými přenačteními.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Vyhledat modely s plným přenačtením
Najděte modely materializované jako celé tabulky, které každou noc znovu zpracovávají miliony řádků nezměněných od minulého dne.
-
Standardizovat přírůstkové načítání
Zajistěte, aby každé nahrávání důsledně filtrovalo pouze skutečné delty a neprovádělo celotabulkové skeny historických dat.
-
Oddělit historizaci do satelitů
Ukládejte historii do optimalizovaných satelitů Data Vaultu, aby výstupní analytické marty četly pouze aktuální konsolidovaný stav.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Druhá strana mince dbt: Bujení kódu, skryté náklady a cesta k automatizaci
dbt přineslo do SQL modularitu a Git, čímž posunulo analytické inženýrství. S růstem projektů se však projevují limity: provozní režie Core versus poplatky za vývojáře v Cloudu, absence ingestu a záplava ručně psaných modelů. Platforma řízená modelem tuto volbu překonává.
-
Proč vás dbt nutí hledat další nástroj dříve, než můžete začít modelovat?
dbt transformuje data, která již leží ve vašem skladu. Nic ze zdrojových systémů samo neextrahuje, nepřipojuje ani nenahrává. Pro kompletní sklad potřebujete další nástroj na ingest, další na orchestraci a propojení mezi nimi. Platforma řízená modelem řeší ingest i transformaci na jednom místě.
-
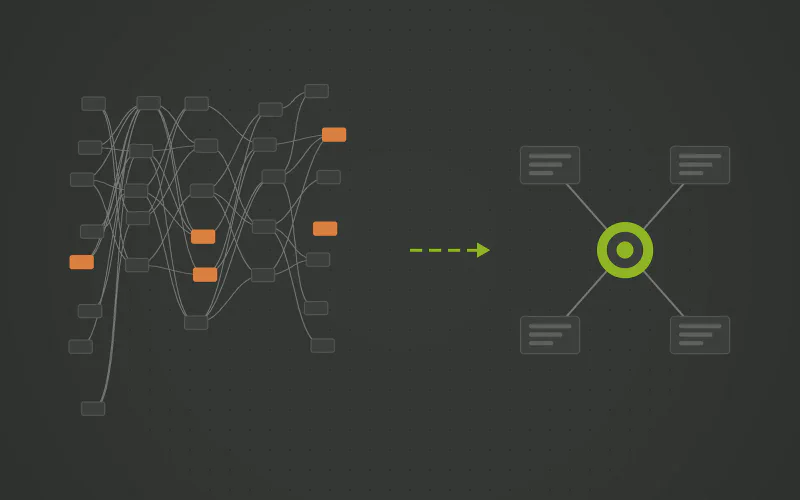
Proměnil se váš DAG v dbt v nepřehlednou síť, kterou nikdo nedokáže ladit?
Vytvořit nový model v dbt je tak snadné, že repozitáře rychle zaplní stovky SQL souborů bez jasných pravidel správy. Změna obchodního klíče výše v řetězci pak znamená dohledat každý model, který jej zdědil. Řešením je strukturovaná architektura řízená modelem s jasnými pravidly odvozování.
Otázky a odpovědi
- Protože jsou volitelné a píší se ručně pro každý model, s nutností správně definovat unikátní klíč, filtr a často i strategii slučování (merge). V praxi řada modelů zůstává v režimu plného přenačtení tabulky, protože inkrementální verze nebyla nikdy dokončena. Vygenerované nahrávání do satelitu je naproti tomu inkrementální už z principu své konstrukce.
- dbt State, představený s enginem Fusion, přeskakuje modely, jejichž vstupy se nezměnily, a dbt Labs z něj vykazuje znatelné úspory výpočetního výkonu. Rozhoduje však pouze o tom, zda se model spustí. Nemění to, co model dělá, když se spustí, takže plné přenačtení, které se aktivuje, se stále provede v plném rozsahu.
- Nahrávání představují množinové delta operace vygenerované přímo pro cílový databázový stroj. Dotýkají se pouze toho, co se skutečně změnilo, což v typické noční dávce představuje malý zlomek zdrojových dat.