Přerostlo plátno Azure Data Factory tým, který jej původně vybudoval?
Pipeline sestavená přetahováním myší vznikne rychle, ale mění se pomalu. Po překročení několika desítek aktivit se z plátna stává jediná dokumentace, vizuální vazby nahrazují obchodní logiku a každý nový zdroj znamená další aktivitu kopírování, na kterou nikdo nechce sahat. Řešením není uklizenější plátno, ale model, který pipelines generuje.
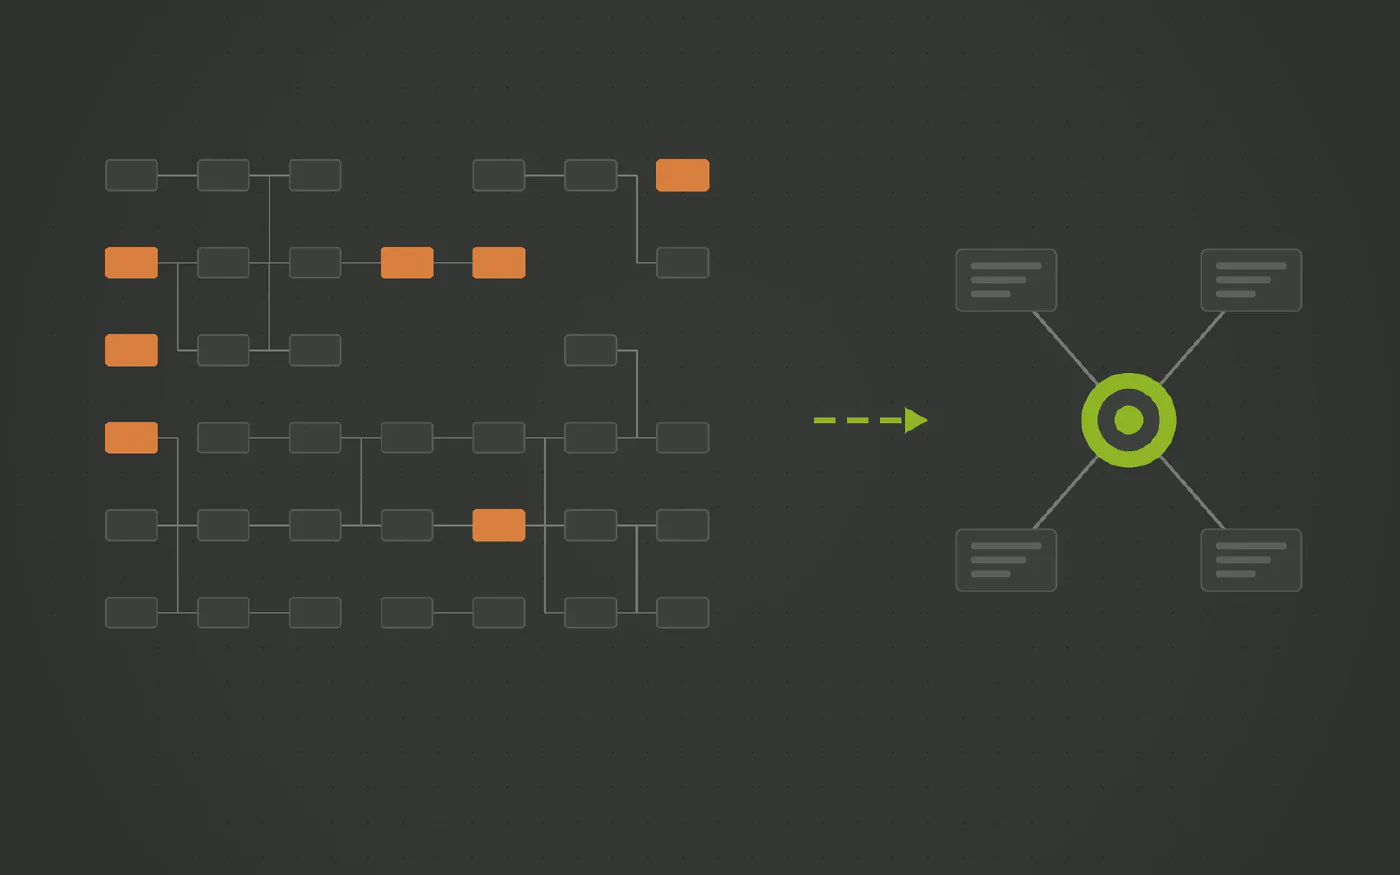
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Otevření hlavní orchestrační pipeline trvá dlouho a najít v ní konkrétní aktivitu vyžaduje neustálé posouvání a přibližování plátna.
- Drobná změna ve zdrojové tabulce znamená ručně otevřít a upravit tři pipelines a dva sdílené datasety.
- Nikdo v týmu nechce mazat staré aktivity ze strachu, že rozbije skryté závislosti v jiných částech systému.
- Přidání nového zdroje se řeší klonováním stávajících pipelines, což vede k šíření zastaralých konvencí a chyb.
Vizuální rozhraní Azure Data Factory představuje velmi přístupnou cestu k vytvoření prvních datových toků. Stačí propojit zdroj s cílem a během několika minut se data začnou přenášet. Potíže nastávají s odstupem času: jakmile sklad naroste na stovky tabulek, vizuální plátno přestává pomáhat a začíná vývoj brzdit.
Limity vývoje v grafických krabičkách
- Plátno nahrazuje dokumentaci. Protože neexistuje přehledný textový kód, jedinou možností, jak pochopit chování pipeline, je rozklikávat desítky aktivit, studovat parametry a sledovat propojovací šipky.
- Náročná manuální údržba. Přidání standardního auditního sloupce vyžaduje otevřít a ručně upravit desítky jednotlivých aktivit napříč mnoha soubory.
- Riziko skrytých vazeb. Sdílené datasety a linked services sice urychlují počáteční vývoj, ale při úpravách zakrývají, které další toky na nich závisí.
- Složité revize kódu. Porovnání změn v Gitu znamená procházet tisíce řádků generovaného JSON kódu plného grafických souřadnic namísto srozumitelného přehledu změn v obchodní logice.
Proč pouhý úklid plátna nestačí
Mnoho týmů se snaží situaci řešit tvorbou šablon, dílčích pipelines nebo dynamických frameworků řízených metadaty v databázi. Tyto snahy sice přinášejí dílčí úlevu, ale často vyústí v to, že tým tráví většinu kapacity údržbou vlastní integrační infrastruktury namísto práce na datech.
Skutečné řešení spočívá v oddělení návrhu dat od technické implementace toků. Úkolem datových inženýrů je modelovat realitu podniku; samotné technické toky, které data nahrávají, transformují a historizují, mají být vygenerovány specializovaným softwarem.
Co přináší Datavault Builder
Datavault Builder nahrazuje ruční propojování krabiček konceptuálním modelováním, které generuje veškeré nahrávací procesy pro databázový stroj automaticky:
- Vývoj soustředěný na model. Tabulky se vizuálně mapují na koncepty Data Vault 2.0 (huby, linky, satelity). Vztahy se deklarují pouze jednou.
- Jednotné generované toky. Každé nahrávání splňuje identické standardy kvality, ošetření chyb a výkonu, čímž odpadají odlišné styly jednotlivých vývojářů.
- Snadná adaptace na změny. Pokud se zdroj rozšíří o nové pole, úprava proběhne v modelu a odpovídající toky se přegenerují bez ručního zásahu do diagramů.
- Lineage a dokumentace přímo z modelu. Datová lineage vzniká z modelu, bez nutnosti ručně udržovat popisky.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Spočítat pipelines, které pouze přesouvají data
Oddělte samotný transport dat od skutečné transformace. Většina pipelines jen kopíruje řádky bez přidané analytické hodnoty.
-
Deklarovat model na jednom místě
Definujte entity a vazby vizuálně v jednom centrálním modelu, místo aby byly rozptýlené v desítkách diagramů.
-
Generovat technické toky automaticky
Nechte platformu odvodit nahrávací, historizační a publikační toky přímo z ověřeného modelu.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Úskalí Azure Data Factory: Skryté náklady vizuálních pipelines a Sparku
Azure Data Factory je dobrá transportní vrstva v rámci Azure a nevhodné místo pro uchovávání logiky datového skladu. Její nasazení v roli modelovací a transformační platformy přináší nepřehledné plátno, nasazení selhávající na ARM šablonách a clustery Sparku pro dávky, které zvládne jediný SQL příkaz. A každá z těchto pipelines existuje jen v Azure.
-
Stojí vaše Azure Data Factory Mapping Data Flows více než data, která zpracovávají?
Mapping Data Flows běží na spravovaném Spark clusteru, který startuje několik minut a účtuje se za vCore-hodinu. Pro rozsáhlou noční transformaci to dává smysl. Pro pár set tisíc řádků je to spouštění clusteru jen proto, aby vykonal to, co by v datovém skladu vyřešil jediný SQL příkaz.
-
Mění se každé nasazení Azure Data Factory v boj s ARM šablonami?
Pod vizuálním editorem je Azure Data Factory JSON: pipelines, datasety, linked services a ARM šablona, která je nasazuje. Přenesení změny z Dev do Prod znamená soubory parametrů, globální parametry a šablonu, která selže na jediné neshodě typů. Releases by měly být generovány z modelu, včetně rollbacku.
Otázky a odpovědi
- Nikoli. ADF je dobrá transportní a spouštěcí vrstva v rámci Azure. Argumentem je, že její využití jako modelovací a transformační vrstvy vytváří stovky ručně propojovaných aktivit tam, kde by měl být generovaný model.
- Odstraňuje to nutnost vytvářet kopii pipeline pro každý zdroj, což je skutečný pokrok. Vytvářejí však vlastní framework, který musíte udržovat ručně: konfigurační tabulky, generické pipelines, předávání parametrů a konvence známé pouze vašemu týmu. Navíc pokrývají pouze fázi kopírování; správa klíčů, historizace a marty zůstávají jinde. Dedikovaný generátor představuje tentýž framework, ale vyvinutý a udržovaný jako hotový produkt pro celý datový sklad.
- Datavault Builder orchestruje vlastní nahrávání: úloha spustí sadu nahrávání ve správném pořadí, s vestavěným logováním a restartem. ADF může takovou úlohu spustit a nadále přenášet soubory mezi službami Azure. Mohla by volat jednotlivá nahrávání přes API, ale není důvod znovu stavět orchestraci mimo platformu, která ji již obsahuje. V modelu popíšete obchodní význam a struktury i nahrávání se z něj vygenerují. Na plátně tak zůstane pouze přesun souborů a trigger.
- Strategickým směrem Microsoftu je Fabric a Fabric Data Factory si ponechává totožné plátno se stejnými aktivitami, smyčkami a výrazy; argument tohoto článku tedy platí bez ohledu na to, jakou Data Factory používáte. Co si neponechává, je zbytek: žádný krok publikování přes ARM, žádné Mapping Data Flows, ale Dataflow Gen2 a položky synchronizované přes Git, účtované v kapacitních jednotkách. Vygenerovaný sklad běží na Fabricu nativně v obou případech.