Převyšuje počet vašich balíčků SSIS počet lidí, kteří jim rozumí?
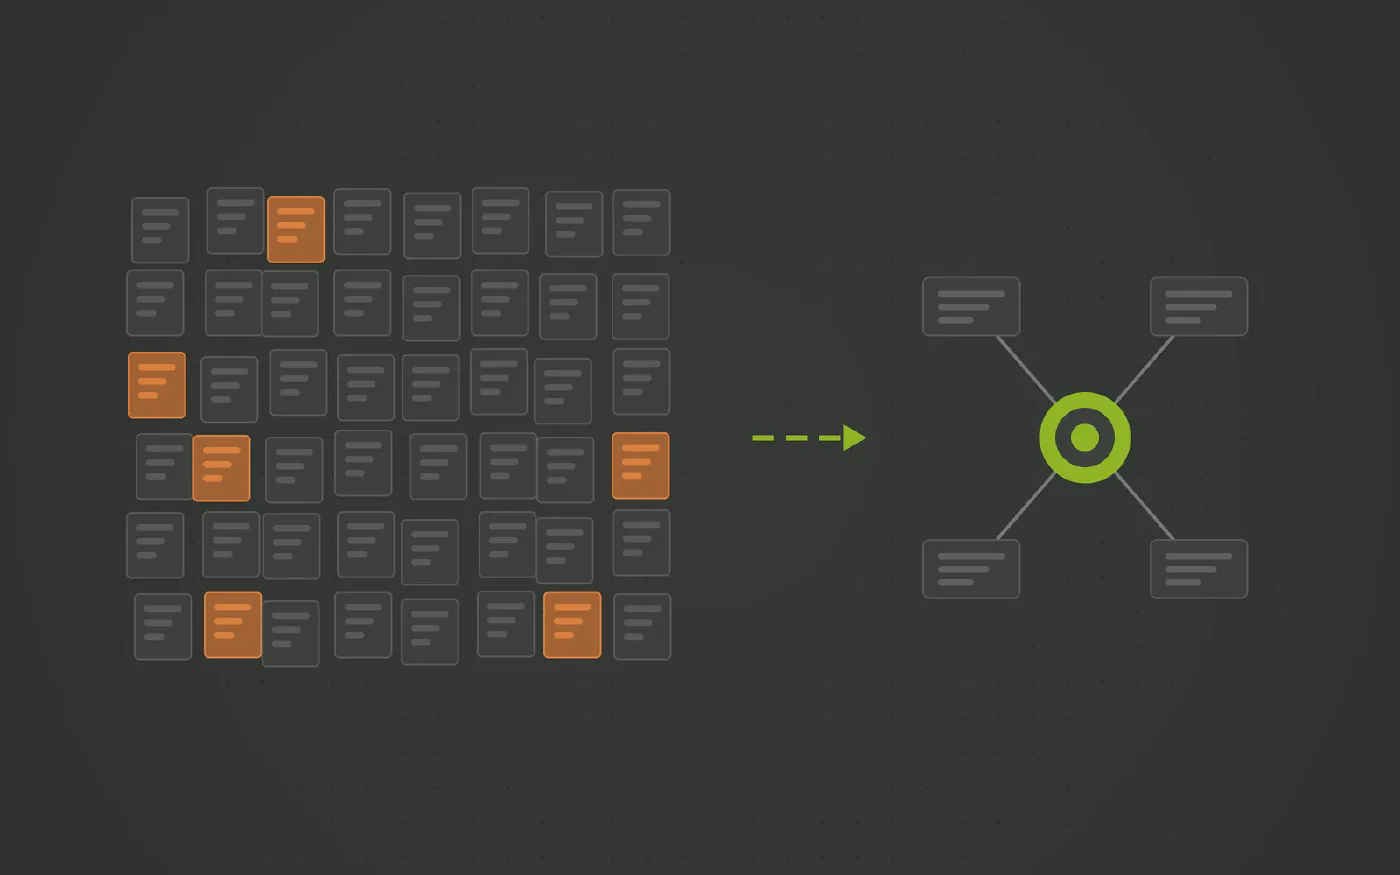
Stovky balíčků .dtsx, jeden pro každou tabulku, vytvořené ve Visual Studiu kýmkoli, kdo zrovna řešil daný úkol, s řídicími a datovými toky, jež se otevírají jen po jednom. Přidání sloupce znamená otevírat balíčky jeden po druhém. Řešením není šablona balíčku, ale model, který nahrávání generuje nativně pro SQL Server, Azure SQL nebo Fabric.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Nový sloupec ve zdroji znamená otevřít ve Visual Studiu jeden po druhém každý balíček, který danou tabulku zpracovává.
- Pro každou tabulku existuje samostatný balíček a ty, které vznikly před zavedením projektových parametrů, stále nesou vlastní připojovací řetězce.
- Nikdo si není jistý, které balíčky jsou ještě plánované v úlohách, a nikdo se neodvažuje žádný smazat, aby to zjistil.
- Doplnění auditních sloupců do skladu bylo odhadnuto na týdny práce, protože vyžaduje stejnou úpravu ve stovkách datových toků.
SSIS byl dvě desetiletí správnou odpovědí pro sklady na SQL Serveru a zralé prostředí to dokládá: stovky balíčků postavené mnoha rukama v průběhu mnoha let, z nichž každý se otevírá ve Visual Studiu samostatně. Balíčky stále běží. Problémem je jejich změna.
Proč se stávající prostředí těžko mění
- Jeden balíček na tabulku, každý postavený ručně. Stejný řídicí a datový tok sestavovaný znovu pro každý zdroj, ve stylu kohokoli, kdo daný úkol v daném týdnu řešil.
- Starší balíčky nesou vlastní konfiguraci. Projektové parametry a sdílení správci připojení existují od verze 2012; zděděné balíčky vytvořené předtím nebo bez nich stále drží připojovací řetězce a cesty uvnitř sebe.
- Změna schématu znamená okružní jízdu po balíčcích. Přidání sloupce do skladu znamená otevřít každý balíček, který se ho dotýká. Odhad je v týdnech, protože úprava se týká stovek datových toků.
- Širší sloupec znamená rozbitý datový tok. Metadata datového toku jsou typována a pevně určena v době návrhu, takže zdrojový sloupec, který se zvětší nebo změní typ, způsobí selhání komponenty, dokud jej někdo ve Visual Studiu znovu nepřemapuje.
- Nikdo přesně neví, co je v produkci živé. Balíčky jsou plánovány z SQL Agentu, z katalogu SSISDB i z jiných balíčků a nikdo nechce být tím, kdo omylem smaže ten nepravý.
Nic z toho není chybou SSIS jako takového. Balíček je dobrý způsob, jak postavit jedno nahrávání, ale špatný způsob, jak držet celý sklad.
Kam struktura patří
- Do modelu, nikoli do balíčků. Obchodní klíče, vztahy a atributy deklarované jednou, s nahráváními odvozenými z nich.
- Generovaná, aby každé nahrávání mělo jednotný tvar. Žádný individuální styl vývojáře, žádný balíček, kterému rozumí jen jeho autor.
- Na platformě, kterou již provozujete. SQL Server a Azure SQL jsou plnohodnotné cíle a Fabric je k dispozici, až nadejde čas na přesun.
Co se mění s Datavault Builderem
Datavault Builder drží datový sklad ve vizuálním modelu a generuje z něj stagingová, historizační i dodávková nahrávání, nativně pro SQL Server, Azure SQL i Fabric.
- Balíček pro každou tabulku odpadá. Huby, linky, satelity i jejich nahrávání se generují z modelu. Není nic, co by bylo třeba otevírat ve Visual Studiu.
- Změna sloupce je otázkou mapování. Namapujte jej, přegenerujte a každá závislá struktura se konzistentně aktualizuje. Chybějící sloupce se nahrávají jako null s varováním; rozšiřující se sloupce se rozšíří.
- Každé nahrávání má stejnou podobu. Píše je generátor, takže nedochází k odchylkám ve stylu a nevzniká žádný balíček, kterému rozumí jen jeho tvůrce.
- Model je zároveň inventářem. Co se nahrává, odkud, kam a s jakou návazností (lineage), je viditelné na jednom místě. Žádné pátrání v úlohách SQL Agentu.
- Nic nemusí opustit SQL Server. Vygenerovaný sklad běží tam, kde běžely balíčky, a přechod na Fabric je pouze změnou cíle, jakmile se pro něj rozhodnete.
Jak rozhodnout
Proveďte audit svého balíčkového prostředí a spočítejte balíčky, které existují pouze proto, aby načetly jednu tabulku ze zdroje do stagingu nebo do skladu. Tento počet odpovídá velikosti vrstvy, kterou by měl generovat model. Seřazený podle zdrojů vám tentýž seznam dá přesné pořadí, v jakém můžete balíčky postupně vyřazovat.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Spočítat balíčky, které pouze načítají tabulku
Většinu zralého prostředí SSIS tvoří jeden balíček na zdrojovou tabulku dělající stále totéž. To je struktura, nikoli logika.
-
Místo toho modelovat zdroje
Obchodní klíče, vztahy a atributy se zadávají do modelu Datavault Builderu. Nahrávání se generují nativně pro SQL Server, Azure SQL nebo Fabric.
-
Vyřazovat balíčky podle mapování
Každý zdroj namapovaný v modelu představuje balíček, který již není třeba otevírat. Balíčkový park se zmenšuje s tím, jak model roste.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
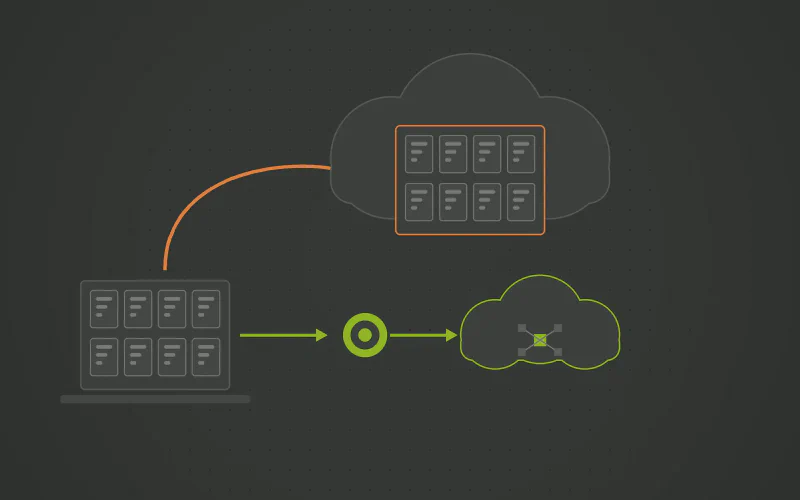
Uvažujete o přesunu svých balíčků SSIS do cloudu metodou lift-and-shift?
Starší projekty v SSIS s sebou nesou tři neduhy, které cloudový virtuální server nevyřeší: balíček pro každou tabulku, na který se nikdo neodvažuje sáhnout, nasazování mimo DevOps a architekturu svázanou s SQL Serverem. Azure-SSIS Integration Runtime přenáší všechny tři do cloudu beze změny. Model, který sklad generuje, je učiní zbytečnými.
-
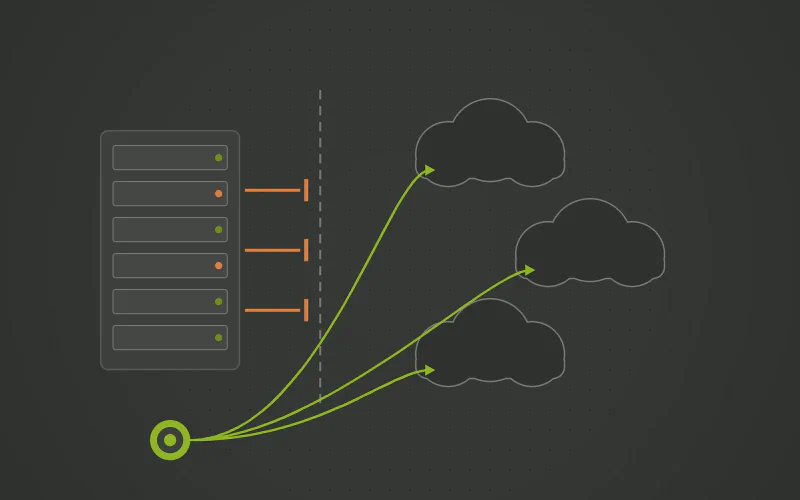
Provozujete stále SSIS na licencovaném SQL Serveru jen proto, abyste plnili Snowflake či cloud?
SQL Server Integration Services (SSIS) vznikly pro lokální ekosystém Microsoftu. Jejich použití pro plnění moderních cloudových skladů, jako jsou Snowflake, Databricks nebo Fabric, vyžaduje vyhrazené servery, konektory třetích stran a zbytečné licence pro SQL Server. Řešením je generovat nahrávání nativně přímo v cílovém databázovém stroji.
-
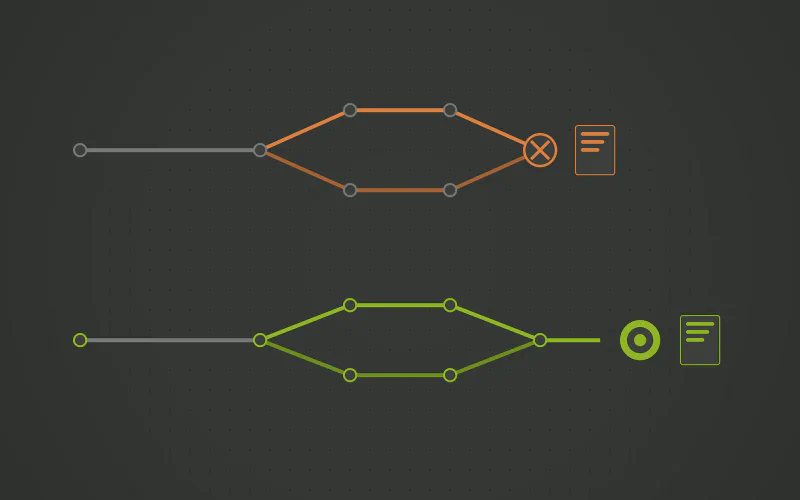
Je SSIS jedinou součástí vašeho technologického stacku, která stále nezvládá CI/CD?
Soubor .dtsx je kód XML, který se v Gitu špatně porovnává a ještě hůř slučuje; pokud dva inženýři upraví stejný balíček, obvykle to končí jeho ruční přestavbou. Prostředí závisejí na ručně udržovaných proměnných v SSISDB. Releases by měly vznikat z modelu, pro každé prostředí zvlášť, včetně rollbacku.
Otázky a odpovědi
- Nikoli. Datavault Builder generuje datový sklad nativně pro SQL Server i Azure SQL a pro Fabric, až se pro něj rozhodnete. ETL se modernizuje, aniž by se musela měnit samotná platforma.
- Odstraňuje to nutnost ručního kreslení, což je skutečný pokrok. Co však zůstává, je samotný balíčkový park: BIML produkuje balíčky .dtsx, takže jich máte stále stovky k nasazení, plánování, slučování a spouštění na serveru SSIS. Rozdíl spočívá v generování množinových nahrávání přímo uvnitř databáze z modelu, takže balíčky vůbec nepotřebujete.
- Běží dál, dokud není jejich zdroj namapován v modelu, a teprve poté jsou vyřazeny. Nejde o žádný skokový přechod (big bang); prostředí se zmenšuje mapování po mapování.
- Obchodní pravidla se přesouvají do business vaultu, kde jsou verzována a viditelná přímo v modelu. Ladelogika, která tvoří většinu typického balíčku, se generuje a už nikdy nepíše ručně.