Provozujete stále SSIS na licencovaném SQL Serveru jen proto, abyste plnili Snowflake či cloud?
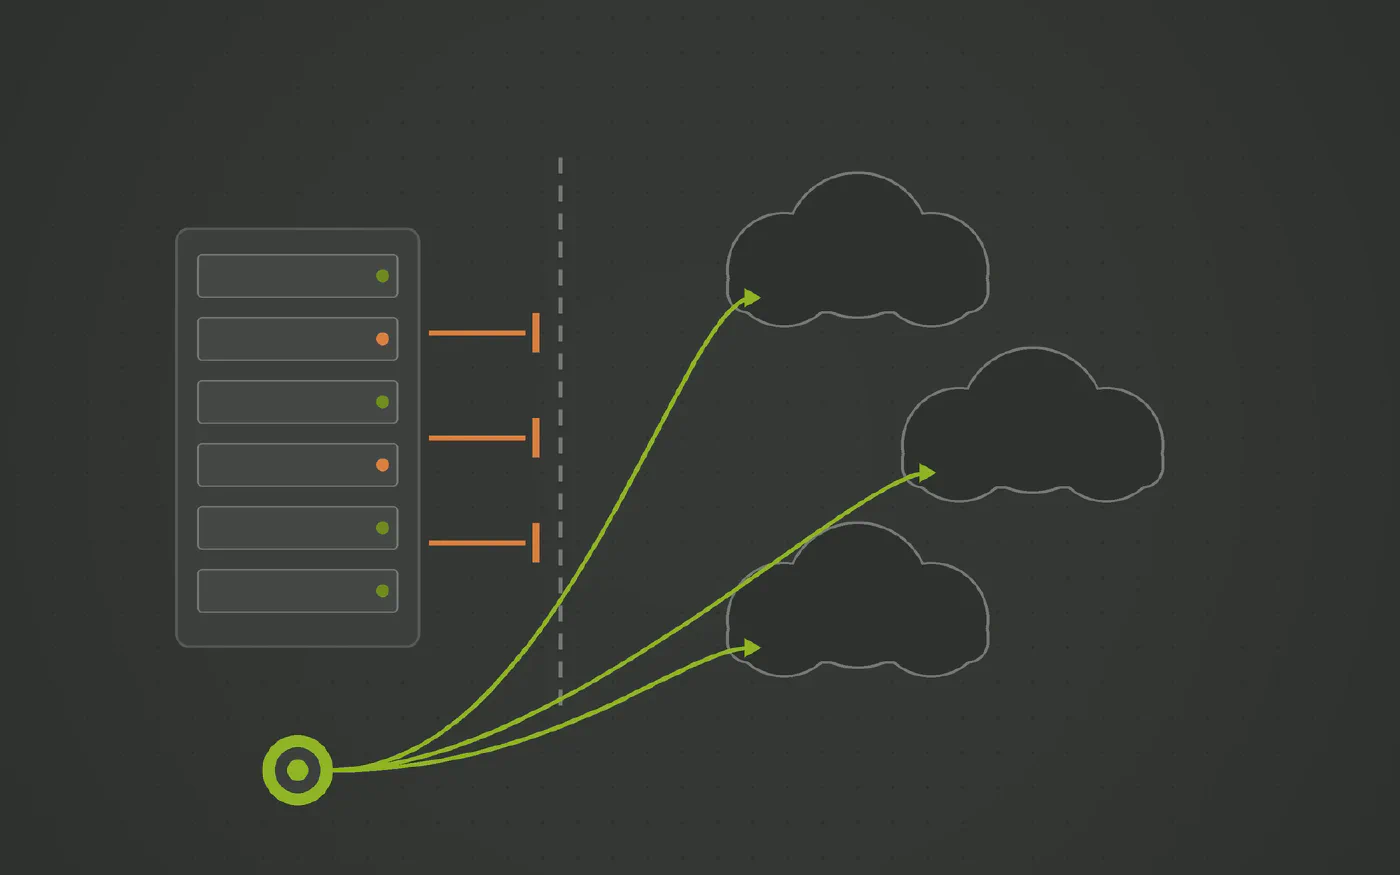
SQL Server Integration Services (SSIS) vznikly pro lokální ekosystém Microsoftu. Jejich použití pro plnění moderních cloudových skladů, jako jsou Snowflake, Databricks nebo Fabric, vyžaduje vyhrazené servery, konektory třetích stran a zbytečné licence pro SQL Server. Řešením je generovat nahrávání nativně přímo v cílovém databázovém stroji.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Nahrávání zdrojů mimo ekosystém Microsoftu vyžaduje pořizovat a spravovat ovladače ODBC/OLE DB třetích stran s vlastními licencemi a aktualizacemi.
- Integrační server vyžaduje vlastní licenci SQL Serveru pro zátěž, která sama o sobě žádná data neukládá.
- Transformace probíhají v paměti serveru SSIS před odesláním do cloudu, což vytváří úzké hrdlo na síti a brzdí propustnost.
- Celá organizace přechází na Snowflake, Databricks nebo Fabric, ale datová vrstva zůstává svázána s technologiemi z minulých dekád.
SQL Server Integration Services (SSIS) byly ve své době mimořádně úspěšným řešením pro lokální datové sklady postavené na Microsoft SQL Serveru. Byly optimalizovány pro přenosy dat prostřednictvím vyrovnávací paměti na stejném databázovém serveru.
Dnešní realita je však odlišná: moderní organizace ukládají a analyzují svá data v cloudových analytických platformách, jako jsou Snowflake, Databricks, BigQuery nebo Microsoft Fabric.
Proč SSIS v éře cloudu naráží na své meze
- Integrační server funguje jako zbytečná brzda. SSIS vytáhne řádky ze zdroje, přenese je do paměti mezilehlého serveru k provedení transformací (třídění, vyhledávání, odvozování) a následně je po síti pošle do cloudu. Tento klasický přístup ETL plýtvá šířkou pásma a ignoruje výpočetní možnosti moderních skladů.
- Licenční a provozní zátěž. SSIS vyžaduje pro svůj běh licencovanou instanci SQL Serveru. Provozovat vyhrazený server pouze pro spouštění balíčků znamená platit licence, instalovat záplaty a spravovat operační systém bez přímé analytické hodnoty.
- Křehkost při napojení na platformy mimo ekosystém Microsoftu. Propojení SSIS s moderními zdroji nebo cloudovými sklady vyžaduje instalaci externích ovladačů ODBC či doplňků třetích stran, což komplikuje dlouhodobou podporu a aktualizace.
Od paměťového ETL k nativnímu ELT
Moderní architektura zpracování dat se mezilehlých serverů zbavuje:
- Přímé uložení (Extract & Load). Surová data se uloží do stagingu přímo v datovém skladu nebo v cloudovém objektovém úložišti (ADLS, S3).
- Transformace až v cílové databázi (Transform). Integrace, deduplikace, historizace i tvorba martů se provádí přímo v databázovém stroji pomocí vysoce paralelizovaných množinových SQL příkazů.
- Odpadá mezilehlá vrstva. Žádné servery pro spouštění balíčků, žádné paměťové limity a žádné zbytečné licence pro SQL Server.
Modernizace s Datavault Builderem
Datavault Builder nabízí přímou cestu k překonání limitů SSIS:
- Plně nativní push-down exekuce. Vygenerovaný kód běží přímo v cílové platformě: ve Snowflake, Databricks, Fabricu, Azure SQL nebo PostgreSQL.
- Konec mezilehlých transformačních serverů. Zbavte se infrastruktury SSIS i souvisejících nákladů na licence.
- Svoboda volby technologie. Rozhodne-li se vaše firma přejít z lokálního SQL Serveru na Snowflake či Fabric, datový model zůstává zachován; Datavault Builder pouze začne generovat kód přizpůsobený novému cílovému prostředí.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Zhodnotit závislost na serveru SSIS
Spočítejte prostředky a licence vázané výhradně na běh SSIS a prověřte, kolik toků končí v moderních cloudových cílech.
-
Nahradit paměťové ETL nativním ELT
Nahrajte data přímo do cílového úložiště a využijte výpočetní sílu moderního databázového stroje.
-
Generovat sklad z nezávislého modelu
Modelujte logiku v platformě, která vygeneruje nativní kód pro databázový stroj, jaký si vaše firma zvolí dnes i v budoucnu.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
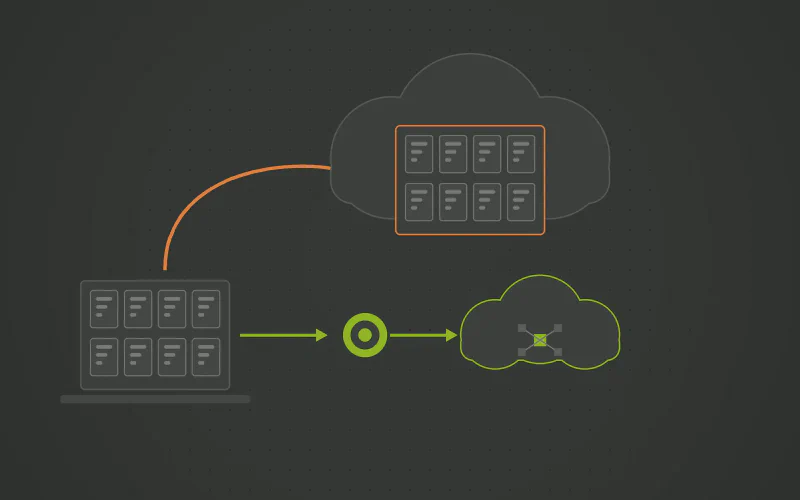
Uvažujete o přesunu svých balíčků SSIS do cloudu metodou lift-and-shift?
Starší projekty v SSIS s sebou nesou tři neduhy, které cloudový virtuální server nevyřeší: balíček pro každou tabulku, na který se nikdo neodvažuje sáhnout, nasazování mimo DevOps a architekturu svázanou s SQL Serverem. Azure-SSIS Integration Runtime přenáší všechny tři do cloudu beze změny. Model, který sklad generuje, je učiní zbytečnými.
-
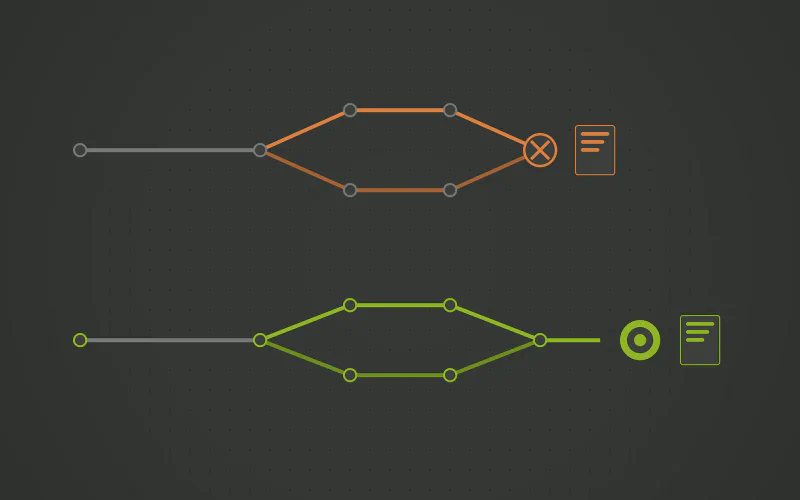
Je SSIS jedinou součástí vašeho technologického stacku, která stále nezvládá CI/CD?
Soubor .dtsx je kód XML, který se v Gitu špatně porovnává a ještě hůř slučuje; pokud dva inženýři upraví stejný balíček, obvykle to končí jeho ruční přestavbou. Prostředí závisejí na ručně udržovaných proměnných v SSISDB. Releases by měly vznikat z modelu, pro každé prostředí zvlášť, včetně rollbacku.
-
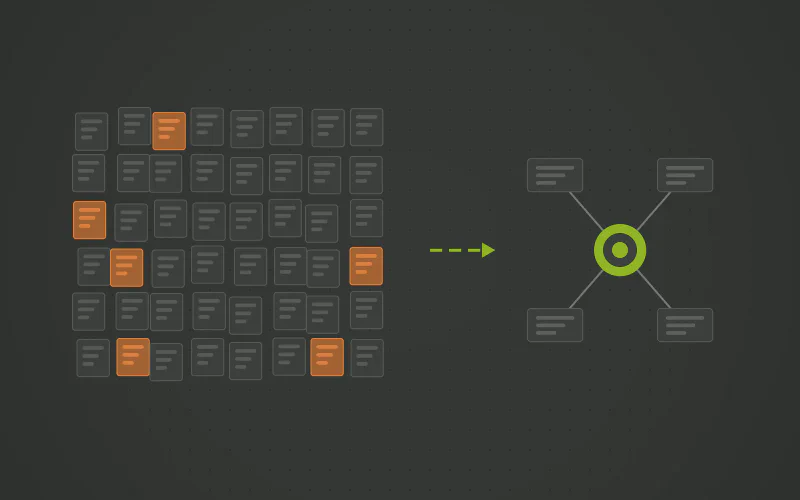
Převyšuje počet vašich balíčků SSIS počet lidí, kteří jim rozumí?
Stovky balíčků .dtsx, jeden pro každou tabulku, vytvořené ve Visual Studiu kýmkoli, kdo zrovna řešil daný úkol, s řídicími a datovými toky, jež se otevírají jen po jednom. Přidání sloupce znamená otevírat balíčky jeden po druhém. Řešením není šablona balíčku, ale model, který nahrávání generuje nativně pro SQL Server, Azure SQL nebo Fabric.
Otázky a odpovědi
- Spouští stávající balíčky v Azure beze změn, což znamená pouhé přestěhování problému do cloudu namísto jeho vyřešení: model jednoho balíčku pro každou tabulku, paměťové buffery i nesourodé konektory přetrvávají. Představuje dočasný most, zatímco strategický směr Microsoftu míří k Fabric Data Factory nebo k moderním architekturám řízeným modelem.
- Generuje nativní množinový SQL kód pro Snowflake, Databricks, Google BigQuery, Microsoft Fabric, Azure Synapse, Azure SQL, PostgreSQL, Oracle i SQL Server bez potřeby jakýchkoli mezilehlých transformačních serverů.
- Pak vygenerovaný datový sklad běží na SQL Serveru nebo Azure SQL a modernizace se týká samotného ETL, nikoli databázové platformy. Případný pozdější přechod na Fabric je pak pouhou změnou cíle.