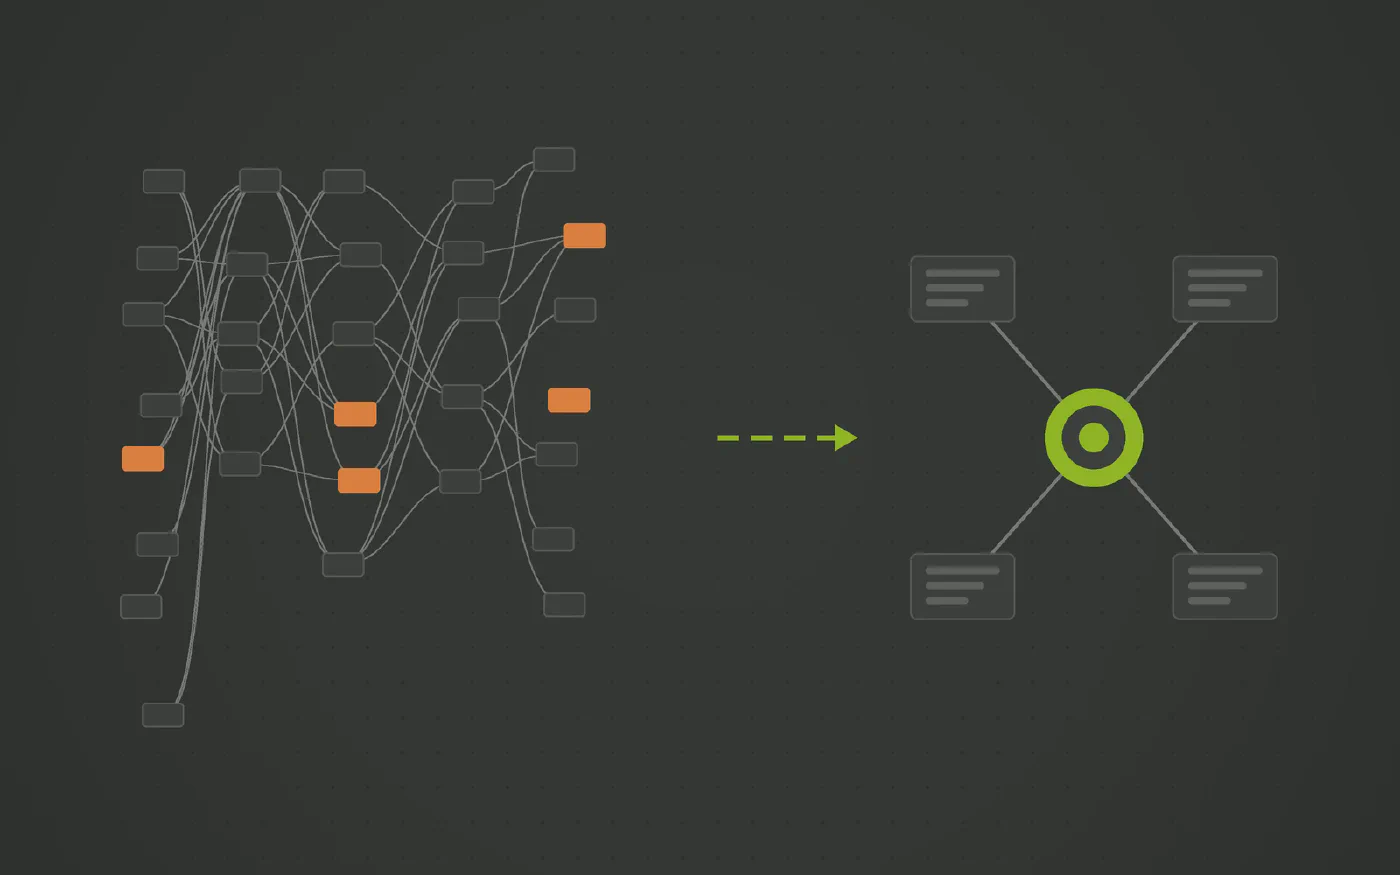
Proměnil se váš DAG v dbt v nepřehlednou síť, kterou nikdo nedokáže ladit?
Vytvořit nový model v dbt je tak snadné, že repozitáře rychle zaplní stovky SQL souborů bez jasných pravidel správy. Změna obchodního klíče výše v řetězci pak znamená dohledat každý model, který jej zdědil. Řešením je strukturovaná architektura řízená modelem s jasnými pravidly odvozování.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Graf závislostí (DAG) v dbt obsahuje stovky uzlů a nikdo v týmu nedokáže s jistotou předpovědět dopad úpravy základního modelu.
- V repozitáři existuje množství podobných mezilehlých modelů (`stg_orders_v2`, `int_orders_cleaned`), vytvořených pro jednorázové účely.
- Čas kompilace a běhu projektu neustále narůstá, což nutí vývojáře používat složité filtry a selektory při lokálním testování.
- Lineage ukazuje mezilehlé tabulky, které žádný report nečte, ale nikdo se je neodvažuje smazat.
Rychlost a jednoduchost, s jakou lze v dbt přidat nový model, je jeho hlavní předností a
současně příčinou dlouhodobých potíží. Vytvoření jediného souboru .sql s dotazem
select * from {{ ref('...') }} okamžitě zavede nový uzel do grafu závislostí.
Po dvou letech vývoje a obvyklé obměně lidí v týmu se projekt nezřídka ocitne v nepřehledném stavu: rozsáhlý graf se stovkami propojených modelů, kde jakákoli změna vyžaduje opatrnost, aby nerozbila produkční výstupy.
Jak dochází k nekontrolovanému bujení
- Absence strukturálních omezení. dbt nepředepisuje žádnou konkrétní metodiku datového modelování; jde o flexibilní kompilátor SQL šablon. Celková architektura tak závisí výhradně na osobní disciplíně jednotlivých vývojářů.
- Vznik ad-hoc mezivrstev. Když analytik potřebuje přidat sloupec nebo specifický filtr, bývá rychlejší vytvořit novou mezilehlou tabulku než bezpečně upravit stávající sdílený model.
- Roztříštěná obchodní logika. Pravidla výpočtů bývají rozptýlena napříč mnoha vrstvami (kousek ve stagingu, spojení v mezilehlém modelu a filtr v martu), což audit a ověřování čísel ztěžuje.
- Rostoucí náklady na databázi. Každý mezilehlý materializovaný model spotřebovává diskový prostor a výpočetní kredity při každém nočním spuštění.
Alternativa: deterministická architektura řízená modelem
Odolný podnikový datový sklad vyžaduje jasná a neměnná pravidla návrhu:
- Důsledné oddělení integrace od prezentace. Integrační vrstva (Data Vault) uchovává historická data v maximálním detailu, uspořádaná podle klíčových konceptů podniku.
- Předvídatelná derivace. Tabulky stagingu, linky i satelity vznikají podle jednotného vzoru odvozeného přímo z definice entit.
- Nezávislé marty pro spotřebu. Analytické dashboardy a datové produkty čtou z optimalizovaného vaultu nebo přehledných dimenzionálních struktur bez vzájemného křížení závislostí.
Výhody s Datavault Builderem
Datavault Builder eliminuje chaos v modelech prostřednictvím důsledné automatizace:
- Standardizovaná struktura od základu. Každý údaj má přesně definované místo v rámci Data Vault 2.0. Odpadají spory o to, kam zařadit konkrétní transformaci.
- Snadná správa a rozvoj. Vizuální model věrně odráží fungování vašeho podniku. Při změně entity se upraví model a veškerý kód se přegeneruje.
- Automatická lineage i dokumentace. Není třeba ručně udržovat soubory YAML s popisy; veškerá návaznost dat je inherentní součástí platformy.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Zmapovat osiřelé modely
Identifikujte modely v repozitáři, které nemají žádné navazující závislosti a nenapájejí žádný aktivní dashboard ani datový produkt.
-
Zavést striktní vrstvení
Omezte transformace na jasně vymezené vrstvy: surový staging, integrační model (Data Vault) a marty pro dodávku dat.
-
Generovat architekturu z modelu
Využijte nástroj, který odvozuje mezilehlé struktury systematicky, místo aby každý vývojář vymýšlel vlastní hierarchii.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Druhá strana mince dbt: Bujení kódu, skryté náklady a cesta k automatizaci
dbt přineslo do SQL modularitu a Git, čímž posunulo analytické inženýrství. S růstem projektů se však projevují limity: provozní režie Core versus poplatky za vývojáře v Cloudu, absence ingestu a záplava ručně psaných modelů. Platforma řízená modelem tuto volbu překonává.
-
Proč vás dbt nutí hledat další nástroj dříve, než můžete začít modelovat?
dbt transformuje data, která již leží ve vašem skladu. Nic ze zdrojových systémů samo neextrahuje, nepřipojuje ani nenahrává. Pro kompletní sklad potřebujete další nástroj na ingest, další na orchestraci a propojení mezi nimi. Platforma řízená modelem řeší ingest i transformaci na jednom místě.
-
Způsobují modely v dbt nárůst účtů za výpočetní výkon ve Snowflake nebo BigQuery?
dbt spouští veškerý kód přímo uvnitř vašeho analytického skladu. Pokud jsou modely nastaveny jako kompletní přenačtení celých tabulek nebo využívají ručně psané inkrementální strategie, spotřeba kreditů stoupá s každým během. V Data Vaultu generovaném z modelu je přírůstkové nahrávání jediný způsob, jakým nahrávání vzniká.
Otázky a odpovědi
- AutomateDV generuje SQL pro huby, linky a satelity z maker, která konfigurujete pro jednotlivé modely, což je oproti ručnímu psaní pokrok. Ponechává však na vás staging vrstvu, metadata každého volání makra, pořadí orchestrace i řízení historických změn ve zdroji. V Datavault Builderu jsou tyto prvky odvozeny z jediného vizuálního modelu a aktualizují se při jeho úpravě, přičemž samotný model slouží jako živá dokumentace. K dispozici je navíc přímá migrační cesta: Migration Vault umožňuje namapovat existující metadata projektu AutomateDV a vygenerovat z nich odpovídající balíček pro nasazení.
- Důslednou a automatizovanou aplikací metodiky Data Vault 2.0. Data vždy procházejí předvídatelnou trasou: Staging → Huby/Linky/Satelity → Obchodní vrstva a marty. V architektuře není prostor pro svévolné mezilehlé vrstvy vymýšlené za běhu.
- Ano, dvěma způsoby. Vygenerovaný vault i marty jsou standardní tabulky a pohledy, takže stávající modely v dbt z nich mohou číst. A pokud chcete nadále řídit provoz přes dbt, Datavault Builder generuje modely dbt přímo ze svého vlastního modelu, takže se bujení kódu nevrátí: změna se provede v modelu a projekt dbt se znovu vygeneruje.