Je váš Power BI report v DirectQuery pomalý při každém kliknutí?
DirectQuery a Direct Lake slibují živá data. Dostanete třicetisekundový vizuál a účet za výpočetní výkon, který nikdo nechce vysvětlovat. Problém není v režimu. Je ve schématu pod ním.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory
Zní vám to povědomě?
- Každé kliknutí na filtr pošle novou vlnu dotazů a vizuály se jen vlečou.
- Náklady na výpočetní výkon Synapse nebo Fabric vyskočily v měsíci, kdy se dashboard spustil.
- Direct Lake přepíná zpět na DirectQuery a nikdo vám přesně neřekne proč.
- Stejný report je v režimu import rychlý, takže používáte import a přicházíte o živá data.
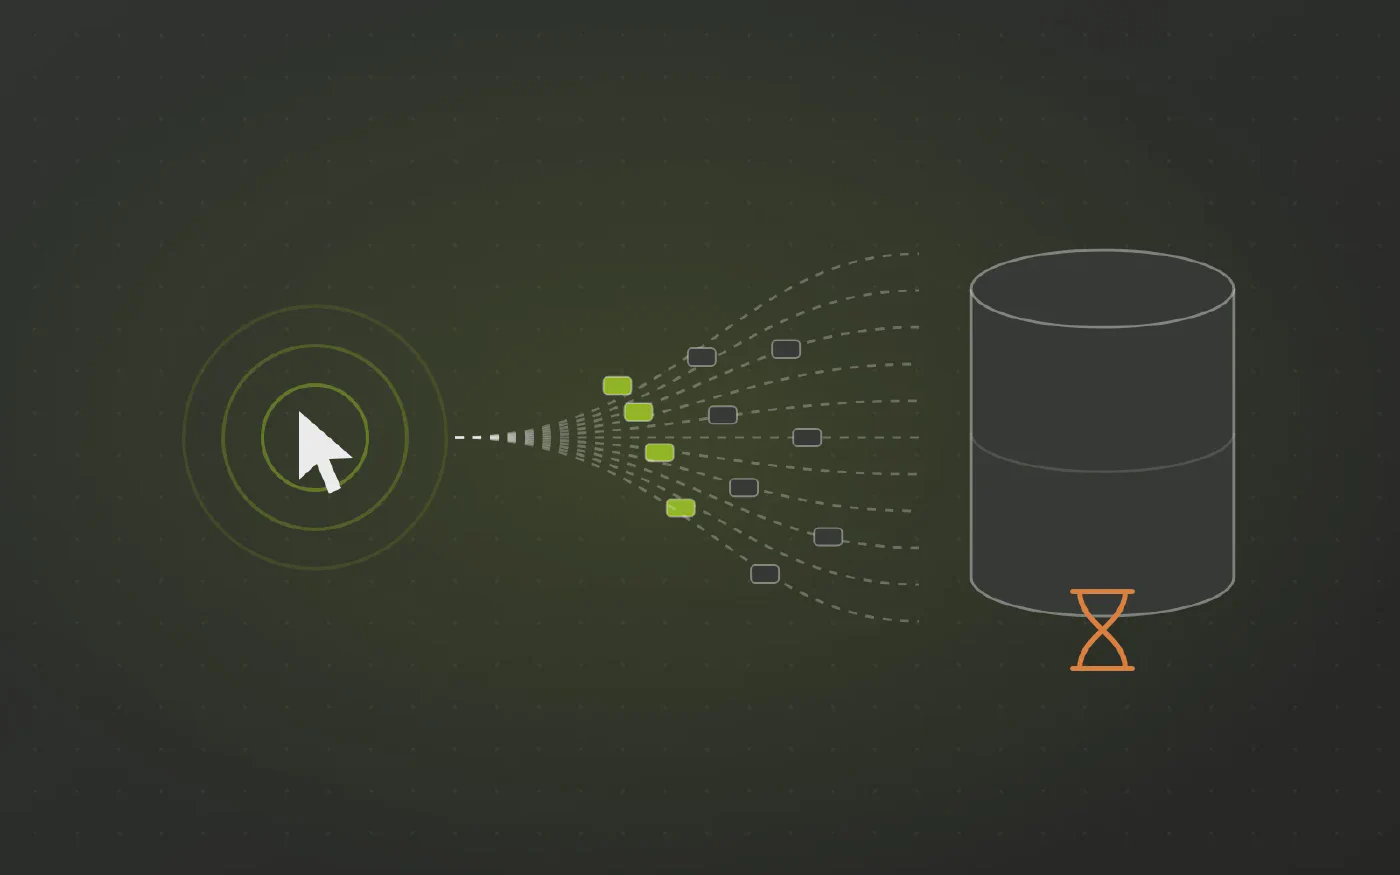
DirectQuery dělá přesně to, co slibuje: každou interakci převede na SQL proti vaší databázi. Jestli je odezva rychlá, závisí výhradně na struktuře a optimalizaci databáze, na kterou dotaz směřuje.
Co DirectQuery generuje
- Proti star schema (hvězdicovému schématu): jedna tabulka faktů, pár joinů na dimenze přes skutečné surrogátní klíče. Databáze odpoví v milisekundách.
- Proti 3NF nebo surovým tabulkám v data lake: hluboce vnořené joiny přes tucet tabulek, skládané znovu pro každý vizuál a každé kliknutí.
- Chybí možnost efektivního pushdownu. Tabulky bez partitioningu a bez indexů znamenají pokaždé celotabulkový scan (full scan).
- Zpětný přechod (fallback) probíhá skrytě. Direct Lake se potichu vrátí k DirectQuery, když zdroj nemá potřebnou dimenzionální strukturu, a právě tehdy se prudce zvednou náklady.
Vynásobte to počtem vizuálů na stránce a pak počtem souběžných uživatelů. To je ten účet.
Proč to dopadá na vás
- Datový sklad zpřístupnil, co měl, tedy provozní tabulky, ne analytické.
- Obejít to jde režimem import, a ten vás stojí živá data, kvůli kterým jste DirectQuery zvolili.
- Vizuály vyladit můžete. Partitionování zdroje změnit nemůžete.
Práce se dělá na špatném místě
- Strukturovat a optimalizovat tabulky pro analýzu patří do datového skladu. DirectQuery to suplovat neumí, takže se nevhodná struktura dat tvrdě platí při každém kliknutí.
- Patří na jedno centrální místo: do datového skladu nebo data hubu, který se postaví jednou a čte z něj každý report.
- Pokud to zní draze, odhad nejspíš počítá s tím, že se datové pipeline budou stavět ručně. Specializovaná automatizační platforma je generuje z modelu, a to mění náklady i čas, který to zabere.
Co se změní, když model přijde hotový
Datavault Builder generuje dimenzionální modely nativně na cílové platformě, materializované nebo virtualizované, stavěné pro analytický pushdown, ne pro transakční přístup.
- Jedna tabulka faktů, skutečné dimenze. Vygenerované SQL je krátké už ze své podstaty.
- Partitionované a clusterované podle sloupců, podle kterých lidé skutečně filtrují.
- Direct Lake zůstane v Direct Lake, protože tabulky již mají přesně tu strukturu, kterou vyžaduje.
- Výpočetní náklady klesnou, protože každé kliknutí prochází štíhlý model místo surové vrstvy.
- Živá data už nemusíte vyměňovat za rychlost.
O co požádat
“DirectQuery při každém kliknutí provádí joiny nad normalizovanými tabulkami, takže výpočetní náklady rostou s počtem uživatelů. Můžeme pro tento report zpřístupnit partitionované star schema, na které se bude dotazovat místo nich?”
Dost konkrétní na to, aby se to dalo naplánovat, a míří na vrstvu, kam oprava patří.
Podívejte se, jak to funguje na vašich vlastních datech
Rezervujte si bezplatné demo a přineste report, se kterým máte největší potíže.
Tři kroky k číslům, která sedí
-
Vytáhněte stávající logiku
Posbírejte výpočty, joiny a filtry, které dnes vězí ve vašich reportech.
-
Centralizujte ji na jednom místě
Logika se jednou přesune do modelu datového skladu, takže každý report čte stejnou definici.
-
Čísla, která sedí
Každý report ukazuje stejné číslo a “odkud se tohle číslo vzalo” má viditelnou odpověď.
Jak Datavault Builder předá vašemu reportu hotový model
-
Model přijde hotový
Datavault Builder generuje vault a star schema tak, aby běžely nativně v databázi, kterou už máte: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks nebo BigQuery.
-
Práce opustí report
Žádný merge, žádné parsování, žádný fuzzy match. Tato práce z reportu zmizela.
-
Zdroje přicházejí integrované
Zákazníci z ERP, CRM a e-shopu se spárují do jedné sady konformních dimenzí. Join proběhne jednou v datovém skladu, ne znovu v každém reportu.
-
Historie, na kterou se lze dotázat
Každá změna se uchová tak, jak přijde, takže můžete reportovat stav tehdy i stav nyní, i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Každé číslo má lineage
Logika získá lineage, takže otázka “odkud se tohle číslo vzalo” má viditelnou odpověď.
-
Změny řešené v datovém skladu
Pomalu se měnící dimenze se řeší přímo v datovém skladu jako vault satelity, místo aby se jen aproximovaly.
Příběh zákazníka: Porta
Oceněno společností BARC v The Data Fabric Survey 26
Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí do vaší situace.
Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Ukazují vaše Power BI reporty pro stejný ukazatel různá čísla?
Finance, Obchod i Provoz si každý postavili vlastní sémantický model a každý z nich je vnitřně konzistentní. Definice nebyly špatně na jednom místě. Nebyly dohodnuté nikde.
-
Je váš DAX kód v Power BI už příliš složitý na údržbu?
Dvě stě řádků CALCULATE a FILTER není známka pokročilého DAX. Obvykle je to známka toho, že vám datový sklad nikdy nedal klíče, historii ani granularitu, kterou jste potřebovali.
-
Selhává vám refresh v Power BI každou noc?
Naplánovaný refresh skončí timeoutem, Power Query dojde paměť a vy se to dozvíte, až když někdo otevře dashboard. Příčinou téměř nikdy není Power BI. Je to práce, kterou po Power BI chcete.