Proč vás dbt nutí hledat další nástroj dříve, než můžete začít modelovat?
dbt transformuje data, která již leží ve vašem skladu. Nic ze zdrojových systémů samo neextrahuje, nepřipojuje ani nenahrává. Pro kompletní sklad potřebujete další nástroj na ingest, další na orchestraci a propojení mezi nimi. Platforma řízená modelem řeší ingest i transformaci na jednom místě.
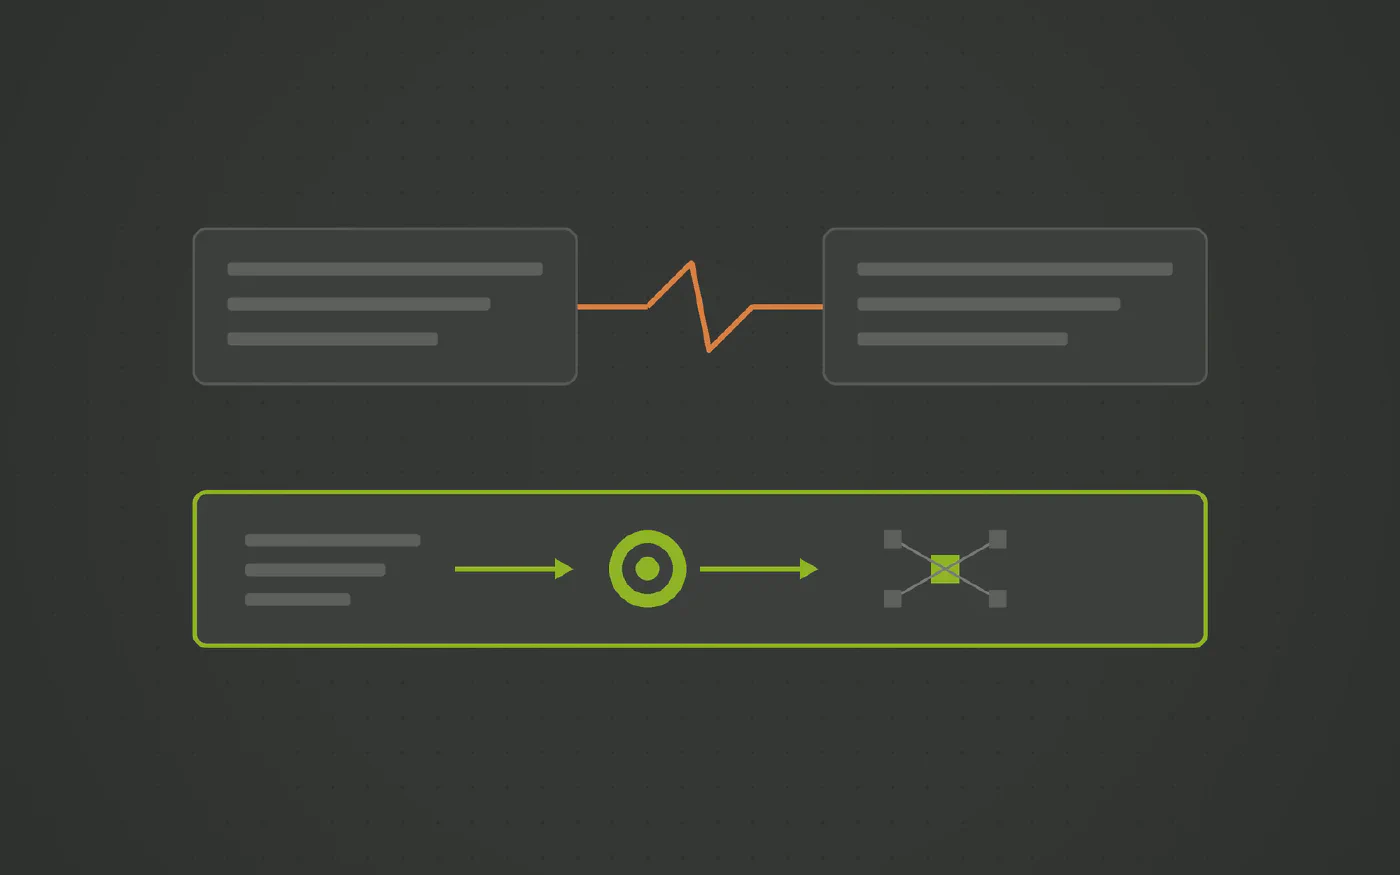
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Projekt v dbt je připraven, ale nemůže začít pracovat, dokud jiný tým nenastaví konektory ve Fivetranu nebo Airbytu.
- Při nočním selhání je chybový záznam rozdělen mezi rozhraní nástroje pro ingest a transformační prostředí dbt.
- Změna schématu ve zdrojové databázi shodí nahrávání, aniž by dbt mělo o události jakékoli povědomí.
- Organizace hradí dvě nezávislé licence na software pro proces, který je z pohledu dat jediným souvislým tokem.
dbt se stalo respektovaným standardem v moderní datové komunitě z velmi dobrých důvodů: přineslo osvědčené principy softwarového inženýrství (verzování, modularitu, testy) do světa SQL dotazů. Řeší však výhradně písmeno T v moderním konceptu ELT.
Prázdné místo před transformací
Aby dbt mohlo spustit byť jediný model, data se již musí nacházet uvnitř datového skladu. Každý projekt postavený na dbt tak nutně vyžaduje:
- Samostatný nástroj či konektor pro extrakci a nahrání dat (Fivetran, Airbyte nebo vlastní skripty).
- Synchronizační mechanismus, který řídí, kdy končí ingest a kdy začíná transformace.
- Oddělené monitorování, logy a notifikace pro každou část skládačky.
Toto umělé rozdělení přináší datovým týmům každodenní komplikace:
- Neschopnost reagovat na změny schémat. Pokud zdrojový systém přidá sloupec nebo změní datový typ, externí konektor buď selže, nebo nová data tiše ignoruje. Modely v dbt o změně nevědí a reporty zobrazují neúplné údaje.
- Dvojí výpočetní náklady. Řada konektorů pro jistotu přenáší plná data do stagingu, což nutí modely v dbt provádět náročné celotabulkové skeny, aby zjistily, co je skutečně nové.
- Přerušená lineage. Sledovatelnost dat končí na hranici vstupní tabulky. V dbt vidíte, co se děje v databázi, ale ztrácíte přehled o původních podmínkách extrakce v transakčním systému.
Co mění integrované řešení
Pokud jsou ingest i modelování řízeny jednou automatizovanou platformou:
- Ingest rozumí cílovému modelu. Extrakce nekončí u pouhého uložení surových tabulek; plní přímo struktury stagingu navržené pro nahrání do Data Vaultu.
- Detekce změn ve zdroji. Přidání nových polí je rozpoznáno v rozhraní a propagováno do satelitů skladu prostřednictvím jednoduché aktualizace mapování.
- Souvislá end-to-end lineage. Od tabulky v ERP až po analytický mart je datová stopa úplná, auditovatelná a přirozeně propojená.
Řešení Datavault Builderu
Datavault Builder odstraňuje mezeru mezi ingestem a modelováním:
- Vlastní vestavěná konektivita. Relační databáze (JDBC), cloudová úložiště, REST API i další zdroje připojíte přímo bez nutnosti dalších smluv s externími dodavateli.
- Sladěný běh procesů. Ingest a nahrávání skladu jsou součástí jednoho řízeného toku, což eliminuje externí orchestrátory.
- Jediné místo podpory a odpovědnosti. Jedna smlouva, jeden nástroj a jedno místo, kde hledat příčinu, když něco selže.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Vyčíslit režii roztříštěného stacku
Spočítejte, kolik různých technologií a rozhraní stojí mezi transakčním systémem a finálním analytickým výstupem.
-
Propojit ingest s modelem
Využijte architekturu, kde staging a historizace vznikají v přímé koordinaci s extrakcí dat.
-
Nahrávat přímo delty
Napojte zdroje pomocí nativních vzorů (dávky, CDC, API), které plní sklad bez zbytečných mezičlánků.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Druhá strana mince dbt: Bujení kódu, skryté náklady a cesta k automatizaci
dbt přineslo do SQL modularitu a Git, čímž posunulo analytické inženýrství. S růstem projektů se však projevují limity: provozní režie Core versus poplatky za vývojáře v Cloudu, absence ingestu a záplava ručně psaných modelů. Platforma řízená modelem tuto volbu překonává.
-
Způsobují modely v dbt nárůst účtů za výpočetní výkon ve Snowflake nebo BigQuery?
dbt spouští veškerý kód přímo uvnitř vašeho analytického skladu. Pokud jsou modely nastaveny jako kompletní přenačtení celých tabulek nebo využívají ručně psané inkrementální strategie, spotřeba kreditů stoupá s každým během. V Data Vaultu generovaném z modelu je přírůstkové nahrávání jediný způsob, jakým nahrávání vzniká.
-
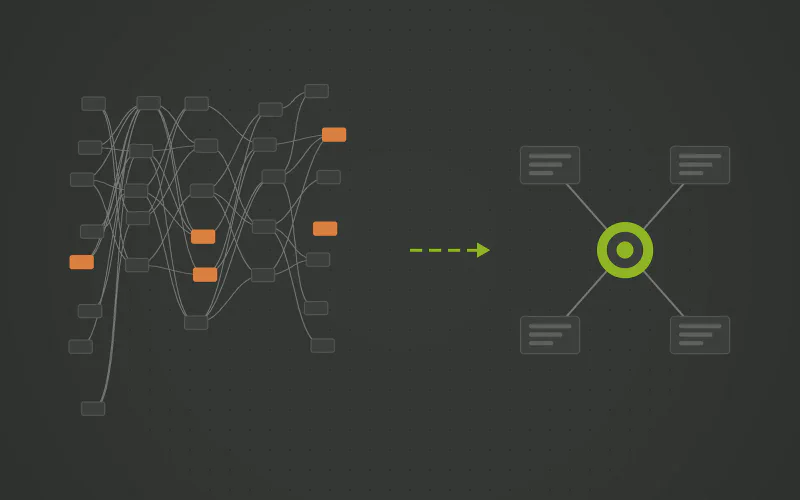
Proměnil se váš DAG v dbt v nepřehlednou síť, kterou nikdo nedokáže ladit?
Vytvořit nový model v dbt je tak snadné, že repozitáře rychle zaplní stovky SQL souborů bez jasných pravidel správy. Změna obchodního klíče výše v řetězci pak znamená dohledat každý model, který jej zdědil. Řešením je strukturovaná architektura řízená modelem s jasnými pravidly odvozování.
Otázky a odpovědi
- Fúze byla dokončena 1. června 2026. Fivetran a dbt Cloud zůstávají samostatnými produkty s oddělenou cenotvorbou a schéma, které Fivetran ukládá, stále neodpovídá modelu, který dbt potřebuje. Obě společnosti uvádějí, že užší integrace bude následovat. V současnosti je tato mezera mezi dvěma produkty jednoho dodavatele namísto dvou různých dodavatelů.
- Dávková, přírůstková (delta) i CDC nahrávání z databází přes JDBC, soubory a REST API, NoSQL úložiště přes konektor Trino a Python zdroje přes konektor gRPC. Datové toky jako Kafka přicházejí jako mikrodávky přes Trino. CDC je součástí edice Enterprise.
- Nikoli. Můžete si jej ponechat pro dlouhý chvost SaaS zdrojů, pokud je tam cenově výhodný, a objemné či technicky náročné zdroje načítat přímo přes platformu. Data Vault stojí spolehlivě za oběma způsoby.