Je SSIS jedinou součástí vašeho technologického stacku, která stále nezvládá CI/CD?
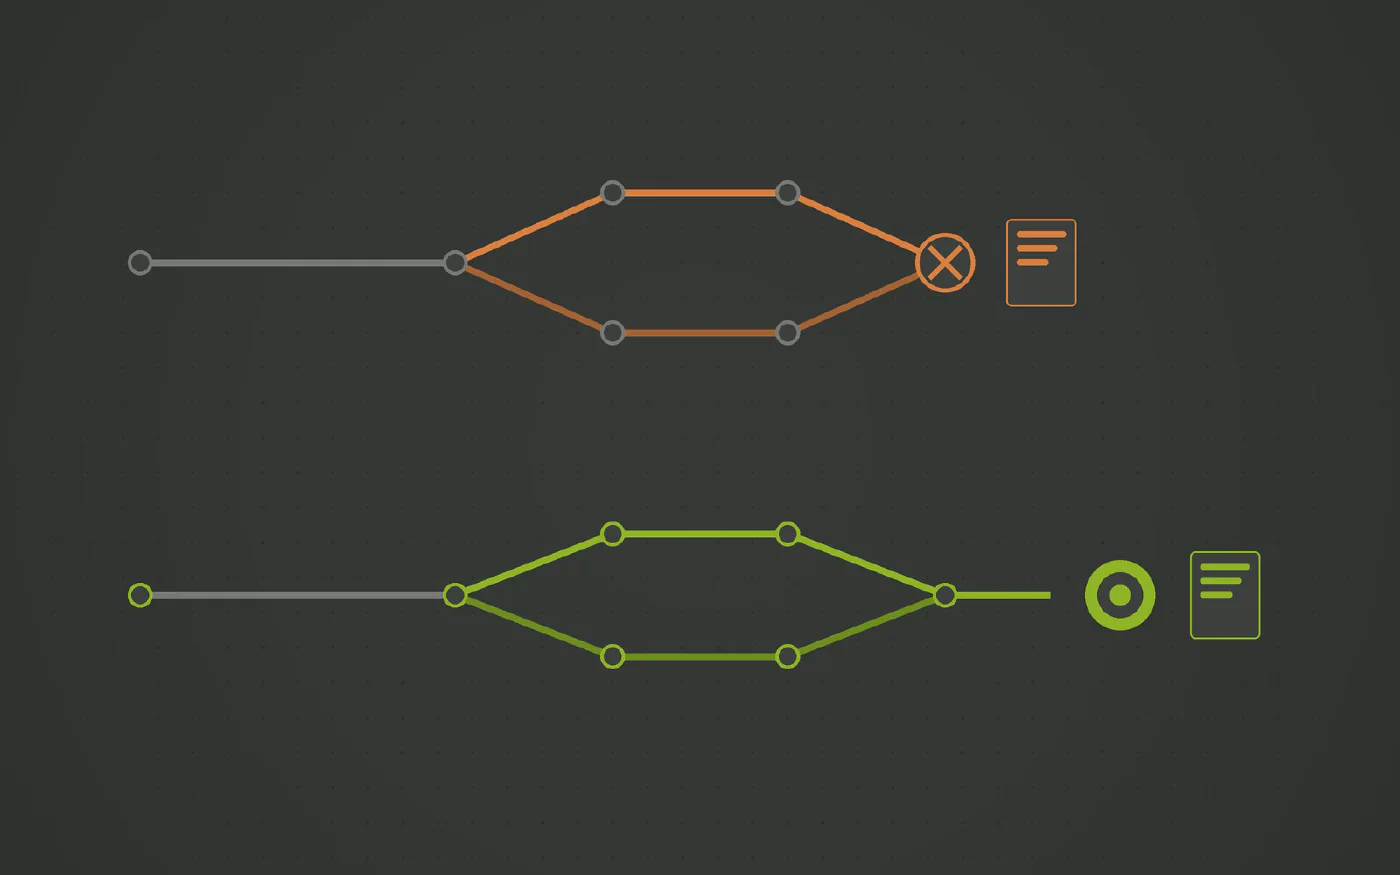
Soubor .dtsx je kód XML, který se v Gitu špatně porovnává a ještě hůř slučuje; pokud dva inženýři upraví stejný balíček, obvykle to končí jeho ruční přestavbou. Prostředí závisejí na ručně udržovaných proměnných v SSISDB. Releases by měly vznikat z modelu, pro každé prostředí zvlášť, včetně rollbacku.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Release pipeline nasadí balíček `.ispac`, ale zda vše funguje, se zjistí až ve chvíli, kdy odstartuje první naplánovaná úloha.
- Při potřebě rollbacku musíte dohledat předchozí soubor `.ispac` a doufat, že konfigurace proměnných v prostředí mu stále odpovídá.
- Dva vývojáři upravili stejný balíček v různých větvích Gitu a sloučení souborů XML skončilo neřešitelnými konflikty.
- Přenesení balíčků mezi prostředími Dev, Test a Prod vyžaduje ruční přepisování parametrů a připojovacích řetězců v databázi SSISDB.
V moderním softwarovém inženýrství jsou postupy CI/CD (průběžná integrace a nasazování) samozřejmostí: transparentní správa verzí, srozumitelné revize kódu prostřednictvím přehledných diffů, automatizované testování a bezpečné postupné nasazování s možností rollbacku.
Pro mnoho datových týmů zůstávají projekty v SSIS bolestivou výjimkou z těchto standardů.
Proč se SSIS vzpírá modernímu CI/CD
- Balíčky
.dtsxjsou monolitické XML. Visual Studio ukládá pozice prvků na plátně, barvy, nově vygenerovaná GUID při každém uložení i logiku toků do jediného souboru. Pull request v Azure DevOps je pak plný technického šumu, v němž nelze odlišit skutečnou věcnou změnu. - Konflikty při slučování bývají fatální. Pokud dva inženýři pracují na stejném balíčku v různých větvích, bezpečně sloučit jejich změny v souboru XML je téměř nemožné. Často nezbývá, než aby jeden z nich svou práci vytvořil znovu od nuly.
- Nasazení nahrazuje celý projekt. Standardní formát
.ispacpřepíše na serveru vše najednou. Dílčí změnu nelze nasadit samostatně. - Rollback je návratem ke starému souboru. Vrácení změn znamená znovu nahrát dřívější soubor
.ispaca spoléhat na to, že konfigurační proměnné v SSISDB jsou s ním stále kompatibilní.
Kam patří správa verzí
Problém nespočívá v nešikovnosti vývojářů, ale ve verzování grafických artefaktů namísto architektonického záměru:
- Verzovat podstatu a záměr. V Gitu má být uložena definice modelu: které entity existují, jaké satelity přibyly a jaká pravidla výpočtů platí.
- Čitelné diffy pro lidi. Revize kódu má přehledně ukazovat: „přidán atribut DatumNarození do satelitu Zákazník“, nikoli změny v metadatech XML.
- Generování release na míru prostředí. Balíček pro Test nebo Produkci má být SQL skript vygenerovaný na základě porovnání stavu modelu se stavem cílového prostředí.
Co přináší Datavault Builder
Datavault Builder má vestavěnou podporu Gitu a Gitflow, navrženou přímo pro správu datových skladů:
- Srozumitelné rozdíly. Revize v Gitu zobrazují sémantické změny v modelu datového skladu, což umožňuje rychlé a bezpečné schvalování v týmu.
- Releases generované porovnáním. Zvolte dva stavy (například vývojovou větev a testovací prostředí) a platforma vygeneruje migrační skript včetně závislostí, které jednotlivé změny potřebují.
- Rollback vytvořený automaticky. Každá release v sobě nese odpovídající reverzní skript pro vrácení databáze do původního stavu při neočekávaných potížích.
- Zapojení do stávajícího CI. Vygenerované skripty začleníte do svých pipelines v Azure DevOps nebo GitHub Actions.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Oddělit logiku od formátu XML
Obchodní záměr nesmí být utopen v grafických souřadnicích a interních identifikátorech GUID v souboru XML.
-
Verzovat model, nikoli balíček
Verzujte v Gitu konceptuální model, jehož revize ukazují čisté a srozumitelné rozdíly.
-
Generovat deterministické skripty nasazení
Vytvářejte SQL skripty na míru pro každé prostředí s promítnutými parametry a automaticky vygenerovaným rollbackem.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
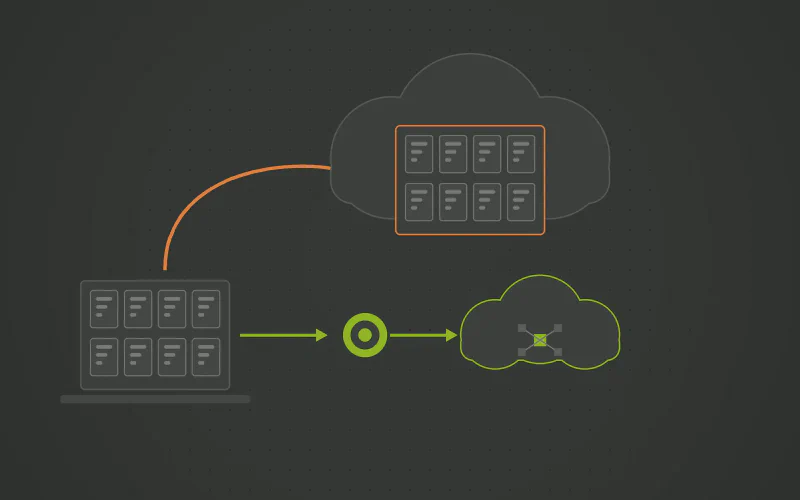
Uvažujete o přesunu svých balíčků SSIS do cloudu metodou lift-and-shift?
Starší projekty v SSIS s sebou nesou tři neduhy, které cloudový virtuální server nevyřeší: balíček pro každou tabulku, na který se nikdo neodvažuje sáhnout, nasazování mimo DevOps a architekturu svázanou s SQL Serverem. Azure-SSIS Integration Runtime přenáší všechny tři do cloudu beze změny. Model, který sklad generuje, je učiní zbytečnými.
-
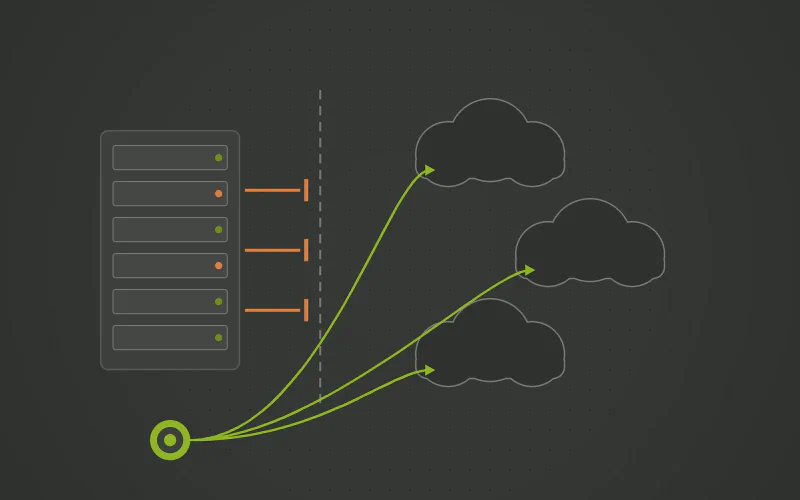
Provozujete stále SSIS na licencovaném SQL Serveru jen proto, abyste plnili Snowflake či cloud?
SQL Server Integration Services (SSIS) vznikly pro lokální ekosystém Microsoftu. Jejich použití pro plnění moderních cloudových skladů, jako jsou Snowflake, Databricks nebo Fabric, vyžaduje vyhrazené servery, konektory třetích stran a zbytečné licence pro SQL Server. Řešením je generovat nahrávání nativně přímo v cílovém databázovém stroji.
-
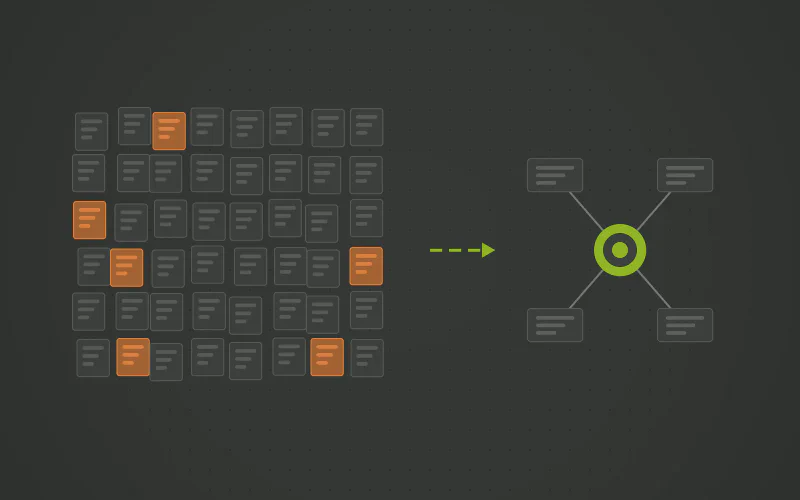
Převyšuje počet vašich balíčků SSIS počet lidí, kteří jim rozumí?
Stovky balíčků .dtsx, jeden pro každou tabulku, vytvořené ve Visual Studiu kýmkoli, kdo zrovna řešil daný úkol, s řídicími a datovými toky, jež se otevírají jen po jednom. Přidání sloupce znamená otevírat balíčky jeden po druhém. Řešením není šablona balíčku, ale model, který nahrávání generuje nativně pro SQL Server, Azure SQL nebo Fabric.
Otázky a odpovědi
-
Umožňuje ukládat soubory do Gitu, ale zásadní problém tkví v tom, co přesně se verzuje: soubor
.dtsxmíchá vizuální rozvržení, interní metadata a generovaná GUID se samotnou logikou. Diff v Gitu představuje nepřehledný šum a sloučení změn dvou vývojářů v jednom balíčku je málokdy bezpečné. Verzování modelu zachycuje podstatu a záměr; technický kód nasazení se z něj vygeneruje. - Generované skripty nasazení přizpůsobené konkrétnímu prostředí. Připojovací údaje pro jednotlivá prostředí jsou uloženy na jednom místě a vydání pro testovací nebo produkční prostředí se vytváří ze stejného modelu s aplikovanými hodnotami a včetně skriptu pro návrat (rollback).
-
Ano. Azure DevOps nebo GitHub Actions spouštějí vygenerovaný balíček pro nasazení. Co zcela mizí, je kompilace souboru
.ispaca ruční přepisování proměnných prostředí v katalogu SSISDB.