Blog — Data Vault et Automatisation DWH
Articles sur Data Vault 2.0, l'automatisation du data warehouse, Snowflake, Databricks et l'ingénierie des données en pratique.
-
Souveraineté des données et IA : DWH d'entreprise
Comment garder le contrôle de ses données à l'ère de l'IA : gouvernance moderne et architecture data warehouse dans ce webinaire exclusif.
Lire la suite → -
Data Vault et stack Medallion de Databricks
Data Vault et Lakehouse sont souvent perçus comme des approches contradictoires. Ce webinaire montre que c'est l'inverse.
Lire la suite → -
Comment je pense la valeur métier des données
Les projets data échouent rarement par manque de technologie, mais parce que la valeur métier arrive trop tard ou à un coût trop élevé.
Lire la suite → -
Certification ISO 27001:2022 et SOC 2 Type 2
Dans le paysage numérique en évolution rapide d'aujourd'hui, la sécurité des données n'est pas seulement une priorité — c'est une nécessité.
Lire la suite → -
Importer des modèles de données générés par l'IA Flow.BI
Migrez les métadonnées de l'IA Flow.BI vers Datavault Builder avec un Migration Vault : mappage des hubs, links et pipelines ETL automatisés.
Lire la suite → -
Intégrer et unionner les données
Dans la modélisation Data Vault, les hubs permettent d'unifier et d'intégrer les données d'entreprise : principes clés et meilleures pratiques.
Lire la suite → -
Analytique DWH quasi temps réel
Cartes de crédit, capteurs IoT et flux continus : découvrez comment traiter l'analytique en temps quasi réel avec cimt ag et Datavault Builder.
Lire la suite → -
SSO sur Snowflake Snowpark Container Services
Utiliser Datavault Builder avec Snowpark Container Services (SPCS) permet aux équipes data de déployer en toute autonomie sans dépendre de l'infra.
Lire la suite → -
Traitement des données bi-temporelles
Que vous gériez des comptes clients, des transactions financières ou des sinistres d'assurance, ce webinaire vous équipe pour gérer les données bi-temporelles.
Lire la suite → -
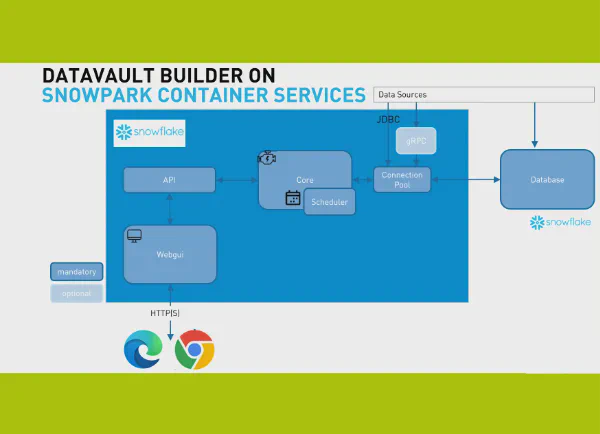
DVB sur Snowflake Snowpark Container Services
Dans cette vidéo, nous démontrons à quel point il est simple de faire tourner Datavault Builder sur les Snowflake Container Services.
Lire la suite → -
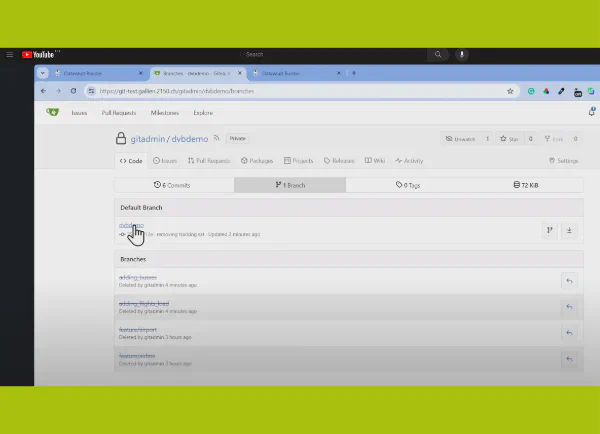
Check-In et Check-Out GIT directs sur le modèle
Bienvenue dans notre courte présentation sur Datavault Builder 7.1 et sa nouvelle fonctionnalité de check-in et check-out GIT pour le développement agile.
Lire la suite → -
Le concept de Migration Vault
Un Migration Vault est un magasin de métadonnées conçu comme un Data Vault pour faciliter et fiabiliser la migration vers de nouvelles plateformes.
Lire la suite → -
Alternative à Talend Open Studio comparée
Datavault Builder offre une grande variété de fonctionnalités et de modules pour le même coût que d'anciens outils ETL gratuits.
Lire la suite → -
Automatisation du Unified Star Schema
Découvrez l'automatisation du data warehouse avec le Unified Star Schema (USS), un concept conçu par Francesco Puppini et Bill Inmon.
Lire la suite → -
Yale University : révolutionner la gestion des données — 75 % d'économies et insights plus rapides
Comment Yale University a utilisé Datavault Builder pour réduire de 75 % les heures facturées, étoffer son équipe data et accélérer les analyses.
Lire la suite → -
Étude de cas BI-SPEKTRUM : C&A sur Snowflake
BI-SPEKTRUM a publié un article dans le numéro 2023/3 expliquant comment l'un de nos clients utilise Datavault Builder pour intégrer ses données SAP.
Lire la suite → -
Cas d'usage Willibald de la DDVUG
Regardez le cas d'usage DDVUG Willibald : construire un Data Warehouse complet avec 2 sources de données en moins de 3 heures avec Datavault Builder.
Lire la suite → -
La modélisation de données est-elle morte ?
Avons-nous encore besoin de modélisation de données ? Analyse de la valeur des modèles à l'ère du Data Vault et de l'automatisation DWH.
Lire la suite → -
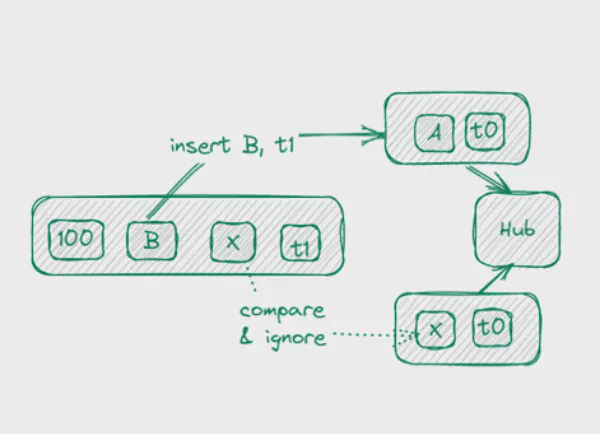
Data Vault bi-temporel : Inscription Time
Comment charger des données bi-temporelles dans le Data Vault en utilisant l'Inscription Time — patterns, pièges et exemples pratiques.
Lire la suite → -
Data Vault vs. Data Mesh ?
Devrais-je encore faire du Data Vault s'il y a Data Mesh ? Au cours des dernières semaines et mois, j'ai reçu ces questions très intéressantes plusieurs fois.
Lire la suite → -
CI/CD avec Datavault Builder sur Snowflake
Comment utiliser le Zero Copy Cloning de Snowflake avec Datavault Builder pour construire un pipeline CI/CD puissant pour votre data warehouse.
Lire la suite → -
Les Equi-Joins comptent-ils toujours ?
Pourquoi les jointures d'égalité (equi-joins) restent cruciales pour les performances des bases de données et du data warehouse.
Lire la suite → -
3NF et Data Vault : rien à craindre
De temps en temps nous recevons une question intéressante : Datavault Builder supporte-t-il 3NF ? La réponse est oui — et voici comment.
Lire la suite → -
Temporalité DWH Pt.4 : Dimensions SCD Type 2
Dimensions de style Kimball — sortie SCD Type 2. Si vous ne les avez pas lues, je recommande de lire d'abord les 3 premières parties.
Lire la suite → -
Temporalité DWH Partie 3 : Sortir les timelines
Bien que dans de nombreux cas il ne soit pas nécessaire de sortir les timelines dans les rapports, il y a des cas où la sortie des timelines est importante.
Lire la suite → -
Temporalité DWH Partie 2 : Réduire la complexité
Comment réduire la complexité temporelle dans le Data Vault : méthodes et bonnes pratiques pour modéliser les variations historiques des données.
Lire la suite → -
Temporalité DWH Partie 1 : Le défi
Au cours des dernières années, j'ai été confronté à la demande de créer un reporting avec des dimensions SCD type 2.
Lire la suite → -
À propos des Multi-Active Satellites dans Data Vault
Petr Beles sur l'implémentation des Multi-Active Satellites comme Document Satellites dans Data Vault : patterns, compromis et conseils pratiques.
Lire la suite → -
À propos des Links
Petr Beles sur les links Data Vault représentant des transactions : patterns, pièges et décisions de conception lors de la modélisation des transaction links.
Lire la suite → -
Qlik
Vos applications Qlik et vos rapports Power BI affichent-ils des chiffres différents ?
Ni Qlik ni Power BI n'a tort. Chacun a sa propre logique de chargement, ses propres définitions et son propre lineage, donc la même métrique est calculée deux fois et personne ne peut rapprocher les résultats. Les règles ont leur place dans un modèle de warehouse gouverné que les deux outils lisent.
Lire la suite → -
Tableau
Votre Tableau Server contient-il trop de versions du même chiffre ?
Chaque fichier .tdsx publié était une décision raisonnable le jour de sa création. Ensemble, ils forment des centaines de définitions isolées du même indicateur, sans aucun moyen de savoir laquelle fait foi.
Lire la suite → -
Power BI
Vos rapports Power BI affichent-ils des chiffres différents pour la même réalité ?
Les services Finance, Ventes et Opérations ont chacun construit leur propre modèle sémantique, et chacun est cohérent en lui-même. Les définitions n'étaient fausses nulle part. Elles n'ont simplement jamais été harmonisées.
Lire la suite → -
Qlik
Nettoyez-vous les mêmes données dans chaque script de chargement Qlik ?
Les mêmes MAPPING LOAD, corrections de chaînes et dédoublonnages sont réécrits dans chaque application et chaque couche QVD, et les copies divergent. Le nettoyage est répété script par script parce qu'aucune couche de data warehouse intégrée ne le fait une seule fois.
Lire la suite → -
Qlik
Vos expressions Set Analysis Qlik sont-elles trop longues et trop lentes ?
Le Set Analysis est précis pour de vraies comparaisons. La plupart des longues expressions de votre application existent parce que le modèle n'a jamais fourni l'historique, les flags ou une granularité unique, et le graphique les reconstruit donc à chaque sélection.
Lire la suite → -
Tableau
Vos expressions LOD Tableau sont-elles trop complexes pour oser y toucher ?
FIXED, INCLUDE et EXCLUDE sont des outils précis pour de véritables questions à plusieurs granularités. La plupart de celles de votre classeur sont là parce que le data warehouse n'a jamais résolu la granularité ni conservé l'historique.
Lire la suite → -
Power BI
Votre rapport Power BI DirectQuery est-il lent à chaque clic ?
DirectQuery et Direct Lake promettent des données en direct. Ce que vous obtenez, c'est un visuel de trente secondes et une facture de calcul que personne ne veut expliquer. Le mode n'est pas le problème. Le schéma sous-jacent, lui, l'est.
Lire la suite → -
Qlik
Vos applications Qlik créent-elles sans cesse des clés synthétiques ?
Les clés synthétiques et les références circulaires, c'est Qlik qui associe exactement ce qu'on lui a fourni. Elles apparaissent parce que les données arrivent sans dimensions conformes ni vraies clés, et chaque application doit donc les inventer.
Lire la suite → -
Qlik
Vos rechargements Qlik échouent-ils à mesure que les données grossissent ?
Le moteur en mémoire (in-memory) est rapide parce que tout se trouve en RAM. Les rechargements échouent et les applications ralentissent quand cette RAM est saturée de détails ligne à ligne et de transformations qu'aucun data warehouse n'a réalisées en amont.
Lire la suite → -
Tableau
Vos actualisations d'extraits Tableau échouent-elles ou prennent-elles du retard ?
Le Backgrounder Tableau expire, le fichier .hyper ne cesse de grossir, et le dashboard affiche les données de la veille. L'extrait est volumineux parce qu'il transporte des lignes brutes qui n'ont jamais été agrégées en amont.
Lire la suite → -
Power BI
Votre code DAX Power BI devient-il trop long à maintenir ?
Deux cents lignes de CALCULATE et de FILTER ne sont pas le signe d'un DAX avancé. C'est généralement le signe que le data warehouse ne vous a jamais fourni les clés, l'historique ou la granularité dont vous aviez besoin.
Lire la suite → -
Tableau
Votre dashboard Tableau est-il lent à chaque changement de filtre ?
Vingt secondes de « Exécution de la requête » à chaque clic sur un filtre. Tableau n'affiche pas lentement. Il attend une base de données à qui l'on a posé une question à laquelle elle ne peut pas répondre rapidement.
Lire la suite → -
Power BI
Votre actualisation Power BI échoue-t-elle chaque nuit ?
L'actualisation planifiée expire, Power Query manque de mémoire, et vous l'apprenez quand quelqu'un ouvre le dashboard. La cause n'est presque jamais Power BI. C'est ce qu'on demande à Power BI de faire.
Lire la suite → -
dbt
Le compromis dbt : prolifération du code, TCO caché et les arguments en faveur de la modélisation automatisée
dbt a apporté le génie logiciel au SQL, et les équipes ont raison de le vouloir. Le compromis est une couche de transformation qui s'alourdit en code, en coût et en calcul, au-dessus d'un outil d'ingestion qui reste un produit séparé. Un Data Vault généré retire toute cette couche de la base de code. Il n'a pas besoin de dbt, mais il peut se combiner avec lui.
Lire la suite → -
Azure Data Factory
Les limites d'Azure Data Factory : le coût caché des pipelines assemblés à la main et des transformations Spark
Azure Data Factory est une bonne couche de transport dans Azure et un mauvais endroit où loger un entrepôt de données. Utilisé comme suite de modélisation et de transformation, il apporte un canvas que personne ne sait lire, des releases qui échouent sur les templates ARM et des clusters Spark pour des chargements qui tiennent en une instruction SQL. Et chacun de ces pipelines n'existe que dans Azure.
Lire la suite → -
dbt
dbt vous laisse-t-il encore charger les données vous-même ?
dbt est un outil de transformation par conception. Il suppose que les données brutes sont déjà dans l'entrepôt, donc l'étape de chargement est un second produit avec une seconde facture, même maintenant que Fivetran et dbt Labs sont une seule entreprise. Une plateforme d'entrepôt qui ingère et modélise au même endroit comble la lacune sans second contrat.
Lire la suite → -
SSIS
Les limites de SSIS : porter les packages dans le cloud déplace la dette, pas le problème
Les parcs SSIS ont trois problèmes qu'une VM dans le cloud ne résout pas : un package par table que personne ne veut ouvrir, des releases que le DevOps n'atteint pas, et une conception qui s'arrête à SQL Server. L'Azure-SSIS Integration Runtime emmène les trois dans Azure intacts. Un modèle qui génère l'entrepôt les supprime à la place.
Lire la suite → -
dbt
Vos exécutions dbt font-elles discrètement grimper les coûts de calcul de l'entrepôt ?
dbt exécute tout dans l'entrepôt, donc un full refresh là où un chargement incrémental suffirait, ou une matérialisation en table qui se reconstruit chaque nuit, se traduit par des coûts de calcul, pas par une erreur. La logique incrémentale est optionnelle dans dbt. Dans un Data Vault généré, c'est la seule façon dont les chargements sont écrits.
Lire la suite → -
Azure Data Factory
Les Mapping Data Flows d'Azure Data Factory coûtent-ils plus cher que les données qu'ils déplacent ?
Les Mapping Data Flows tournent sur un cluster Spark managé qui met plusieurs minutes à démarrer et se facture à l'heure de vCore. Pour une grosse transformation nocturne, c'est un choix raisonnable. Pour quelques centaines de milliers de lignes, c'est un cluster démarré pour faire ce qu'une seule instruction SQL ferait à l'intérieur de l'entrepôt.
Lire la suite → -
dbt
Votre projet dbt compte-t-il plus de modèles que quiconque ne peut expliquer ?
ref() fait d'un nouveau modèle une décision d'une ligne, et un projet de centaines de fichiers SQL sans gouvernance claire en est le résultat. Changer une clé métier en amont revient alors à retrouver chaque modèle qui en a hérité. La solution ne consiste pas à ajouter des tests. C'est un modèle qui génère la structure au lieu de l'accumuler.
Lire la suite → -
SSIS
SSIS s'arrête-t-il là où commence votre entrepôt dans le cloud ?
SSIS a été conçu pour déplacer des données entre instances SQL Server on premises. Quand l'entrepôt part vers Fabric, Snowflake, Databricks ou BigQuery, les options sont de porter les packages sur un Azure-SSIS Integration Runtime, d'acheter des connecteurs tiers, ou de réécrire. Un modèle qui génère nativement pour la nouvelle plateforme est la quatrième option, et la seule qui n'emmène pas les packages avec elle.
Lire la suite → -
dbt
Votre facture dbt augmente-t-elle en licences, ou en ingénieurs ?
dbt Core est gratuit en licence et coûteux en exploitation. dbt Cloud est facile à exploiter et tarifé par développeur, plus l'usage. Dans les deux cas, la couche de transformation a un coût qui augmente avec la taille de l'équipe, et aucune des deux voies n'a été choisie pour cette raison.
Lire la suite → -
Azure Data Factory
Chaque release Azure Data Factory tourne-t-elle à la bataille de templates ARM ?
Sous l'éditeur visuel, une Azure Data Factory est du JSON : pipelines, datasets, linked services et le template ARM qui les déploie. Faire passer un changement de Dev à Prod implique des fichiers de paramètres, des paramètres globaux et un template qui échoue sur une seule incohérence de type. Les releases devraient être générées à partir d'un modèle, rollback inclus.
Lire la suite → -
Fivetran
Coûts et schémas Fivetran qui vous échappent ? Comment la modélisation automatisée supprime les points de friction de l'ingestion
L'ELT plug and play est rapide à démarrer et lent à contrôler. Deux choses s'érodent avec le temps : ce que le pipeline coûte, et qui décide de la structure des données. Une couche Data Vault automatisée vous rend les deux sans renoncer aux connecteurs qui fonctionnent.
Lire la suite → -
SSIS
SSIS est-il la seule partie de votre stack encore incapable de faire du CI/CD ?
Un fichier .dtsx est du XML qui se compare mal et se merge encore plus mal, si bien que deux ingénieurs sur un même package finissent par tout refaire. Les environnements résident dans des mappings de variables SSISDB maintenus à la main. Le DevOps moderne s'arrête au projet SSIS. Les releases devraient être générées à partir d'un modèle, par environnement, rollback inclus.
Lire la suite → -
Fivetran
Votre schéma Fivetran vous oblige-t-il à reconstruire le modèle après chaque chargement ?
Fivetran dépose chaque source dans son propre schéma standardisé. Les clés métier, les champs personnalisés et les structures héritées doivent ensuite être remodelés en SQL, un SQL qui casse quand le connecteur change. La solution n'est pas un meilleur script. C'est un modèle qui définit lui-même la structure.
Lire la suite → -
Azure Data Factory
Votre canvas Azure Data Factory est-il devenu trop grand pour ceux qui l'ont construit ?
Un pipeline en glisser-déposer est rapide à construire et lent à changer. Au-delà de quelques dizaines d'activités, le canvas devient la documentation, le câblage prend le pas sur la logique, et chaque nouvelle source est une copy activity de plus que personne ne veut toucher. La solution n'est pas un canvas plus ordonné. C'est un modèle qui génère les pipelines.
Lire la suite → -
Fivetran
Votre facture Fivetran bondit-elle chaque fois qu'une table source devient très active ?
Fivetran facture en fonction des Monthly Active Rows. Une mise à jour en masse ou une migration de schéma en amont touche à nouveau chaque ligne, et la facture suit. Les lignes n'ont jamais été le problème. Le problème, c'est de payer par ligne pour des données que vous retraitez ensuite vous-même.
Lire la suite → -
SSIS
Vos packages SSIS sont-ils plus nombreux que les gens capables de les comprendre ?
Des centaines de packages .dtsx, un par table, construits dans Visual Studio par celui qui avait le ticket, avec des control flows et des data flows qui ne s'ouvrent qu'un à la fois. Ajouter une colonne revient à ouvrir les packages un par un. La solution n'est pas un modèle de package. C'est un modèle qui génère les chargements, nativement sur SQL Server, Azure SQL ou Fabric.
Lire la suite →
Rien ici pour l'instant.