Votre rapport Power BI DirectQuery est-il lent à chaque clic ?
DirectQuery et Direct Lake promettent des données en direct. Ce que vous obtenez, c'est un visuel de trente secondes et une facture de calcul que personne ne veut expliquer. Le mode n'est pas le problème. Le schéma sous-jacent, lui, l'est.
La plateforme d'automatisation de data warehouse à laquelle font confiance les équipes data de tous les secteurs
Cela vous semble familier ?
- Chaque clic sur un filtre déclenche une nouvelle vague de requêtes et les visuels se traînent.
- Les coûts de calcul Synapse ou Fabric ont bondi le mois où le dashboard a été mis en ligne.
- Direct Lake bascule en DirectQuery et personne ne peut vous dire exactement pourquoi.
- Le même rapport est rapide en mode import, alors vous utilisez l'import et perdez les données en direct.
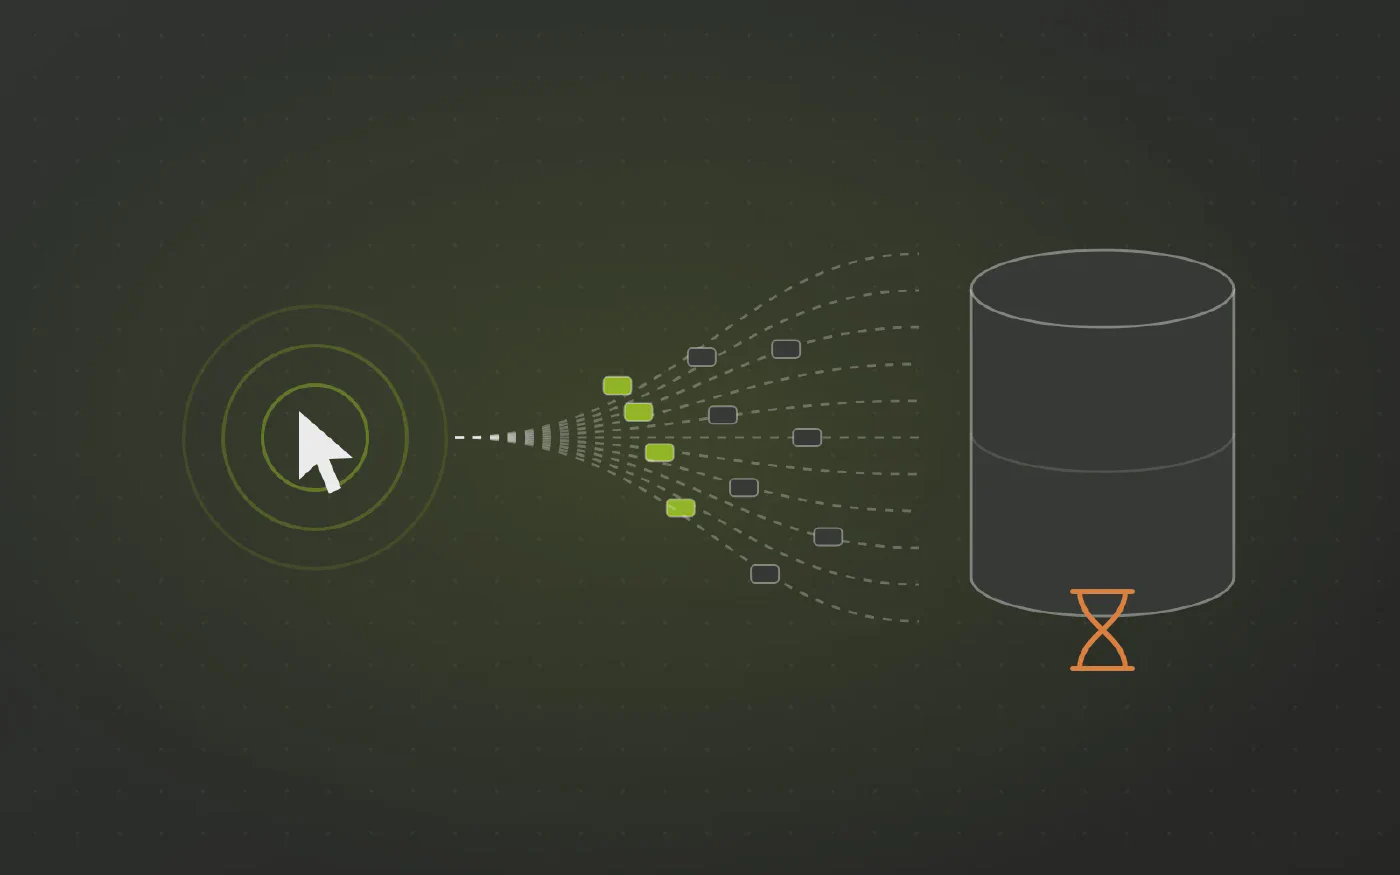
DirectQuery fait exactement ce que son nom indique : il transforme chaque interaction en SQL envoyé à votre base de données. La rapidité d’exécution dépend alors entièrement de la structure des données sous-jacentes.
Ce que génère DirectQuery
- Sur un schéma en étoile : une table de faits, quelques jointures de dimensions sur de vraies clés. La base répond en millisecondes.
- Sur un modèle 3NF ou des tables brutes du lake : des jointures imbriquées sur une douzaine de tables, reconstruites pour chaque visuel et chaque clic.
- Aucun pushdown sur lequel s’appuyer. Les tables non partitionnées et non indexées imposent un scan complet à chaque requête.
- Le basculement (fallback) s’effectue discrètement. Direct Lake repasse sans alerte en DirectQuery lorsque la source ne présente pas la structure requise, et c’est là que le coût apparaît.
Multipliez par le nombre de visuels sur la page, puis par le nombre d’utilisateurs simultanés. Voilà la facture.
Pourquoi cela retombe sur vous
- Le data warehouse a exposé ce qu’il avait sous la main : des tables transactionnelles et non des modèles analytiques.
- Le mode Import sert de contournement, mais il vous prive des données en direct pour lesquelles vous aviez choisi DirectQuery.
- Vous pouvez optimiser les visuels. Vous ne pouvez pas repartitionner la source.
Le travail se fait au mauvais endroit
- Structurer les tables pour l’analyse relève du data warehouse. DirectQuery ne peut pas pallier ce manque, et chaque clic paie le prix de cette modélisation absente.
- Ce travail a sa place dans un endroit central : un data warehouse ou un data hub, construit une fois et lu par chaque rapport.
- Si cela semble coûteux, l’estimation suppose probablement des pipelines construits à la main. Une plateforme d’automatisation spécialisée les génère à partir d’un modèle, ce qui change à la fois le coût et le délai.
Ce qui change quand le modèle arrive prêt à l’emploi
Datavault Builder génère des modèles dimensionnels nativement dans la plateforme cible, matérialisés ou virtualisés, conçus pour le pushdown analytique plutôt que pour l’accès transactionnel.
- Une table de faits, de vraies dimensions. Le SQL généré est court par construction.
- Les tables sont partitionnées et clusterisées sur les colonnes que les utilisateurs filtrent réellement.
- Direct Lake reste en Direct Lake, parce que les tables présentent déjà la structure attendue.
- Le coût de calcul baisse parce que chaque clic parcourt un modèle léger au lieu de la couche brute.
- Les données en direct ne se paient plus au prix de la vitesse.
Ce qu’il faut demander
« DirectQuery exécute des jointures sur des tables normalisées à chaque clic, donc le coût de calcul augmente avec le nombre d’utilisateurs. Peut-on exposer un schéma en étoile partitionné que ce rapport interrogerait à la place ? »
C’est assez précis pour être chiffré, et cela désigne la couche où la correction doit se faire.
Voyez-le fonctionner sur vos propres données
Réservez une démo gratuite et apportez le rapport qui vous pose le plus de problèmes.
Trois étapes vers des chiffres qui concordent
-
Extraire la logique existante
Rassemblez les calculs, jointures et filtres qui vivent aujourd’hui dans vos rapports.
-
La centraliser en un seul endroit
La logique passe une seule fois dans le modèle du warehouse, et chaque rapport lit la même définition.
-
Des chiffres qui concordent
Chaque rapport affiche le même chiffre, et « d’où vient ce chiffre » a une réponse visible.
Comment Datavault Builder fournit à votre rapport un modèle prêt à l'emploi
-
Le modèle arrive prêt à l'emploi
Datavault Builder génère le vault et le schéma en étoile pour qu’ils s’exécutent nativement dans la base de données dont vous disposez déjà : SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks ou BigQuery.
-
Le travail quitte le rapport
Pas de fusion, pas de parsing, pas de correspondance approximative. Ce travail a disparu du rapport.
-
Les sources arrivent intégrées
Les clients de l’ERP, du CRM et de la boutique en ligne sont rapprochés en un seul ensemble de dimensions conformes. La jointure a lieu une fois dans le warehouse, et non à nouveau dans chaque rapport.
-
Un historique interrogeable
Chaque modification est conservée à son arrivée, vous pouvez donc produire des rapports sur l’état passé comme sur l’état actuel, même lorsque le système source écrase ses propres enregistrements.
-
Chaque chiffre a son lineage
La logique gagne un lineage, donc « d’où vient ce chiffre » a une réponse visible.
-
Évolutions gérées en amont
Les dimensions à évolution lente sont gérées en amont sous forme de satellites du vault, pas approximées.
Témoignage client: Porta
Reconnu par BARC dans The Data Fabric Survey 26
Rencontrez notre expert
Vingt minutes avec notre Sales Director, et une réponse honnête sur l’adéquation avec votre situation.
Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Autres problèmes traités dans cette série
-
Vos rapports Power BI affichent-ils des chiffres différents pour la même réalité ?
Les services Finance, Ventes et Opérations ont chacun construit leur propre modèle sémantique, et chacun est cohérent en lui-même. Les définitions n’étaient fausses nulle part. Elles n’ont simplement jamais été harmonisées.
-
Votre code DAX Power BI devient-il trop long à maintenir ?
Deux cents lignes de CALCULATE et de FILTER ne sont pas le signe d’un DAX avancé. C’est généralement le signe que le data warehouse ne vous a jamais fourni les clés, l’historique ou la granularité dont vous aviez besoin.
-
Votre actualisation Power BI échoue-t-elle chaque nuit ?
L’actualisation planifiée expire, Power Query manque de mémoire, et vous l’apprenez quand quelqu’un ouvre le dashboard. La cause n’est presque jamais Power BI. C’est ce qu’on demande à Power BI de faire.