SSIS s'arrête-t-il là où commence votre entrepôt dans le cloud ?
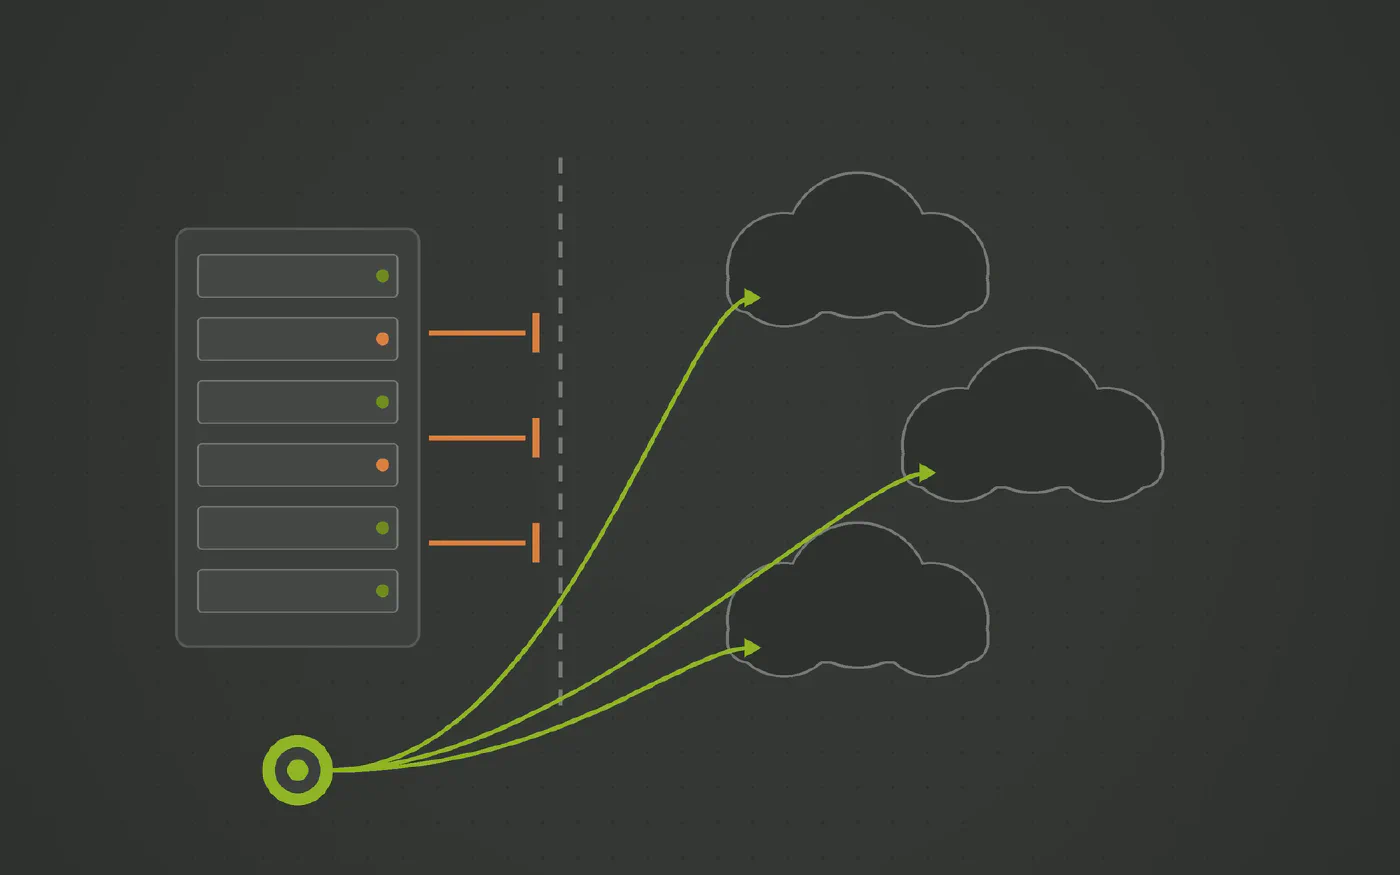
SSIS a été conçu pour déplacer des données entre instances SQL Server on premises. Quand l'entrepôt part vers Fabric, Snowflake, Databricks ou BigQuery, les options sont de porter les packages sur un Azure-SSIS Integration Runtime, d'acheter des connecteurs tiers, ou de réécrire. Un modèle qui génère nativement pour la nouvelle plateforme est la quatrième option, et la seule qui n'emmène pas les packages avec elle.
La plateforme d'automatisation de data warehouse à laquelle les équipes data font confiance









Cela vous semble familier ?
- L'entrepôt part vers Fabric ou Snowflake, et le plan pour les packages est une VM dans le cloud qui les exécute comme avant.
- Charger une source ou une cible non Microsoft implique un connecteur tiers avec sa propre licence et son propre cycle de mises à jour.
- Les gros chargements passent par le buffer du data flow SSIS sur un seul serveur, et ce serveur est la limite.
- La machine ETL a besoin de sa propre licence SQL Server, pour une charge de travail qui n'est ni la source ni l'entrepôt.
SSIS a été conçu pour un monde où la source et l’entrepôt étaient tous deux SQL Server, souvent dans le même centre de données. Il excelle dans ce rôle. Les problèmes commencent quand l’entrepôt part vers Fabric, Snowflake, Databricks ou BigQuery, et que les packages doivent suivre.
Pourquoi SSIS s’arrête à la frontière de la plateforme
- Le package suppose SQL Server aux deux extrémités. Les cibles non Microsoft imposent des connecteurs tiers, chacun avec sa licence, sa version et son propre cycle de mises à jour.
- La transformation s’exécute sur la machine SSIS. Les données traversent le réseau jusqu’au serveur SSIS, passent par le buffer du data flow, puis retraversent le réseau jusqu’à l’entrepôt. La mémoire et les cœurs de ce serveur sont le plafond, et chaque chargement subit ce double transfert réseau.
- Le serveur ETL a besoin de sa propre licence. SSIS est livré avec SQL Server, donc la machine qui ne fait qu’exécuter des packages porte quand même une licence SQL Server, pour une charge de travail qui n’est ni la source ni l’entrepôt.
- Le chemin vers le cloud est un simple portage. L’Azure-SSIS Integration Runtime exécute les packages tels quels, sur Azure. Le parc arrive dans le cloud avec tout ce qu’il avait.
Rien de tout cela n’est la faute de SSIS. Il a été construit pour une seule plateforme et il la sert bien.
Où les chargements devraient se situer
- Dans le moteur cible. Fabric, Snowflake, Databricks et BigQuery sont des moteurs ensemblistes. Un chargement delta généré s’exécute à l’intérieur, sur leurs ressources de calcul, sans aucun serveur ETL entre les deux.
- Dans un modèle indifférent à la plateforme. Déclarez l’entrepôt une fois ; générez-le pour la plateforme que vous avez aujourd’hui et pour celle vers laquelle vous irez.
- Sans emmener les packages. Une migration est le moment d’arrêter de maintenir des centaines de chargements construits à la main, pas de les héberger ailleurs.
Ce qui change avec Datavault Builder
Datavault Builder génère l’entrepôt nativement pour SQL Server, Azure SQL, Fabric, Snowflake, Databricks, BigQuery, Oracle et PostgreSQL à partir d’un seul modèle, avec sa propre ingestion depuis des sources on premises et cloud.
- Les chargements s’exécutent dans l’entrepôt. Du SQL delta ensembliste compilé pour le moteur cible. Pas de serveur SSIS, pas de buffer de data flow, pas de licence supplémentaire pour une machine ETL.
- Les sources se connectent directement. En batch, en delta et en CDC depuis des bases, des fichiers, des API REST, des sources NoSQL et Python, avec des flux comme Kafka traités en micro batches. Aucune couche de connecteurs tiers.
- La plateforme est un système cible. Le même modèle génère pour SQL Server aujourd’hui et pour Fabric ou Snowflake demain, chacun dans son dialecte SQL et son schéma de chargement. Le déménagement est une régénération, pas une réécriture, et cela fonctionne aussi dans l’autre sens.
- Les packages sont retirés, pas hébergés. Chaque source mappée dans le modèle est un package qui n’a pas besoin d’une VM dans le cloud.
- Rien n’impose une bascule brutale. Les chargements qui restent entre systèmes on premises peuvent rester dans SSIS jusqu’à ce qu’ils soient mappés.
Ce qu’il faut décider
Listez les packages dont la cible est l’entrepôt qui déménage. Ce sont les chargements que le portage emmènerait tels quels, et les premiers à générer pour la nouvelle plateforme à la place.
Voyez-le fonctionner sur l'une de vos sources
Réservez une démo gratuite et apportez le connecteur qui vous coûte le plus cher, en argent ou en temps.
Trois étapes vers un pipeline que vous maîtrisez
-
Lister les packages par cible
Quels chargements alimentent l’entrepôt qui déménage ? Ce sont ceux que le portage emmènerait tels quels.
-
Les modéliser pour la nouvelle plateforme
Les clés métier, les relations et les attributs vont dans le modèle Datavault Builder. Les chargements sont générés pour Fabric, Snowflake, Databricks ou BigQuery.
-
Garder SSIS pour ce qui reste on premises
Les chargements entre systèmes SQL Server on premises peuvent rester dans SSIS jusqu’à ce qu’ils soient mappés eux aussi. Rien n’impose une bascule brutale.
Comment Datavault Builder supprime les frictions de l'ingestion
-
L'ingestion est intégrée
Chargements batch, delta et CDC depuis les bases de données, les fichiers, les API REST, les sources NoSQL et Python, les flux comme Kafka arrivant en micro-batches. La même plateforme qui génère le warehouse, sans seconde facture.
-
Votre schéma, pas celui du fournisseur
Les tables source sont mappées vers un modèle Data Vault 2.0 que vous avez conçu. Une nouvelle colonne ou une table renommée change un mapping, pas une chaîne de scripts post-chargement.
-
Seuls les deltas circulent
Les Hubs, Links et Satellites chargent ce qui a changé. Les rechargements complets restent en staging au lieu d’être retraités en aval chaque nuit.
-
L'historique est conservé par conception
Chaque changement est conservé tel qu’il arrive, donc le reporting historique fonctionne même là où la source écrase ses propres lignes.
-
Du code que vous n'écrivez jamais
Le chargement, l’historisation et la traçabilité sont générés depuis le modèle en temps réel et s’exécutent nativement sur Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle ou PostgreSQL.
-
Une plateforme, jusqu'à neuf outils en moins
Modélisation, ETL, CI/CD, documentation et traçabilité au même endroit. C’est ce qui rend possible les 14,7 minutes entre le besoin et la production.
Reconnu par BARC dans The Data Fabric Survey 26







Rencontrez notre expert
Vingt minutes avec notre Sales Director et une réponse honnête sur l’adéquation avec votre stack.

Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Les autres problèmes traités par cette série
-
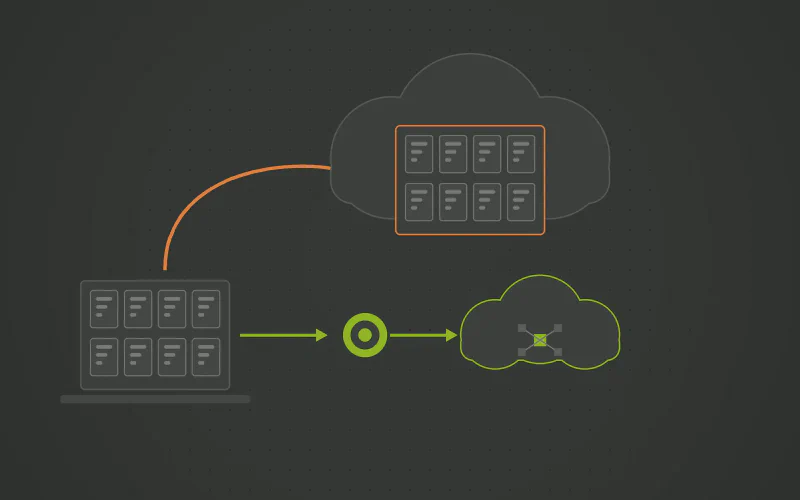
Les limites de SSIS : porter les packages dans le cloud déplace la dette, pas le problème
Les parcs SSIS ont trois problèmes qu’une VM dans le cloud ne résout pas : un package par table que personne ne veut ouvrir, des releases que le DevOps n’atteint pas, et une conception qui s’arrête à SQL Server. L’Azure-SSIS Integration Runtime emmène les trois dans Azure intacts. Un modèle qui génère l’entrepôt les supprime à la place.
-
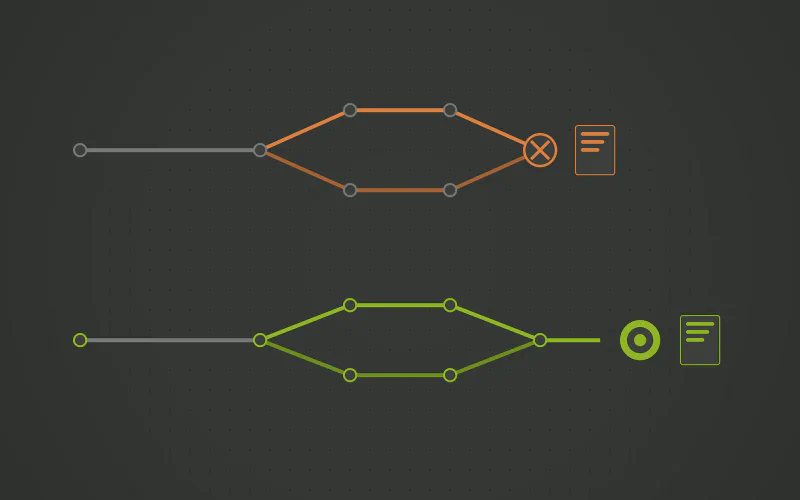
SSIS est-il la seule partie de votre stack encore incapable de faire du CI/CD ?
Un fichier .dtsx est du XML qui se compare mal et se merge encore plus mal, si bien que deux ingénieurs sur un même package finissent par tout refaire. Les environnements résident dans des mappings de variables SSISDB maintenus à la main. Le DevOps moderne s’arrête au projet SSIS. Les releases devraient être générées à partir d’un modèle, par environnement, rollback inclus.
-
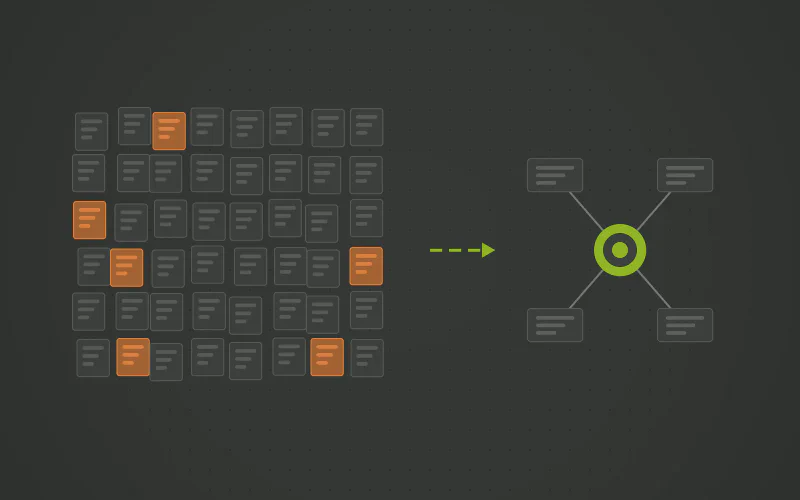
Vos packages SSIS sont-ils plus nombreux que les gens capables de les comprendre ?
Des centaines de packages .dtsx, un par table, construits dans Visual Studio par celui qui avait le ticket, avec des control flows et des data flows qui ne s’ouvrent qu’un à la fois. Ajouter une colonne revient à ouvrir les packages un par un. La solution n’est pas un modèle de package. C’est un modèle qui génère les chargements, nativement sur SQL Server, Azure SQL ou Fabric.
Questions et réponses
- Il exécute les packages sans les modifier sur Azure, et c’est précisément le problème : le package par table, les data flows construits à la main et la difficulté des merges suivent. C’est un pont, et la direction de Microsoft elle-même mène à Fabric Data Factory, pas à SSIS dans le cloud.
- Oui. En batch, en delta et en CDC depuis des bases via JDBC, des fichiers, des API REST, des sources NoSQL et Python, avec des flux comme Kafka traités en micro batches, vers un entrepôt généré nativement pour la plateforme cible.
- Alors l’entrepôt généré tourne sur SQL Server ou Azure SQL, et la modernisation porte sur l’ETL, pas sur la plateforme. Passer à Fabric plus tard est un changement de cible.