dbt vous laisse-t-il encore charger les données vous-même ?
dbt est un outil de transformation par conception. Il suppose que les données brutes sont déjà dans l'entrepôt, donc l'étape de chargement est un second produit avec une seconde facture, même maintenant que Fivetran et dbt Labs sont une seule entreprise. Une plateforme d'entrepôt qui ingère et modélise au même endroit comble la lacune sans second contrat.
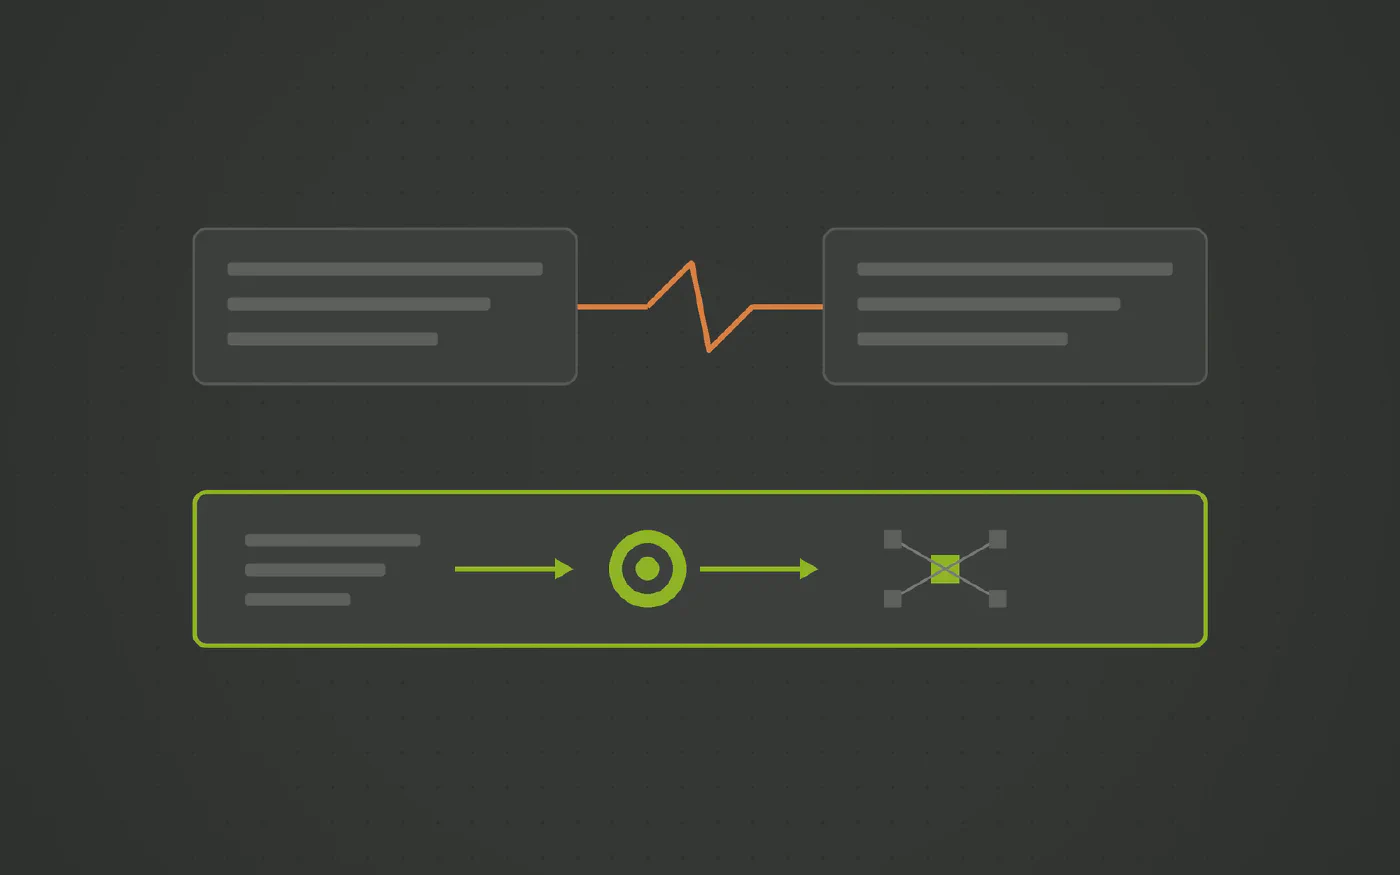
La plateforme d'automatisation de data warehouse à laquelle les équipes data font confiance









Cela vous semble familier ?
- Avant qu'un seul modèle dbt puisse tourner, un produit séparé doit avoir chargé les données, et ce produit a sa propre tarification, son propre schéma et ses propres modes de défaillance.
- Le pipeline se compose de deux systèmes avec un passage de relais au milieu, et chaque incident commence par déterminer de quel côté il se trouve.
- Les schémas de chargement changent sous les sources dbt, et le premier signe est une exécution en échec le lendemain matin.
- La couche de staging de dbt existe surtout pour défaire les décisions que l'outil d'ingestion a prises sur la structure.
dbt, désormais une seule entreprise avec Fivetran, est explicitement un outil de transformation. Il n’extrait pas, et il ne charge pas depuis l’extérieur de l’entrepôt. C’est un choix de conception clair, et il impose à chaque équipe un second produit à acheter, configurer et payer avant que le premier modèle ne tourne.
Pourquoi la lacune coûte plus qu’il n’y paraît
- Deux produits, deux factures. L’ingestion est tarifée selon ses propres termes, par ligne ou par connecteur, et la transformation selon les siens, par licence ou par usage. Aucune des deux ne connaît l’autre.
- Deux schémas. L’outil d’ingestion dépose les données dans sa propre structure. La couche de staging de dbt consacre ensuite ses premiers modèles à convertir cette structure en une structure que le projet peut utiliser.
- Un passage de relais, tous les incidents. Un changement de schéma côté chargement se découvre sous la forme d’une exécution dbt en échec. La responsabilité du correctif est une discussion avant d’être un ticket.
- Une fusion ne corrige pas l’architecture. Depuis le 1er juin 2026, Fivetran et dbt Labs sont une seule entreprise, et toujours deux produits avec des tarifications séparées. Le schéma de chargement n’est toujours pas le modèle.
Où l’ingestion devrait se situer
- À côté du modèle. L’outil qui connaît les clés métier et les règles d’historique est l’outil le mieux placé pour charger la source comme le modèle l’attend.
- Tarifée avec l’entrepôt, pas par ligne. Charger via la plateforme s’appuie sur des ressources de calcul que vous possédez déjà, sans second décompte.
- Avec un seul responsable. Un pipeline sans passage de relais ne laisse aucune place au débat sur le côté qui a cassé.
Ce qui change avec Datavault Builder
Datavault Builder ingère et modélise dans la même plateforme : chargements batch, delta et CDC depuis des bases de données, des fichiers, des API REST, des sources NoSQL et Python, avec des flux comme Kafka qui arrivent en micro-batches, mappés directement en hubs, links et satellites.
- Pas de second produit pour le chargement. Les sources se connectent à la plateforme qui génère l’entrepôt. Un contrat, un outil, un seul endroit où regarder quand quelque chose échoue.
- Pas de structure à défaire. La table de chargement est mappée au modèle telle qu’elle arrive. Il n’y a pas de schéma intermédiaire qu’une couche de staging doive inverser.
- Les changements de schéma sont gérés au point de chargement. Une nouvelle colonne est une mise à jour de mapping, pas une exécution en échec le lendemain matin.
- La couche de livraison suit dans le même outil. Les marts et les produits de données se construisent par glisser-déposer sur la couche sémantique, avec des règles métier versionnées. Les équipes qui gardent l’exploitation dans dbt obtiennent les modèles dbt générés à partir du même modèle.
- La longue traîne peut rester. Un connecteur managé reste un bon choix pour les petites sources SaaS. Le vault ne se soucie pas de la route qu’une table a prise.
Ce qu’il faut décider
Listez les sources où le schéma de l’outil d’ingestion et le modèle de staging dbt qui le défait sont maintenus par deux personnes différentes. Ce sont les sources à charger en premier via la plateforme.
Voyez-le fonctionner sur l'une de vos sources
Réservez une démo gratuite et apportez le connecteur qui vous coûte le plus cher, en argent ou en temps.
Trois étapes vers un pipeline que vous maîtrisez
-
Charger via la plateforme
Datavault Builder ingère en batch, delta ou CDC depuis des bases de données, des fichiers, des API REST, des sources NoSQL et Python.
-
Modéliser sur les données chargées
Les sources se mappent en hubs, links et satellites dans le même outil, sans passage de relais et sans second schéma à rapprocher.
-
Livrer à partir du même modèle
Les marts et les produits de données par glisser-déposer, ou des modèles dbt générés si l’exploitation reste dans dbt.
Comment Datavault Builder supprime les frictions de l'ingestion
-
L'ingestion est intégrée
Chargements batch, delta et CDC depuis les bases de données, les fichiers, les API REST, les sources NoSQL et Python, les flux comme Kafka arrivant en micro-batches. La même plateforme qui génère le warehouse, sans seconde facture.
-
Votre schéma, pas celui du fournisseur
Les tables source sont mappées vers un modèle Data Vault 2.0 que vous avez conçu. Une nouvelle colonne ou une table renommée change un mapping, pas une chaîne de scripts post-chargement.
-
Seuls les deltas circulent
Les Hubs, Links et Satellites chargent ce qui a changé. Les rechargements complets restent en staging au lieu d’être retraités en aval chaque nuit.
-
L'historique est conservé par conception
Chaque changement est conservé tel qu’il arrive, donc le reporting historique fonctionne même là où la source écrase ses propres lignes.
-
Du code que vous n'écrivez jamais
Le chargement, l’historisation et la traçabilité sont générés depuis le modèle en temps réel et s’exécutent nativement sur Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle ou PostgreSQL.
-
Une plateforme, jusqu'à neuf outils en moins
Modélisation, ETL, CI/CD, documentation et traçabilité au même endroit. C’est ce qui rend possible les 14,7 minutes entre le besoin et la production.
Reconnu par BARC dans The Data Fabric Survey 26







Rencontrez notre expert
Vingt minutes avec notre Sales Director et une réponse honnête sur l’adéquation avec votre stack.

Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Les autres problèmes traités par cette série
-
Le compromis dbt : prolifération du code, TCO caché et les arguments en faveur de la modélisation automatisée
dbt a apporté le génie logiciel au SQL, et les équipes ont raison de le vouloir. Le compromis est une couche de transformation qui s’alourdit en code, en coût et en calcul, au-dessus d’un outil d’ingestion qui reste un produit séparé. Un Data Vault généré retire toute cette couche de la base de code. Il n’a pas besoin de dbt, mais il peut se combiner avec lui.
-
Vos exécutions dbt font-elles discrètement grimper les coûts de calcul de l'entrepôt ?
dbt exécute tout dans l’entrepôt, donc un full refresh là où un chargement incrémental suffirait, ou une matérialisation en table qui se reconstruit chaque nuit, se traduit par des coûts de calcul, pas par une erreur. La logique incrémentale est optionnelle dans dbt. Dans un Data Vault généré, c’est la seule façon dont les chargements sont écrits.
-
Votre projet dbt compte-t-il plus de modèles que quiconque ne peut expliquer ?
ref() fait d’un nouveau modèle une décision d’une ligne, et un projet de centaines de fichiers SQL sans gouvernance claire en est le résultat. Changer une clé métier en amont revient alors à retrouver chaque modèle qui en a hérité. La solution ne consiste pas à ajouter des tests. C’est un modèle qui génère la structure au lieu de l’accumuler.
Questions et réponses
- La fusion a été finalisée le 1er juin 2026. Fivetran et dbt Cloud restent des produits séparés avec des tarifications séparées, et le schéma que Fivetran dépose n’est toujours pas le modèle dont dbt a besoin. Les deux entreprises annoncent qu’une intégration plus étroite suivra. Aujourd’hui, la lacune se situe entre deux produits d’un seul fournisseur au lieu de deux fournisseurs.
- Des chargements batch, delta et CDC depuis des bases de données via JDBC, des fichiers et des API REST, des bases NoSQL via le connecteur Trino et des sources Python via un connecteur gRPC. Les flux comme Kafka arrivent en micro-batches via Trino. Le CDC fait partie de l’édition Enterprise.
- Non. Gardez-le pour la longue traîne des sources SaaS s’il y est bon marché, et chargez les sources lourdes ou délicates via la plateforme. Le vault se place derrière les deux.