Votre projet dbt compte-t-il plus de modèles que quiconque ne peut expliquer ?
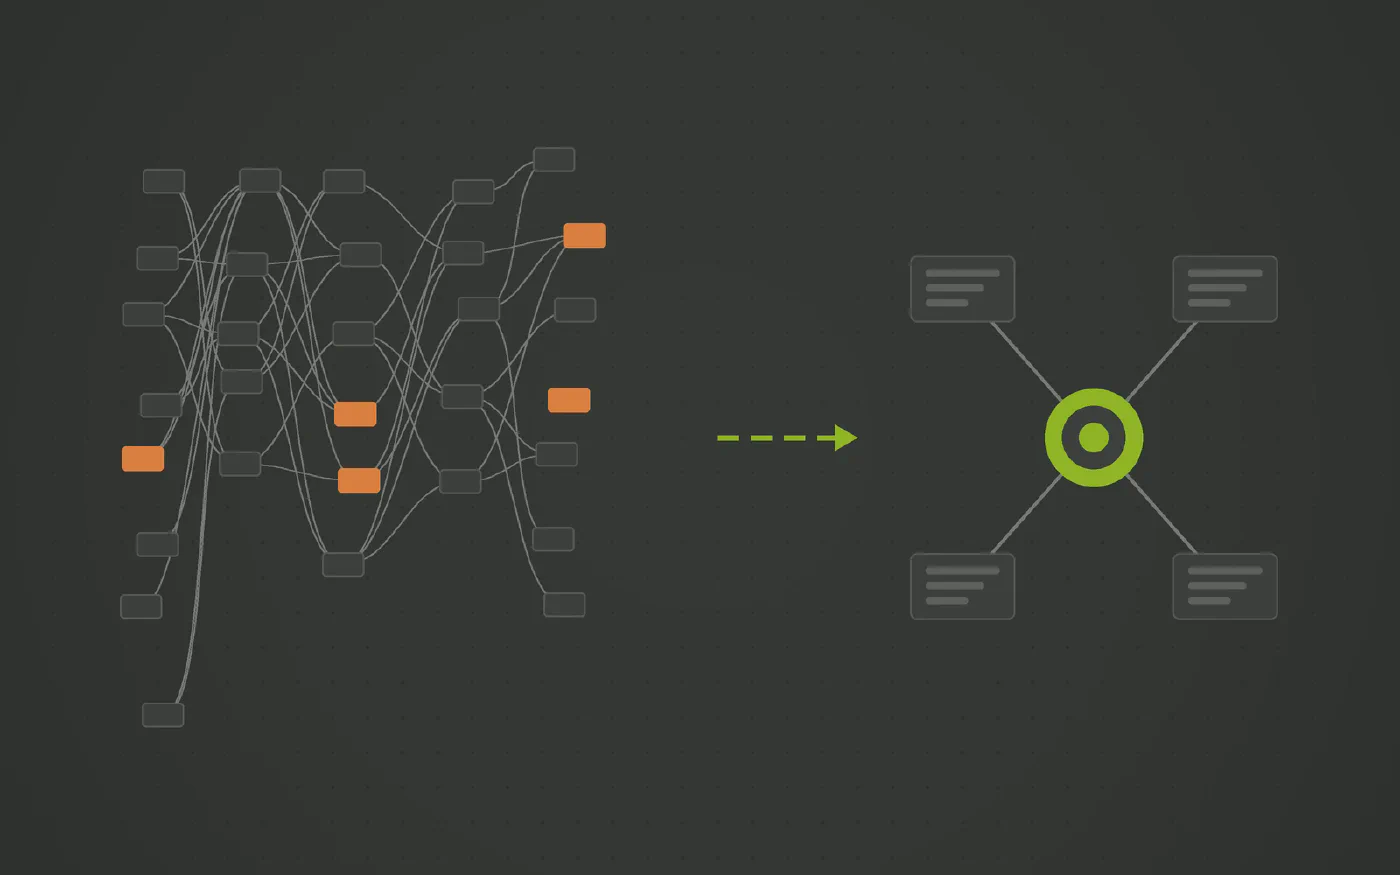
ref() fait d'un nouveau modèle une décision d'une ligne, et un projet de centaines de fichiers SQL sans gouvernance claire en est le résultat. Changer une clé métier en amont revient alors à retrouver chaque modèle qui en a hérité. La solution ne consiste pas à ajouter des tests. C'est un modèle qui génère la structure au lieu de l'accumuler.
La plateforme d'automatisation de data warehouse à laquelle les équipes data font confiance









Cela vous semble familier ?
- Le DAG compte des centaines de modèles, et une poignée de personnes savent pourquoi la moitié d'entre eux existent.
- Un changement de clé métier en amont casse des modèles trois couches plus bas dont personne ne se souvenait qu'ils en dépendaient.
- La même logique de staging existe en plusieurs versions légèrement différentes parce que copier un modèle était plus rapide que d'en réutiliser un.
- Le refactoring est planifié chaque trimestre et n'est achevé dans aucun.
dbt, désormais une seule entreprise avec Fivetran, a rendu la création d’un modèle triviale.
select * from ref('...') et un nouveau nœud existe. C’est justement l’intérêt de l’outil, et sur deux ou
trois ans c’est aussi ainsi qu’un projet grandit jusqu’à des centaines de modèles avec un
lineage que personne ne peut garder en tête. Quand créer du code ne demande aucun effort,
l’accumulation est le résultat par défaut.
Pourquoi les projets prolifèrent
- Forker coûte moins cher que changer. dbt a des macros et des packages pour les patterns standard, mais n’importe quel développeur peut les modifier, et changer proprement un pattern partagé implique des tests de régression et des scripts de migration. On crée donc une seconde version du pattern qui ne convient pas tout à fait.
- La structure et la logique cohabitent dans les mêmes fichiers. Un modèle qui met une source en staging, un qui gère l’historique, et un qui calcule la marge se ressemblent tous dans le DAG.
- Les dépendances sont déclarées, pas conçues.
ref()enregistre qu’un modèle en lit un autre ; il ne dit pas pourquoi, ni ce qui casse si la clé en amont change. - La gouvernance arrive après coup. Les conventions de nommage, les dossiers et les tests sont appliqués à un projet déjà volumineux au moment où quelqu’un les a formalisés.
L’outillage n’est pas en cause. Un framework qui rend le SQL modulaire sera utilisé pour écrire beaucoup de SQL modulaire.
Où la structure devrait se situer
- La plupart des modèles sont structurels. Le staging, le dédoublonnage, la génération des clés, le suivi de l’historique : c’est le même pattern par source, qui ne diffère que par les noms de colonnes.
- Le code structurel devrait être généré, pas accumulé. Déclarez la clé métier, les relations et les attributs une seule fois, et dérivez le code de chargement d’un pattern qu’aucun projet ne modifie.
- La logique est la partie qui mérite d’être écrite à la main. Les règles métier, les métriques et la structure des marts sont une petite part du projet et la partie qui mérite une revue de code.
Ce qui change avec Datavault Builder
Datavault Builder conserve la structure dans un modèle visuel et en génère les hubs, links, satellites et leurs chargements, donc la partie répétée du projet n’existe plus sous forme de fichiers.
- Une définition par concept. Un hub client avec cinq sources est un hub et cinq mappings dans le modèle, pas quinze modèles dans un dossier.
- Les dépendances sont dérivées. L’ordre de chargement et le lineage découlent du modèle, donc un changement de clé en amont est visible avant le déploiement, pas après.
- Les métadonnées traversent les couches. Les types, les clés et les descriptions sont déclarés une fois et propagés du staging jusqu’aux marts, au lieu d’être répétés dans chaque fichier de modèle.
- Le refactoring est une édition du modèle. Changez le mapping, régénérez, et chaque structure dépendante est reconstruite de manière cohérente.
- La documentation est le modèle. Le lineage, les définitions et les règles d’historique se lisent en un seul endroit, sans build de documentation.
- Les règles métier sont gérées dans le modèle, avec des versions. La couche de livraison se construit par glisser-déposer sur la couche sémantique, donc les règles et les produits de données sont regroupés au même endroit, avec un historique.
- dbt peut rester, sous forme générée. Si l’exploitation reste dans dbt, les modèles dbt sont générés à partir du même modèle et régénérés à chaque changement, ce qui est une façon bien plus simple de les mettre à jour que d’éditer des centaines de fichiers.
Ce qu’il faut décider
Auditez le projet et classez chaque modèle selon ce qu’il fait : staging, clés, historisation ou calcul. Si les trois premiers constituent l’essentiel de la liste, c’est la part structurelle, et c’est la part qu’un générateur devrait prendre en charge.
Voyez-le fonctionner sur l'une de vos sources
Réservez une démo gratuite et apportez le connecteur qui vous coûte le plus cher, en argent ou en temps.
Trois étapes vers un pipeline que vous maîtrisez
-
Séparer la structure de la logique
Le staging, les clés et l’historique relèvent de la structure. Les règles et les métriques relèvent de la logique. L’essentiel de la prolifération est structurel.
-
Générer la structure
Les hubs, les links, les satellites et leurs chargements viennent du modèle dans Datavault Builder, à raison d’une définition par concept métier.
-
Livrer à partir du modèle
Les marts et les produits de données s’assemblent par glisser-déposer, et les règles sont versionnées dans la plateforme. Ou générez des modèles dbt si l’exploitation y reste.
Comment Datavault Builder supprime les frictions de l'ingestion
-
L'ingestion est intégrée
Chargements batch, delta et CDC depuis les bases de données, les fichiers, les API REST, les sources NoSQL et Python, les flux comme Kafka arrivant en micro-batches. La même plateforme qui génère le warehouse, sans seconde facture.
-
Votre schéma, pas celui du fournisseur
Les tables source sont mappées vers un modèle Data Vault 2.0 que vous avez conçu. Une nouvelle colonne ou une table renommée change un mapping, pas une chaîne de scripts post-chargement.
-
Seuls les deltas circulent
Les Hubs, Links et Satellites chargent ce qui a changé. Les rechargements complets restent en staging au lieu d’être retraités en aval chaque nuit.
-
L'historique est conservé par conception
Chaque changement est conservé tel qu’il arrive, donc le reporting historique fonctionne même là où la source écrase ses propres lignes.
-
Du code que vous n'écrivez jamais
Le chargement, l’historisation et la traçabilité sont générés depuis le modèle en temps réel et s’exécutent nativement sur Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle ou PostgreSQL.
-
Une plateforme, jusqu'à neuf outils en moins
Modélisation, ETL, CI/CD, documentation et traçabilité au même endroit. C’est ce qui rend possible les 14,7 minutes entre le besoin et la production.
Reconnu par BARC dans The Data Fabric Survey 26







Rencontrez notre expert
Vingt minutes avec notre Sales Director et une réponse honnête sur l’adéquation avec votre stack.

Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Les autres problèmes traités par cette série
-
Le compromis dbt : prolifération du code, TCO caché et les arguments en faveur de la modélisation automatisée
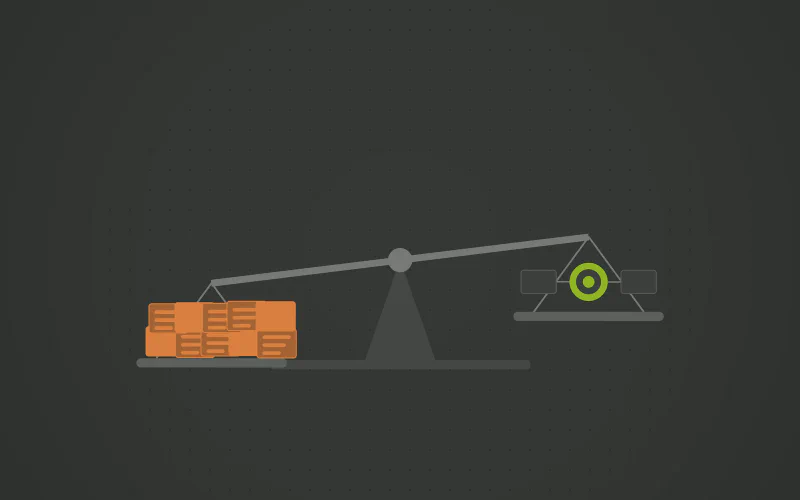
dbt a apporté le génie logiciel au SQL, et les équipes ont raison de le vouloir. Le compromis est une couche de transformation qui s’alourdit en code, en coût et en calcul, au-dessus d’un outil d’ingestion qui reste un produit séparé. Un Data Vault généré retire toute cette couche de la base de code. Il n’a pas besoin de dbt, mais il peut se combiner avec lui.
-
dbt vous laisse-t-il encore charger les données vous-même ?
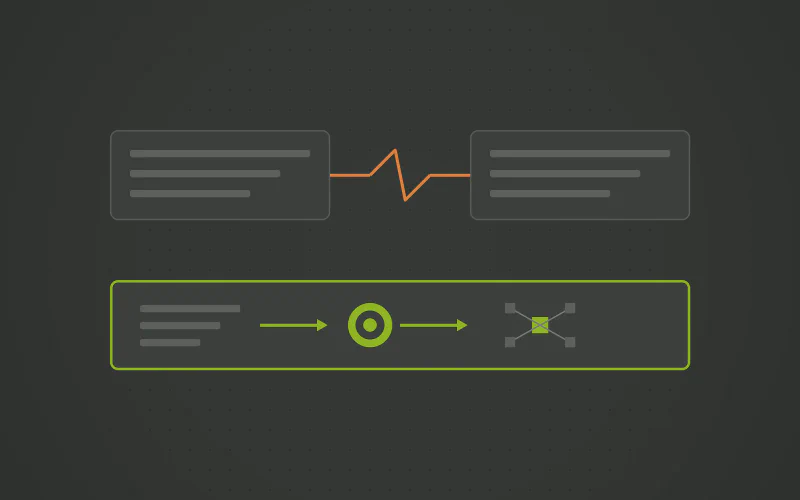
dbt est un outil de transformation par conception. Il suppose que les données brutes sont déjà dans l’entrepôt, donc l’étape de chargement est un second produit avec une seconde facture, même maintenant que Fivetran et dbt Labs sont une seule entreprise. Une plateforme d’entrepôt qui ingère et modélise au même endroit comble la lacune sans second contrat.
-
Vos exécutions dbt font-elles discrètement grimper les coûts de calcul de l'entrepôt ?
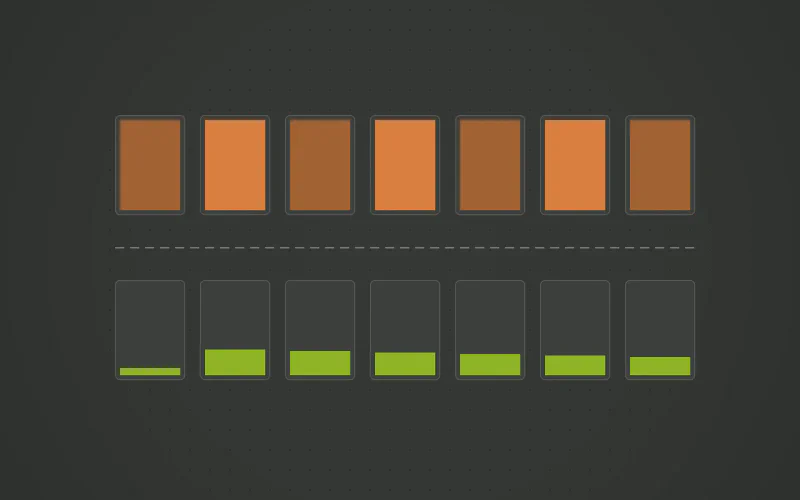
dbt exécute tout dans l’entrepôt, donc un full refresh là où un chargement incrémental suffirait, ou une matérialisation en table qui se reconstruit chaque nuit, se traduit par des coûts de calcul, pas par une erreur. La logique incrémentale est optionnelle dans dbt. Dans un Data Vault généré, c’est la seule façon dont les chargements sont écrits.
Questions et réponses
- AutomateDV génère le SQL des hubs, links et satellites à partir de macros que vous configurez par modèle, ce qui est un vrai progrès par rapport au code vault écrit à la main. Ce qui reste à votre charge : la couche de staging, les métadonnées de chaque appel de macro, l’ordre d’orchestration, et la gestion de l’historique pour les changements dans la source. Dans Datavault Builder, tout cela est dérivé d’un seul modèle visuel et mis à jour quand le modèle change, et le modèle lui-même est la documentation. Il existe aussi un chemin direct : le Migration Vault est un modèle de données de hubs, links, satellites, sources et clés métier. Mappez-y les métadonnées qu’un projet AutomateDV possède déjà, et Datavault Builder génère un package de déploiement à partir de ce mapping.
- Le modèle a une entrée par concept métier et par mapping de source, pas un fichier par étape de transformation. Un hub client avec cinq sources est un hub et cinq mappings, pas quinze modèles.
- Oui, de deux façons. Le vault et les marts générés sont des tables et des vues ordinaires, donc les modèles dbt existants peuvent les lire. Et si vous voulez continuer à exploiter via dbt, Datavault Builder génère les modèles dbt à partir de son propre modèle, donc la prolifération ne revient pas : un changement se fait dans le modèle et le projet dbt est régénéré.