SSIS est-il la seule partie de votre stack encore incapable de faire du CI/CD ?
Un fichier .dtsx est du XML qui se compare mal et se merge encore plus mal, si bien que deux ingénieurs sur un même package finissent par tout refaire. Les environnements résident dans des mappings de variables SSISDB maintenus à la main. Le DevOps moderne s'arrête au projet SSIS. Les releases devraient être générées à partir d'un modèle, par environnement, rollback inclus.
La plateforme d'automatisation de data warehouse à laquelle les équipes data font confiance









Cela vous semble familier ?
- Deux développeurs ont modifié le même package sur deux branches, et le merge a été réglé en gardant l'un et en refaisant le travail de l'autre.
- Dev, Test et Prod diffèrent par des variables d'environnement SSISDB que quelqu'un met à jour à la main avant chaque release.
- Le pipeline de release déploie le .ispac, et on découvre s'il a fonctionné à la première exécution du job.
- Revenir en arrière signifie retrouver le .ispac précédent et espérer que les mappings d'environnement lui correspondent encore.
Le DevOps moderne atteint la plus grande partie d’une plateforme de données Microsoft et s’arrête au projet SSIS. Les packages sont dans Git, le pipeline de release déploie le .ispac, et tout ce qui se trouve entre ces deux faits se fait à la main : merger du XML, mapper des variables d’environnement, et découvrir à la première exécution planifiée si la release a fonctionné.
Pourquoi SSIS résiste au CI/CD
- Un package est du XML qui se compare mal. Les coordonnées de mise en page, les GUID et la logique cohabitent dans le même fichier, donc un petit changement en paraît un gros et deux modifications d’un même package se mergent rarement sans risque.
- Les environnements sont des mappings. Dev, Test et Prod sont des variables d’environnement SSISDB et des mappings de paramètres, maintenus à la main et mis à jour avant chaque release.
- La release est un fichier, pas un diff. Déployer le .ispac remplace le projet. Ce qui a changé ne fait pas partie de ce qui est déployé, et le XML d’un package n’est pas quelque chose que l’outillage de revue peut contrôler dans une pull request, donc la validation attend la première exécution.
- Le rollback, c’est le fichier précédent. Revenir en arrière signifie redéployer le dernier .ispac et espérer que ses mappings correspondent encore. Ce que la release a déjà changé dans l’entrepôt n’en fait pas partie.
Rien de tout cela n’est la faute de SSIS. Il a été conçu avant que la livraison continue ne devienne la norme, et cela se voit.
Où la gestion des releases devrait se situer
- Dans le générateur. Si l’entrepôt vient d’un modèle, une release est la différence entre deux états de ce modèle, et l’outil sait de quoi chaque différence dépend.
- Avec le rollback inclus. Une release générée sait ce qu’elle a changé, donc son inverse existe avant qu’elle ne s’exécute.
- En versionnant l’intention, pas le XML. Git et Gitflow sur le modèle donnent un diff qui se lit comme un changement de l’entrepôt, pas comme un changement de mise en page de fichier.
Ce qui change avec Datavault Builder
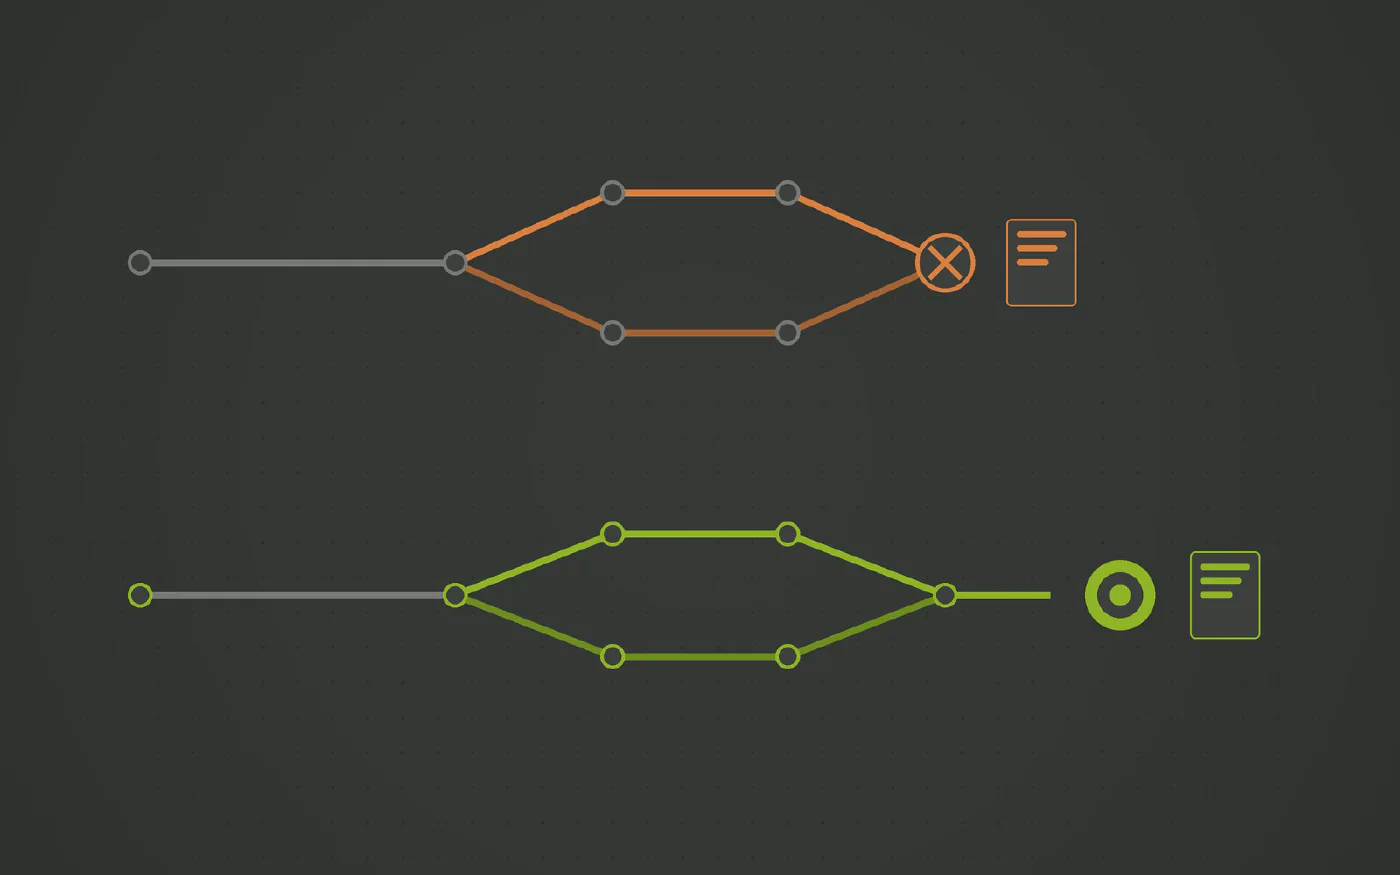
Datavault Builder génère des scripts de déploiement et de rollback versionnés par environnement à partir du modèle, avec le support de Git et Gitflow intégré. Une release commence par la comparaison de deux états : votre environnement local, un état dans Git, un autre environnement actif, un fichier zip ou un dossier ; vous choisissez ensuite les différences à déployer.
- Le problème du merge disparaît. Deux ingénieurs modifient le modèle sur deux branches et mergent un modèle, pas un fichier de package. Les chargements sont régénérés à partir du résultat.
- Les environnements sont un paramétrage, pas une table de mappings. Les détails de connexion par environnement sont définis une seule fois ; la release pour Test ou Prod est générée avec ces valeurs appliquées.
- Chaque release porte son rollback. Et la version du modèle à laquelle elle appartient.
- Les différences sont comparées avant le déploiement. Ce que Prod est sur le point de recevoir est la liste des différences entre son état et le vôtre. Sélectionnez un produit de données et l’outil propose le hub, le satellite, la table de staging et la source dont il a besoin.
- Votre outillage de pipeline reste en place. Azure DevOps ou GitHub Actions exécutent le package généré. Ils n’ont plus besoin de comprendre SSIS.
Ce qu’il faut décider
Auditez les journaux de déploiement du dernier trimestre et comptez deux choses : les releases qui ont nécessité un changement manuel de mapping d’environnement, et les merges de packages qui ont été réglés en refaisant le travail de quelqu’un. C’est la maintenance qu’une release générée supprime.
Voyez-le fonctionner sur l'une de vos sources
Réservez une démo gratuite et apportez le connecteur qui vous coûte le plus cher, en argent ou en temps.
Trois étapes vers un pipeline que vous maîtrisez
-
Séparer le modèle de la release
La structure de l’entrepôt est un modèle. Une release est un script généré pour un environnement, pas un projet maintenu à la main.
-
Générer la release
Datavault Builder compare deux états, sélectionne les différences à déployer, et propose les dépendances dont chacune a besoin. Le rollback est généré avec elle.
-
Comparer avant de déployer
Deux états quelconques peuvent être comparés : votre environnement local, un état dans Git, un autre environnement actif, un fichier zip ou un dossier.
Comment Datavault Builder supprime les frictions de l'ingestion
-
L'ingestion est intégrée
Chargements batch, delta et CDC depuis les bases de données, les fichiers, les API REST, les sources NoSQL et Python, les flux comme Kafka arrivant en micro-batches. La même plateforme qui génère le warehouse, sans seconde facture.
-
Votre schéma, pas celui du fournisseur
Les tables source sont mappées vers un modèle Data Vault 2.0 que vous avez conçu. Une nouvelle colonne ou une table renommée change un mapping, pas une chaîne de scripts post-chargement.
-
Seuls les deltas circulent
Les Hubs, Links et Satellites chargent ce qui a changé. Les rechargements complets restent en staging au lieu d’être retraités en aval chaque nuit.
-
L'historique est conservé par conception
Chaque changement est conservé tel qu’il arrive, donc le reporting historique fonctionne même là où la source écrase ses propres lignes.
-
Du code que vous n'écrivez jamais
Le chargement, l’historisation et la traçabilité sont générés depuis le modèle en temps réel et s’exécutent nativement sur Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle ou PostgreSQL.
-
Une plateforme, jusqu'à neuf outils en moins
Modélisation, ETL, CI/CD, documentation et traçabilité au même endroit. C’est ce qui rend possible les 14,7 minutes entre le besoin et la production.
Reconnu par BARC dans The Data Fabric Survey 26







Rencontrez notre expert
Vingt minutes avec notre Sales Director et une réponse honnête sur l’adéquation avec votre stack.

Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Les autres problèmes traités par cette série
-
Les limites de SSIS : porter les packages dans le cloud déplace la dette, pas le problème
Les parcs SSIS ont trois problèmes qu’une VM dans le cloud ne résout pas : un package par table que personne ne veut ouvrir, des releases que le DevOps n’atteint pas, et une conception qui s’arrête à SQL Server. L’Azure-SSIS Integration Runtime emmène les trois dans Azure intacts. Un modèle qui génère l’entrepôt les supprime à la place.
-
SSIS s'arrête-t-il là où commence votre entrepôt dans le cloud ?
SSIS a été conçu pour déplacer des données entre instances SQL Server on premises. Quand l’entrepôt part vers Fabric, Snowflake, Databricks ou BigQuery, les options sont de porter les packages sur un Azure-SSIS Integration Runtime, d’acheter des connecteurs tiers, ou de réécrire. Un modèle qui génère nativement pour la nouvelle plateforme est la quatrième option, et la seule qui n’emmène pas les packages avec elle.
-
Vos packages SSIS sont-ils plus nombreux que les gens capables de les comprendre ?
Des centaines de packages .dtsx, un par table, construits dans Visual Studio par celui qui avait le ticket, avec des control flows et des data flows qui ne s’ouvrent qu’un à la fois. Ajouter une colonne revient à ouvrir les packages un par un. La solution n’est pas un modèle de package. C’est un modèle qui génère les chargements, nativement sur SQL Server, Azure SQL ou Fabric.
Questions et réponses
- Si. Le problème est ce qui est versionné : un .dtsx est du XML où la mise en page et les GUID se mélangent à la logique, donc un diff affiche du bruit et le merge de deux modifications d’un même package est rarement sûr. Versionner un modèle, c’est versionner l’intention ; le code, lui, est régénéré.
- Des scripts de déploiement générés et adaptés à chaque environnement. Les détails de connexion par environnement sont définis une seule fois, et la release pour Test ou Prod est produite à partir du même modèle avec ces valeurs appliquées et le rollback inclus.
- Oui. Azure DevOps ou GitHub Actions exécutent le package généré. Ce qui disparaît, c’est l’étape de build du .ispac et les mappings de variables d’environnement maintenus à la main.