Data Vault のハブとは?
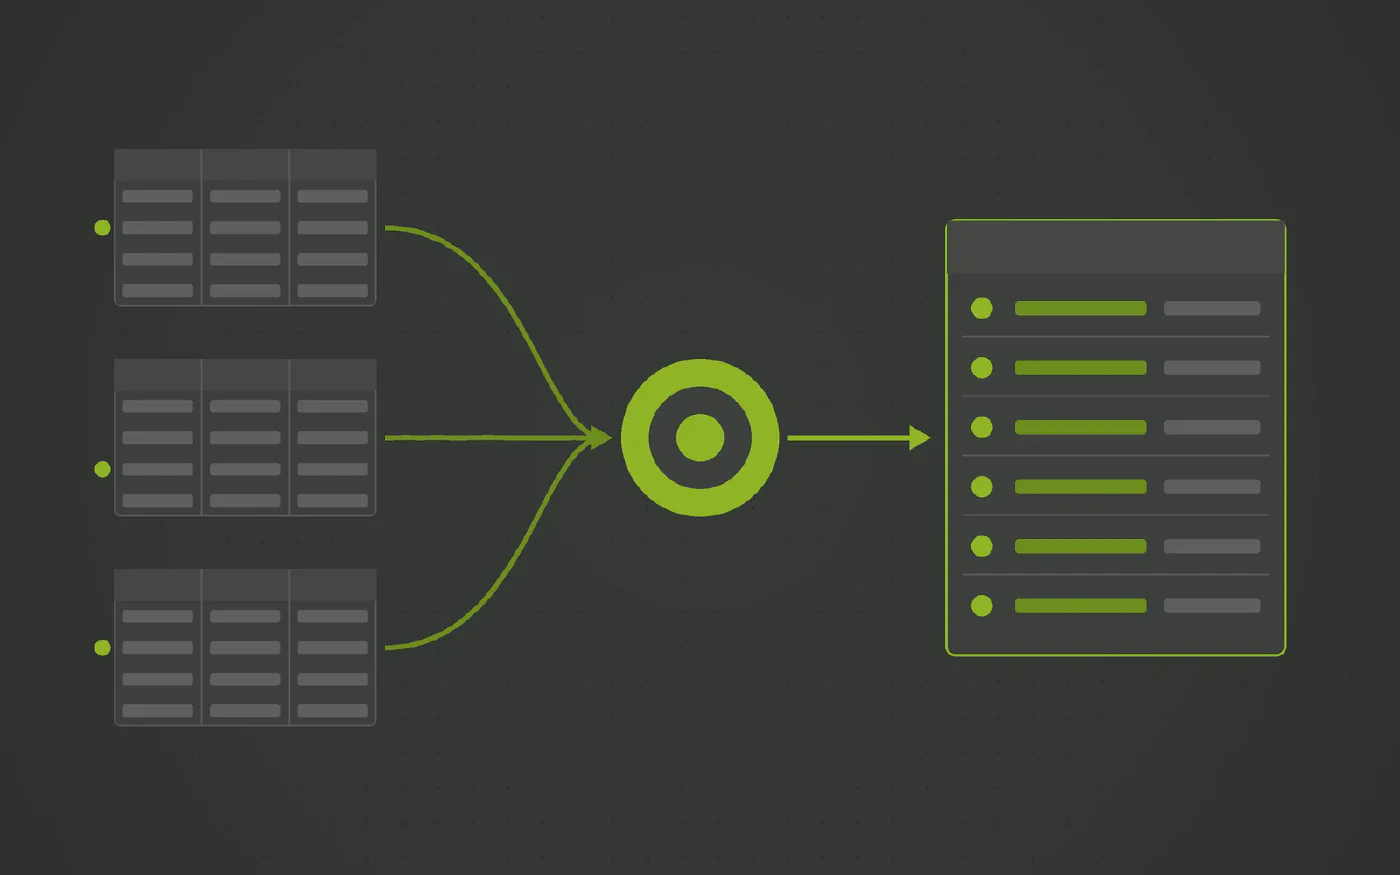
ハブは、顧客、製品、口座といったビジネス上の中核概念を、そのキーの一覧として表します。データウェアハウスがこれまでに受け取ったすべてのキーを、それぞれ一度だけ保持します。保存するのは状態ではなく識別情報であり、この割り切りによって、ハブはソースシステムごとのサイロが解消される場所になります。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション
このような課題はありませんか?
- 同じ顧客がデータウェアハウスにソースシステムごとに 1 件ずつ、計 3 件存在し、どのレコードが正しいのか誰にも分からない。
- ソースを追加するたびにキーを調整し直し、モデル全体の結合を書き直すことになる。
- ソースシステムがレコードの番号を振り直した結果、履歴の半分が一致しなくなった。
どのデータウェアハウスも、何よりも先に 1 つの問いに答えなければなりません。このビジネスが扱う対象は何か、そしてそれらをどのように区別するのか、という問いです。Data Vault では、その答えがハブです。
ハブとは何か
ハブは、顧客、製品、口座、契約といったビジネス上の中核概念を 1 つ表します。ソースシステムのテーブルのコピーではありません。顧客ハブには、データウェアハウスがこれまでにいずれかのソースから受け取ったすべての顧客キーが、それぞれ一度だけ格納されます。
ハブが保存するのは状態ではなく識別情報です。顧客を説明する情報は持ちません。氏名、住所、各種の記述属性はサテライトに格納され、顧客の受注や契約はリンクを介して結び付けられます。ハブが記録するのは、このキーが存在すること、データウェアハウスがいつ初めてそれを受け取ったか、そしてどこから来たかだけです。
従来のデータモデリングをご存じなら、ハブもすでにご存じのはずです
Data Vault は、データモデリングについて学んだことを置き換えるものではありません。それをそのまま活かします。出発点は、いずれにせよ作成する概念モデル、つまりビジネス上の概念とそれらの関係です。それぞれの概念、すなわち ER 図の各エンティティがハブになります。
第3正規形の典型的な Customer テーブルを例に取ります。
| 従来のモデル | 意味 | Data Vault では |
|---|---|---|
Customer エンティティ |
概念 | ハブ |
customer_number(自然主キー) |
識別情報 | ハブのビジネスキー |
name、address、segment |
記述属性 | サテライト |
store_id(外部キー) |
別の概念とのリレーションシップ | リンク |
失われるものはなく、新たに考え出すものもありません。エンティティは、すでにご存じの観点に沿って分割されるだけです。何がそれを識別し、何がそれを説明し、何と関係しているか、という観点です。ハブはこの 3 つの要素のうち最初のものです。だからこそハブを見つける作業は、優れた概念モデルを作るときに行う作業と同じになります。つまり、ビジネス上の概念と、それぞれの概念をどう識別するかについて合意することです。
ハブの構造
ハブのカラムは 4 つで、それ以上はありません。
- ハッシュキー: 主キーです。ビジネスキーのハッシュ(MD5 または SHA-256)として計算される決定論的なサロゲートキーで、2 つのソースが同じキーを別々のものに使う可能性がある場合は、任意で衝突回避用のコードを加えます。Datavault Builder では、この衝突回避用のコードを Business Key Prefix と呼びます。ハブを参照するすべてのテーブルは、ルックアップなしで同じ値を計算できます。
- ビジネスキー: ビジネスの世界でエンティティを識別するキーです。顧客番号、車両識別番号(VIN)、IBAN などが該当します。1 つのカラムの場合もあれば、会社コードと顧客番号を組み合わせた複合キーのように複数のカラムからなる場合もあります。
- Load Date: ビジネスキーが初めて Data Vault に登録された日時です。
- Record Source: そのキーを最初に提供した業務システムです。
Business Key Prefix:番号は同じでも、受注は別物
スイス子会社とドイツ子会社はそれぞれ独自の ERP システムを運用しており、どちらにも受注 1018 があります。これは別々の顧客から受けた、2 件の異なる受注です。受注番号だけでハッシュを計算すると、両者はハブの同じ行に入ってしまい、2 つのシステムがそれぞれの受注について持っている情報がすべて混ざってしまいます。
Business Key Prefix は両者を区別します。各ソースはハッシュ計算の前にキーにプレフィックスを付け、CH|1018 と DE|1018 とします。こうして受注ハブには、本来あるべき 2 行が格納されます。プレフィックスは、同じキーが本当に異なるものを意味しうる場合にだけ使ってください。グループ全体で共通の顧客番号のように、2 つのシステムが同じ意味でキーを共有している場合は、それらのキーはプレフィックスなしでハブの同じ行にマッピングすべきです。
ビジネスキーをトリムや大文字変換しない理由
ハッシュ計算の前にビジネスキーをトリムし、大文字に変換するという推奨がよく見られます。私たちはこれを推奨しません。そうすると c-10442 と C-10442 が同じ顧客として扱われ、末尾の空白も消えてしまいます。その違いがソース側の入力ミスであってもです。その結果、Vault は 2 件のエントリとそれぞれのリレーションシップを、誰にも気付かれないまま 1 つにまとめてしまいます。ハブはソースが提供したものをそのまま保持すべきです。2 つのキーが同じものを意味すると判断するのはビジネスルールであり、same-as リンクのような目に見える場所に置くべきものです。
一度書き込んだら、更新しない
ハブは追記専用です。ロードのたびに、受け取ったキーとハブにすでにあるキーを比較し、新しいキーだけを挿入します。一度登録されたビジネスキーは永久に残り、更新も削除もされません。
このルールから 2 つのことが言えます。ハブのロードはモデル内の他の何にも依存しないため、すべてのハブを並列にロードできます。また、ロードが失敗しても単純に再実行できます。同じ新しいキーが二重に挿入されることはないからです。
ソースシステムのサイロが解消される場所
ハブはモデルの統合ポイントです。CRM と ERP がどちらも同じ現実世界のビジネスキーで顧客を識別していれば、両者はハブの同じ行にマッピングされ、2 つのシステムがその顧客について持っている情報はすべてそこで結び付きます。
だからこそ、ビジネスキーをどう決めるかが、設計上の本当の判断になります。ビジネス部門がシステムをまたいで使っているキーが最善の選択です。ただし、それが常に使える形で手に入るとは限りません。ソースが自システム内の技術的な ID しか持っていないこともあれば、キーが再利用されていたり、形式が異なっていたり、古いレコードでは欠けていたりすることもあります。その扱い方は、このシリーズの別の記事「技術キー対ビジネスキー」で取り上げます。2 つのシステムが同じ顧客に異なるキーを使っている場合は、same-as リンクによって両者が同一であることを記録します。
ハブに決して含めてはいけないもの
- 説明的なコンテキスト: 氏名、住所、ステータス、金額はサテライトに格納します。属性を集め始めたハブは、実質的にはサテライトであり、安定性を失います。
- 外部キー: 顧客ハブの中の
Store_IDはリレーションシップであり、リレーションシップはリンクに属します。 - 概念のように見える属性: ステータス、カテゴリ、通貨コードは何かを説明するものであって、それ自体がビジネス上の概念ではありません。トランザクションは事情が異なります。Datavault Builder では、受注明細や支払いにはそれ専用のグレインハブを設けます。詳しくはリンクの記事で説明します。
- ソースごとのハブ: CRM、ERP、Web ショップごとに 1 つずつ、計 3 つの顧客ハブを作ると、データウェアハウスで解消するはずだったサイロをまた作ることになります。
- ソースシステムのサロゲートキー(避けられる場合): あるデータベースの
IDENTITYやAUTO_INCREMENTの値は、別のシステムでは何の意味も持ちません。ビジネスキーがあるなら使わないでください。ただし、それが手に入る中で最良のキーである場合もあります。たとえば、ソース側ですでに履歴化されているテーブルのバージョンや、他のどこからも参照されないトランザクションの最小粒度などです。そうした場合には、正しい選択になりえます。どのような場合かは、技術キー対ビジネスキーの記事で説明します。
Datavault Builder で何が変わるか
Datavault Builder では、概念を一度定義し、各ソースのビジネスキーを定義することで、すべてのソースをその概念にマッピングします。テーブル、キーの処理、ロードのコードはそこから自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL のいずれであっても、お使いのデータベース上でネイティブに実行されます。
- キーはコードのパターンではなく、モデル上の判断です: 何をもって顧客を識別するかは、ご自身で決めます。ハッシュ計算や挿入ロジックを書くことは、その判断には含まれません。
- 新しいソースは同じハブにマッピングされます: Web ショップを追加する場合も、その顧客番号を既存の顧客ハブにマッピングするだけで、新しいハブを作る必要はありません。
- パターンは毎回同じです: 手書きのハブのロード処理は、新しいソースが加わるたびにコピーされ、調整され、少しずつ変わっていきます。自動生成されたロード処理がパターンから外れることはありません。
判断すべきこと
自社のレポートが実際に扱っているビジネス上の概念を 5 から 10 ほど挙げ、それぞれについて、ビジネス部門がそれを識別するために使っているキーを書き出してください。2 つの部門から異なる答えが返ってきた場合や、使えるキーがまったくないソースがあった場合、そこにこそプロジェクトで最も価値のある統合作業があります。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
ハブを作る3つのステップ
-
概念を定義する
顧客、製品、受注といったビジネス上の中核概念に名前を付け、ソースがいくつあってもその概念に対してハブを 1 つだけモデリングします。
-
データを取得する
この概念を扱うソースシステムを接続し、そのテーブルをステージングにロードします。
-
ビジネスキーをマッピングする
各ソースのキーをハブにマッピングします。同じキーが異なる対象を指す場合は Business Key Prefix を付与します。ロード処理は自動生成されます。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得
専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。
Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
Data Vault における技術キーとビジネスキー
ソースシステムはビジネスキーをマスターレコードに保持していますが、リレーションシップはすべて技術キーで成り立っています。これに対処する 4 つの方法とそれぞれの代償、そして私たちが使っているパターンを紹介します。技術キー用の PSA ハブを設け、それをビジネスキーのハブにマッピングするパターンです。
-
Data Vault のビジネスキーとは?
ビジネスキーとは、従業員や顧客が実際に使っている識別子です。顧客番号、請求書番号、契約 ID などがこれに当たります。安定していて、システムをまたいで共有されており、Data Vault のすべてのハブはこのキーを土台に構築されます。
-
Data Vault のサテライトとは?
サテライトは、ハブを説明するすべての情報を保持します。名称、ステータス、金額、そしてそれらに対するすべての変更です。変更は追記され、更新されることはありません。UPDATE を使わない Slowly Changing Dimension タイプ2 であり、完全な監査証跡が最初から組み込まれています。
-
Data Vault のリンクとは?
リンクはビジネスキー間のリレーションシップを記録します。この受注はこの顧客のものである、といった関係です。Datavault Builder は Data Vault の従来型のリンクに対応するとともに、グレインハブを基点とするトランザクションリンクを備えています。トランザクションリンクはトランザクションの粒度を固定し、トランザクション同士を関連付けられるようにします。
よくあるご質問
- Dan Linstedt です。1990 年代にこの手法を開発し、2000 年ごろに公開しました。モデルにハッシュキー、方法論、アーキテクチャを加えた Data Vault 2.0 は 2013 年に登場しました。
- 標準的な参考書は、Dan Linstedt と Michael Olschimke による Building a Scalable Data Warehouse with Data Vault 2.0(Morgan Kaufmann、2015 年)です。
- いいえ。Bill Inmon は Data Vault を、第3正規形に基づくエンタープライズデータウェアハウスという自身の考え方を発展させたものと位置づけており、競合するアプローチとは見ていません。
- いいえ。ディメンショナルな出力は、多くの場合 Data Vault 実装の一部です。Vault が統合された履歴を保持し、その上にレポート用のスタースキーマを構築します。同じ Vault から、フラットなテーブルや Unified Star Schema を提供することもできます。
- 自動化を利用すれば、Data Vault の上に第3正規形のビューを完全に決定論的に生成できます。データは Vault に一度だけ保持され、3NF のレイヤーはモデルから導出されます。その仕組みはこちら。
- 自動化せずに取り組むことです。Data Vault は、少数の厳密で繰り返し現れるパターンの上に成り立っています。だからこそ手作業で書くと手間がかかり誤りも生じやすく、逆に生成するのは容易です。Datavault Builder を使うべき理由はそこにあります。
- はい。キー、リレーションシップ、履歴をハブ、リンク、サテライトに分けるため、正規化モデルやディメンショナルモデルよりもテーブルは多くなります。そのため物理レイヤーは、Datavault Builder のようなモデル駆動型のアプローチで抽象化すべきです。作業はビジネスモデルに対して行い、テーブルは自動生成されます。
- デモを予約して自社のソースで Data Vault が構築される様子をご覧いただくか、トレーニング環境を注文してご自身で試してみてください。
- Datavault Builder は年間ライセンスで、ソフトウェアを利用するためのサブスクリプションとして提供されます。永続ライセンスはご要望に応じてご用意します。各エディションとその内容は料金ページに掲載しています。