Data Vault のリンクとは?
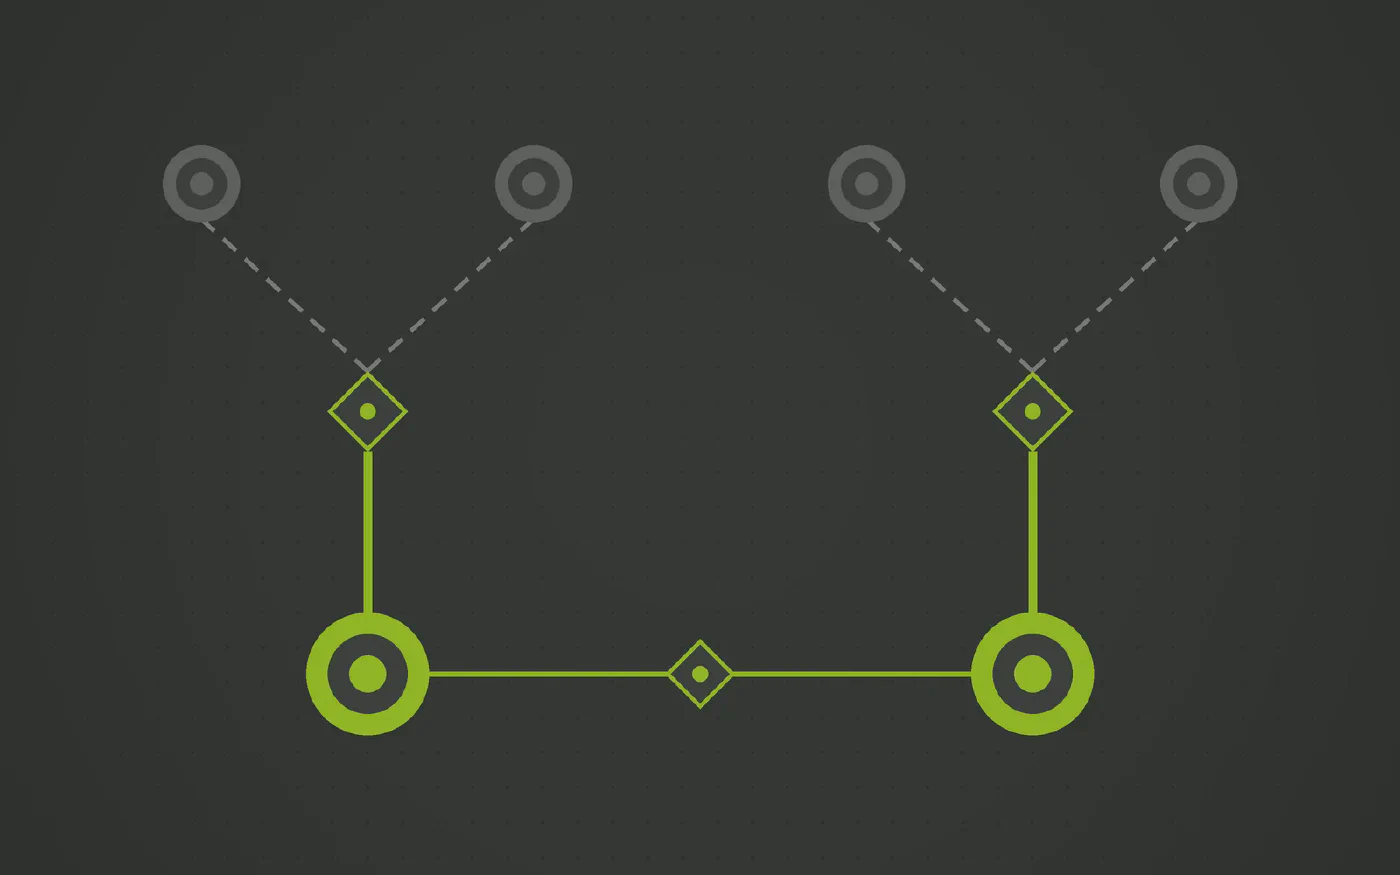
リンクはビジネスキー間のリレーションシップを記録します。この受注はこの顧客のものである、といった関係です。Datavault Builder は Data Vault の従来型のリンクに対応するとともに、グレインハブを基点とするトランザクションリンクを備えています。トランザクションリンクはトランザクションの粒度を固定し、トランザクション同士を関連付けられるようにします。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション
このような課題はありませんか?
- ソース側で顧客が変更された後、1 件の受注明細がリンクに 2 回現れ、どちらの行が現在のものか誰にも分からない。
- 請求書が請求対象の受注を参照する必要があるのに、モデルにはその 2 つをすっきりと結び付ける方法がない。
- ハブキーを 7 つ持つリンクがあり、読み解けるのは作成者本人だけになっている。
ハブを見れば、どのような顧客、製品、受注が存在するかが分かります。しかし、それらがどのように結び付いているかは分かりません。それを担うのがリンクです。
従来のモデリングの用語で言えば、リレーションシップがリンクになります。簡単に言うと、第3正規形モデルの外部キーがリンクの基礎です。Order テーブルが customer_id を持っている場合、Data Vault には受注ハブと顧客ハブを結ぶリンクがあります。
従来型のリンク
リンクはビジネスキー間のリレーションシップを記録します。この受注はこの顧客のものである、この契約はこの製品を対象としている、といった関係です。ハブと同様に、説明的なデータは保存しません。
リンクテーブルには次のカラムがあります。
- リンクハッシュキー: 主キーです。リンクが結ぶすべてのハブのビジネスキーから計算したハッシュです。
- ハブハッシュキー: 関係する各ハブにつき 1 カラムです。
- Load Date: リレーションシップが初めて確認された日時です。
- Record Source: そのリレーションシップを提供したシステムです。
リンクはハブと同じく挿入専用です。一度確認されたリレーションシップはリンクに残り続けます。それが現在も有効かどうかはエフェクティビティサテライトで扱う問題で、このシリーズの後の記事で取り上げます。
教科書どおりの Data Vault では、すべてのリンクを多対多としてモデリングします。そうしておけば、企業合併や新システムの導入によって一対多が多対多に変わっても、リンクを作り直す必要がないからです。ただし、構造が多対多であっても、データが多対多であるとは限りません。受注が別の顧客に移された場合、その受注が 2 人の顧客に属するようになったわけではありません。新しい顧客が古い顧客に置き換わったのです。リンクを正しく読むには、その主導側を知っておく必要があります。
Datavault Builder では、従来型のリンクは 2 つのハブを結ぶバイナリリンクであり、1:1、n:1、1:n、n:m のいずれかのカーディナリティを持ちます。カーディナリティによってリレーションシップのどちら側が主導側かが決まるため、主導側での変更はリレーションシップの追加ではなく、置き換えとして解釈されます。
従来のデータモデリングをご存じなら、リンクもすでにご存じのはずです
| 従来のモデル | Data Vault では |
|---|---|
| 2 つのエンティティ間の外部キー | 2 つのハブを結ぶバイナリリンク(カーディナリティ付き) |
| 属性を持たない関連テーブル | 多対多のリンク |
| 独自の属性を持つ関連テーブル | サテライト付きのハブとトランザクションリンク |
| 受注明細のように独自のキーを持つトランザクション | グレインハブとトランザクションリンク |
トランザクションリンク
トランザクションのために、Datavault Builder は 2 つ目の種類のリンクを備えています。受注明細、支払い、出荷明細といったトランザクションは複数のハブに同時に関係するため、従来の Data Vault ではトランザクションをそのままリンクに入れることがよくあります。場合によっては、依存子キー(dependent child key)を持つ非履歴化リンクとして扱います。この場合、粒度は暗黙的なものになります。たまたま行を一意にしているキーの組み合わせが、そのまま粒度になるのです。後でソースが受注明細を別の顧客に移すと、そのリンクには同じ明細について 2 行が存在することになり、どちらがトランザクションを表しているのかはモデルのどこにも示されません。
トランザクションリンクは粒度を明示します。トランザクションの最小粒度に専用のハブ、つまりグレインハブ(Hub_Sales_Order_Line、Hub_Payment_Transaction)を設け、リンクはそれを基点とします。これによってトランザクションリンクは 4 つの特性を持ち、それぞれに理由があります。
-
粒度が固定されている: 受注明細 1 件につきリンクのエントリは 1 件で、粒度がずれることはありません。
-
主導側が定義されている: グレインハブがリレーションシップの主導側です。受注明細に新しい製品が設定された場合、新しい製品が古い製品に置き換わります。明細が同時に 2 つの製品を指すようになるわけではありません。
-
識別関係と非識別関係: グレインハブはトランザクションの識別情報です。顧客、製品、店舗は参照として関与します。これは従来の ER モデリングと同じ区別です。
「キーを、キー全体を、そしてキーのみを。Codd に誓って。」 Codd の第3正規形を要約したこの古典的な言葉は、ここでも当てはまります。グレインハブはトランザクションのキーであり、それ以外のものはすべて、トランザクションを説明するか、別の概念を参照するかのどちらかです。
-
属性はハブに持たせる: 数量、価格、ステータスは、グレインハブ上の通常のサテライトに格納します。他のサテライトと同様に差分ロードでき、後から属性を追加してもモデルを作り直す必要はありません。Data Vault ではこの用途にリンクサテライトを使うこともできますが、私たちの経験では、ハブに持たせるほうが適しています。同じことは、顧客と契約の割り当てに付くロールや割合のように、属性を持つ関連テーブルにも当てはまります。
リンクからリンクへの参照という問題の解決
Data Vault の第一のルールは、リンクはハブ同士を結ぶというものです。リンクが別のリンクを参照することはできません。
しかし現実のトランザクションは、ごく日常的に別のトランザクションと関係しています。請求明細は出荷明細に対応し、支払いは請求書を決済し、返品は受注明細を参照します。従来の回避策は、すべてを 6 つ以上のハブキーを持つ 1 つの複合リンクにまとめてしまうことですが、これは読みにくく、ロードのたびに大きな作業単位(unit of work)が発生します。
トランザクションリンクを使えば、この問題はなくなります。すべてのトランザクションにはすでにグレインハブがあるため、2 つのトランザクション間のリレーションシップは、2 つのハブを結ぶ通常のリンクになります。
Hub_Delivery_Line ↔ Link_Delivery_To_Invoice ↔ Hub_Invoice_Line
リンクからリンクへの参照も、依存子キーによる回避策も必要なく、どのリンクも読み解ける大きさに収まります。
このパターンは 2017 年にさかのぼります。私が 『Data Vaultにおけるリンクの考察』 で初めて説明したもので、Data Vault 2.0 の標準との比較もそこで取り上げています。
Datavault Builder で何が変わるか
- 両方の種類のリンクを 1 つのモデルで: マスターデータ間のリレーションシップにはバイナリリンクを、リレーションシップがトランザクションである場合にはトランザクションリンクを使います。
- カーディナリティと粒度はモデル上の判断です: バイナリリンクのカーディナリティ、あるいは 1 件のトランザクションが何であるかを指定すれば、ツールがそこからリンクとそのロード処理を構築します。
- コードは自動生成されます: ハッシュキー、作業単位、挿入専用のロードは、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL のいずれでも、すべてのリンクで同じパターンに従います。
判断すべきこと
最も重要なトランザクションを 3 つ選び、それぞれについて、1 件の発生が何であるかを書き出してください。答えが明細番号や伝票番号ではなく、顧客、製品、日付の組み合わせになるなら、粒度は暗黙的です。そこが、トランザクションリンクによってモデルを安定させられる箇所です。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
リンクを作る3つのステップ
-
リレーションシップから始める
ソースモデルにある外部キーと関連テーブルは、すべて 2 つのハブ間のリンクの候補です。
-
カーディナリティを設定する
1:1、n:1、1:n、n:m のいずれかです。カーディナリティによって、リレーションシップのどちら側が主導側かが決まります。
-
トランザクションにはトランザクションリンクを使う
受注明細、支払い、出荷にはグレインハブとトランザクションリンクを設けます。ロード処理は Datavault Builder が自動生成します。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得
専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。
Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
Data Vault における技術キーとビジネスキー
ソースシステムはビジネスキーをマスターレコードに保持していますが、リレーションシップはすべて技術キーで成り立っています。これに対処する 4 つの方法とそれぞれの代償、そして私たちが使っているパターンを紹介します。技術キー用の PSA ハブを設け、それをビジネスキーのハブにマッピングするパターンです。
-
Data Vault のビジネスキーとは?
ビジネスキーとは、従業員や顧客が実際に使っている識別子です。顧客番号、請求書番号、契約 ID などがこれに当たります。安定していて、システムをまたいで共有されており、Data Vault のすべてのハブはこのキーを土台に構築されます。
-
Data Vault のサテライトとは?
サテライトは、ハブを説明するすべての情報を保持します。名称、ステータス、金額、そしてそれらに対するすべての変更です。変更は追記され、更新されることはありません。UPDATE を使わない Slowly Changing Dimension タイプ2 であり、完全な監査証跡が最初から組み込まれています。
-
Data Vault のハブとは?
ハブは、顧客、製品、口座といったビジネス上の中核概念を、そのキーの一覧として表します。データウェアハウスがこれまでに受け取ったすべてのキーを、それぞれ一度だけ保持します。保存するのは状態ではなく識別情報であり、この割り切りによって、ハブはソースシステムごとのサイロが解消される場所になります。
よくあるご質問
- Dan Linstedt です。1990 年代にこの手法を開発し、2000 年ごろに公開しました。モデルにハッシュキー、方法論、アーキテクチャを加えた Data Vault 2.0 は 2013 年に登場しました。
- 標準的な参考書は、Dan Linstedt と Michael Olschimke による Building a Scalable Data Warehouse with Data Vault 2.0(Morgan Kaufmann、2015 年)です。
- いいえ。Bill Inmon は Data Vault を、第3正規形に基づくエンタープライズデータウェアハウスという自身の考え方を発展させたものと位置づけており、競合するアプローチとは見ていません。
- いいえ。ディメンショナルな出力は、多くの場合 Data Vault 実装の一部です。Vault が統合された履歴を保持し、その上にレポート用のスタースキーマを構築します。同じ Vault から、フラットなテーブルや Unified Star Schema を提供することもできます。
- 自動化を利用すれば、Data Vault の上に第3正規形のビューを完全に決定論的に生成できます。データは Vault に一度だけ保持され、3NF のレイヤーはモデルから導出されます。その仕組みはこちら。
- 自動化せずに取り組むことです。Data Vault は、少数の厳密で繰り返し現れるパターンの上に成り立っています。だからこそ手作業で書くと手間がかかり誤りも生じやすく、逆に生成するのは容易です。Datavault Builder を使うべき理由はそこにあります。
- はい。キー、リレーションシップ、履歴をハブ、リンク、サテライトに分けるため、正規化モデルやディメンショナルモデルよりもテーブルは多くなります。そのため物理レイヤーは、Datavault Builder のようなモデル駆動型のアプローチで抽象化すべきです。作業はビジネスモデルに対して行い、テーブルは自動生成されます。
- デモを予約して自社のソースで Data Vault が構築される様子をご覧いただくか、トレーニング環境を注文してご自身で試してみてください。
- Datavault Builder は年間ライセンスで、ソフトウェアを利用するためのサブスクリプションとして提供されます。永続ライセンスはご要望に応じてご用意します。各エディションとその内容は料金ページに掲載しています。