Qu'est-ce qu'un hub dans Data Vault ?
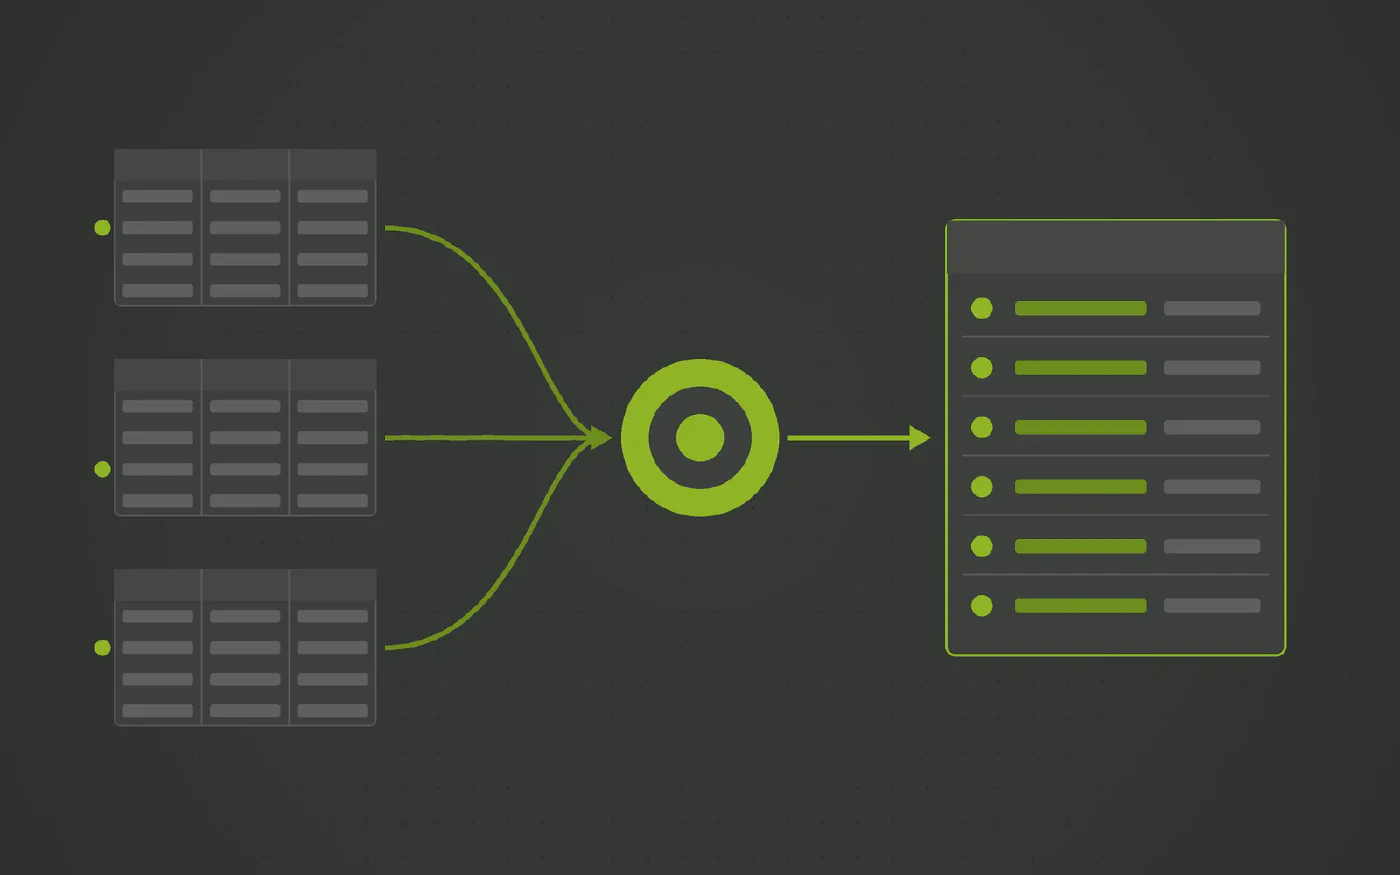
Un hub représente un concept métier central, comme le client, le produit ou le compte, sous la forme de la liste de ses clés : toutes celles que l'entrepôt a jamais reçues, chacune une seule fois. Il stocke l'identité, pas l'état, et c'est cette sobriété qui en fait le point où les silos des systèmes sources disparaissent.
La plateforme d'automatisation de data warehouse à laquelle les équipes data font confiance
Cela vous semble familier ?
- Le même client existe trois fois dans l'entrepôt, une fois par système source, et personne ne sait dire quel enregistrement est le bon.
- Chaque nouvelle source oblige à renégocier les clés et à réécrire les jointures dans tout le modèle.
- Un système source a renuméroté ses enregistrements, et la moitié de l'historique ne correspond plus.
Tout entrepôt de données doit répondre à une question avant toutes les autres : quels sont les objets dont parle cette entreprise, et comment les distingue-t-elle les uns des autres ? Dans Data Vault, la réponse est le hub.
Ce qu’est un hub
Un hub représente un concept métier central : client, produit, compte, contrat. Ce n’est pas la copie d’une table d’un système source. Le hub client contient chaque clé client que l’entrepôt ait jamais reçue, quelle qu’en soit la source, chacune une seule fois.
Un hub stocke l’identité, pas l’état. Il ne dit rien du client : le nom, l’adresse et le statut se trouvent dans des satellites, et les commandes et contrats du client sont rattachés par des links. Le hub enregistre seulement que cette clé existe, quand l’entrepôt l’a vue pour la première fois et d’où elle provient.
Si vous connaissez la modélisation classique, vous connaissez déjà le hub
Data Vault ne remplace pas ce que vous avez appris en modélisation de données. Il le réutilise. Partez du modèle conceptuel que vous établiriez de toute façon : les concepts métier et leurs relations. Chaque concept, chaque entité de votre diagramme entité-association, devient un hub.
Prenons une table Customer classique en troisième forme normale :
| Modèle classique | Ce que c’est | Dans Data Vault |
|---|---|---|
Entité Customer |
Le concept | Hub |
customer_number (clé primaire naturelle) |
L’identité | Business key dans le hub |
name, address, segment |
Les attributs descriptifs | Satellite |
store_id (clé étrangère) |
Une relation avec un autre concept | Link |
Rien n’est perdu et rien de nouveau n’est inventé. L’entité est découpée selon des axes que vous connaissez déjà : ce qui l’identifie, ce qui la décrit et ce à quoi elle est liée. Le hub correspond au premier de ces trois éléments. C’est pourquoi identifier les hubs revient à faire le travail qu’exige tout bon modèle conceptuel : s’accorder sur les concepts métier et sur la façon dont chacun est identifié.
L’anatomie d’un hub
Un hub comporte quatre colonnes, pas une de plus :
- Hash key. La clé primaire : une clé de substitution déterministe, obtenue en calculant le hash (MD5 ou SHA-256) de la business key, avec un code de collision facultatif lorsque deux sources peuvent utiliser la même clé pour des choses différentes. Dans Datavault Builder, ce code de collision s’appelle le Business Key Prefix. Chaque table qui référence le hub calcule la même valeur sans lookup.
- Business key. La clé qui identifie l’entité côté métier : un numéro de client, un VIN, un IBAN. Une seule colonne, ou plusieurs pour une clé composite, par exemple un code société et un numéro de client.
- Load Date. Le moment où la business key a été enregistrée pour la première fois dans le Data Vault.
- Record Source. Le système opérationnel qui a livré la clé en premier.
Le Business Key Prefix : même numéro, commande différente
Les filiales suisse et allemande exploitent chacune leur propre système ERP, et toutes deux ont
une commande 1018. Ce sont deux commandes différentes, passées par des clients différents. Si
le hash ne portait que sur le numéro de commande, elles se retrouveraient sur la même ligne du hub,
et tout ce que les deux systèmes savent d’elles serait mélangé.
Le Business Key Prefix les distingue. Chaque source ajoute son préfixe avant le calcul
du hash, CH|1018 et DE|1018, si bien que le hub commande contient deux lignes, comme il se
doit. Ne l’utilisez que là où la même clé peut réellement désigner des choses différentes.
Lorsque deux systèmes partagent une clé ayant la même signification, comme un numéro de client commun
à tout le groupe, ces clés doivent être mappées sur la même ligne du hub, sans préfixe.
Pourquoi nous ne touchons ni aux espaces ni à la casse de la business key
Une recommandation courante consiste à supprimer les espaces en début et en fin de business key et à la
passer en majuscules avant de calculer le hash. Nous ne le recommandons pas. Cela fait de c-10442 et
C-10442 le même client, et un espace en fin de chaîne disparaît aussi, même lorsque la
différence est une faute de frappe dans la source. Le vault fusionne alors deux entrées et leurs
relations en une seule sans que personne ne s’en aperçoive. Le hub doit conserver ce que la source
a livré : décider que deux clés signifient la même chose est une règle métier, et elle doit
figurer à un endroit visible, comme un same-as link.
Écrire une fois, ne jamais mettre à jour
Les hubs sont alimentés en insertion seule. Chaque chargement compare les clés entrantes avec celles déjà présentes dans le hub et insère les nouvelles. Une fois qu’une business key y figure, elle y reste définitivement : aucune mise à jour, aucune suppression.
Cette règle a deux conséquences. Le chargement d’un hub ne dépend de rien d’autre dans le modèle, donc tous les hubs peuvent être chargés en parallèle. Et un chargement en échec peut simplement être relancé, car il est impossible d’insérer deux fois les mêmes nouvelles clés.
Là où les silos des systèmes sources disparaissent
Le hub est le point d’intégration du modèle. Si le CRM et l’ERP identifient tous deux un client par la même business key du monde réel, les deux sont mappés sur la même ligne du hub, et tout ce que les deux systèmes savent de ce client s’y retrouve.
C’est pourquoi la business key est la véritable décision de conception. Une clé que l’entreprise utilise d’un système à l’autre est le meilleur choix. Elle n’est pas toujours disponible sous une forme exploitable : une source peut ne porter que son propre identifiant technique, ou une clé réutilisée, formatée différemment ou absente pour les enregistrements anciens. La manière de gérer ce cas fait l’objet d’un article dédié dans cette série : clés techniques versus clés métier. Lorsque deux systèmes utilisent des clés différentes pour le même client, un same-as link permet d’indiquer qu’elles correspondent au même client.
Ce qui n’a jamais sa place dans un hub
- Le contexte descriptif. Les noms, adresses, statuts et montants vont dans des satellites. Un hub qui accumule des attributs est un satellite déguisé, et il cesse d’être stable.
- Les clés étrangères. Un
Store_IDdans le hub client est une relation, et les relations ont leur place dans des links. - Les attributs qui se font passer pour des concepts. Un statut, une catégorie ou un code de devise décrit quelque chose : ce n’est pas un concept métier à part entière. Les transactions sont un cas différent : dans Datavault Builder, une ligne de commande ou un paiement reçoit son propre grain hub, comme l’explique l’article sur les links.
- Un hub par source. Trois hubs client, un pour le CRM, un pour l’ERP et un pour la boutique en ligne, reconstruisent les silos que l’entrepôt devait faire disparaître.
- Les clés de substitution des systèmes sources, quand vous pouvez les éviter. Une valeur
IDENTITYouAUTO_INCREMENTd’une base de données ne signifie rien dans un autre système : laissez-la de côté s’il existe une business key. Elle est pourtant parfois la meilleure clé disponible, par exemple pour les versions d’une table que la source historise déjà, ou pour le grain le plus fin d’une transaction que rien d’autre ne référence. Elle peut alors être le bon choix. L’article sur les clés techniques versus clés métier précise dans quels cas.
Ce qui change avec Datavault Builder
Dans Datavault Builder, vous définissez le concept une seule fois, puis vous y rattachez chaque source en définissant sa business key. La table, la gestion des clés et le code de chargement sont générés à partir de là et s’exécutent nativement sur votre base de données, qu’il s’agisse de Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle ou PostgreSQL.
- La clé est une décision de modélisation, pas un pattern de code. C’est vous qui décidez de ce qui identifie un client. Écrire le calcul du hash et la logique d’insertion ne fait pas partie de cette décision.
- Les nouvelles sources sont mappées sur le même hub. Ajouter la boutique en ligne consiste à mapper son numéro de client sur le hub client existant, pas à en construire un nouveau.
- Le pattern est identique à chaque fois. Un chargement de hub écrit à la main est copié, adapté et légèrement modifié à chaque nouvelle source : un chargement généré, lui, ne dérive pas.
Ce qu’il faut décider
Dressez la liste des cinq à dix concepts métier dont vos rapports parlent réellement et, pour chacun, notez la clé que l’entreprise utilise pour l’identifier. Là où deux services vous donnent des réponses différentes, ou là où une source n’a aucune clé exploitable, vous avez trouvé le travail d’intégration le plus précieux du projet.
Voyez-le fonctionner sur l'une de vos sources
Réservez une démo gratuite et apportez le connecteur qui vous coûte le plus cher, en argent ou en temps.
Trois étapes pour créer un hub
-
Définir le concept
Nommez le concept métier central, par exemple le client, le produit ou la commande, et modélisez un unique hub pour ce concept, quel que soit le nombre de sources.
-
Récupérer les données
Connectez les systèmes sources qui connaissent ce concept et chargez leurs tables dans le staging.
-
Mapper la business key
Mappez la clé de chaque source vers le hub, avec un Business Key Prefix lorsque la même clé désigne des choses différentes. Les chargements sont générés.
Comment Datavault Builder supprime les frictions de l'ingestion
-
L'ingestion est intégrée
Chargements batch, delta et CDC depuis les bases de données, les fichiers, les API REST, les sources NoSQL et Python, les flux comme Kafka arrivant en micro-batches. La même plateforme qui génère le warehouse, sans seconde facture.
-
Votre schéma, pas celui du fournisseur
Les tables source sont mappées vers un modèle Data Vault 2.0 que vous avez conçu. Une nouvelle colonne ou une table renommée change un mapping, pas une chaîne de scripts post-chargement.
-
Seuls les deltas circulent
Les Hubs, Links et Satellites chargent ce qui a changé. Les rechargements complets restent en staging au lieu d’être retraités en aval chaque nuit.
-
L'historique est conservé par conception
Chaque changement est conservé tel qu’il arrive, donc le reporting historique fonctionne même là où la source écrase ses propres lignes.
-
Du code que vous n'écrivez jamais
Le chargement, l’historisation et la traçabilité sont générés depuis le modèle en temps réel et s’exécutent nativement sur Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle ou PostgreSQL.
-
Une plateforme, jusqu'à neuf outils en moins
Modélisation, ETL, CI/CD, documentation et traçabilité au même endroit. C’est ce qui rend possible les 14,7 minutes entre le besoin et la production.
Reconnu par BARC dans The Data Fabric Survey 26
Rencontrez notre expert
Vingt minutes avec notre Sales Director et une réponse honnête sur l’adéquation avec votre stack.
Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Les autres problèmes traités par cette série
-
Clés techniques versus clés métier dans Data Vault
Les systèmes sources conservent la business key dans l’enregistrement de référence, mais toutes les relations reposent sur des clés techniques. Quatre façons de gérer cette situation, ce que coûte chacune, et le pattern que nous utilisons : un PSA hub pour les clés techniques, mappé sur le hub de la business key.
-
Qu'est-ce qu'une business key dans Data Vault ?
Une business key est l’identifiant que vos collaborateurs et vos clients utilisent réellement : le numéro de client, le numéro de facture, le numéro de contrat. Elle est stable, elle est partagée entre les systèmes, et c’est sur elle que repose chaque hub d’un Data Vault.
-
Qu'est-ce qu'un satellite dans Data Vault ?
Un satellite contient tout ce qui décrit un hub : noms, statuts, montants, ainsi que chacune de leurs modifications, ajoutées sans jamais être mises à jour. C’est une Slowly Changing Dimension de type 2 sans UPDATE, avec une piste d’audit complète intégrée.
-
Qu'est-ce qu'un link dans Data Vault ?
Un link enregistre une relation entre des business keys : cette commande appartient à ce client. Datavault Builder couvre le link Data Vault classique et y ajoute un link de transaction ancré sur un grain hub, qui fixe la granularité d’une transaction et permet de relier les transactions entre elles.
Questions et réponses
- Dan Linstedt. Il a développé la méthode dans les années 1990 et l’a publiée vers 2000. Data Vault 2.0, qui ajoute au modèle les hash keys, une méthodologie et une architecture, a suivi en 2013.
- L’ouvrage de référence est Building a Scalable Data Warehouse with Data Vault 2.0 de Dan Linstedt et Michael Olschimke (Morgan Kaufmann, 2015).
- Non. Bill Inmon considère Data Vault comme une évolution de sa vision de l’entrepôt de données d’entreprise en troisième forme normale, et non comme une approche concurrente.
- Non. Une couche de restitution dimensionnelle fait souvent partie d’une implémentation Data Vault : le vault conserve l’historique intégré, et les schémas en étoile sont construits au-dessus pour le reporting. Le même vault peut aussi fournir des tables plates ou un Unified Star Schema.
- Avec l’automatisation, une vue en troisième forme normale au-dessus d’un Data Vault peut être générée de manière entièrement déterministe. Le vault contient les données une seule fois, et la couche 3FN est dérivée du modèle. Comment cela fonctionne.
- S’y lancer sans automatisation. Data Vault repose sur un petit nombre de patterns stricts et répétitifs : c’est précisément ce qui le rend fastidieux et source d’erreurs quand on l’écrit à la main, et simple à générer. C’est pourquoi il vaut mieux utiliser Datavault Builder.
- Oui. Répartir les clés, les relations et l’historique entre hubs, links et satellites produit plus de tables qu’un modèle normalisé ou dimensionnel. C’est pourquoi la couche physique doit être masquée par une approche pilotée par le modèle comme Datavault Builder : vous travaillez sur le modèle métier, et les tables sont générées.
- Demandez une démo et voyez un Data Vault construit sur vos propres sources, ou commandez un environnement de formation pour l’essayer vous-même.
- Ici. Datavault Builder est une solution d’automatisation Data Vault : consultez les tarifs ou demandez une démo.
- Datavault Builder est concédé sous licence annuelle d’utilisation. Des licences perpétuelles sont disponibles sur demande. Les éditions et leur contenu figurent sur la page des tarifs.