Data Vault のサテライトとは?
サテライトは、ハブを説明するすべての情報を保持します。名称、ステータス、金額、そしてそれらに対するすべての変更です。変更は追記され、更新されることはありません。UPDATE を使わない Slowly Changing Dimension タイプ2 であり、完全な監査証跡が最初から組み込まれています。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション
このような課題はありませんか?
- 顧客の住所が変わったが、ロード処理が上書きしたため、以前の住所が消えてしまった。
- 毎日変わる残高のせいで、顧客の正式名称が毎晩新しい行に複製される。
- ソースでレコードが消えたため、データウェアハウスもそのレコードの履歴ごと削除してしまった。
ハブは何が存在するかを示します。リンクは物事がどのように結び付いているかを示します。しかし、どちらも名称、残高、ステータスは保存しません。それを担うのがサテライトです。
従来のモデリングの用語で言えば、エンティティの属性、つまりそのコンテキストがサテライトになります。Customer テーブルが customer_number と並んで name、address、segment を持っている場合、Data Vault では番号を顧客ハブに、属性をそのハブ上のサテライトに格納します。
サテライトとは何か
サテライトは、ハブの説明的な属性と、それらに対する経時的なすべての変更を保持します。顧客が転居しても、サテライトは住所を上書きしません。新しい行を追記し、古い行はそのまま残ります。各行には、Vault に入った日時と、それを提供したシステムが記録されるため、すべてのバージョンを追跡できます。
ディメンショナルモデリングをご存じであれば、サテライトは Slowly Changing Dimension タイプ2 に相当し、しかも UPDATE を一切実行しません。要望に応じて履歴化をオフにすることもでき、その場合は非履歴化サテライトになります。
サテライトの構造
| 構成要素 | カラム | 目的 |
|---|---|---|
| 親 | ハブのハッシュキー | この行が親ハブのどのエントリを説明しているか |
| 時刻と監査 | Load Date、Record Source | 行がいつ、どこから届いたか |
| ペイロード | 記述属性 | 番地、メールアドレス、金額、ステータス |
| 変更検知(任意) | ハッシュディフ | ペイロード全体に対する 1 つのハッシュ |
主キーは、親のハッシュキーと Load Date の組み合わせです。
ハッシュディフはルールではなく選択肢
教科書どおりの Data Vault では、変更を検知するためにすべてのサテライト行についてハッシュディフを計算するよう求めています。実際には、ロードの種類によって判断が分かれます。
- 差分ロード: 保存済みの行にはすでにハッシュがあるため、受け取った行だけをハッシュ化すればよく、負荷はわずかです。この場合はハッシュディフが有利です。
- フルロード: 実行のたびに数百万行をハッシュ化すると、大量のコンピュートリソースを消費します。最新のエンジンでは、カラムを直接比較する(
IS DISTINCT FROM)ほうが速いことがよくあります。 - 列数の多いテーブル: 列数の多いテーブルほどハッシュ化の恩恵が大きい、とよく言われます。実際にはむしろ逆に近く、行の幅が広いほど、ハッシュ化のための文字列連結が長くなります。
Datavault Builder は、ハッシュディフを必須ではなくオプションとしてサポートしています。ハッシュディフについては、このシリーズの別の記事で取り上げます。
トランザクションには専用のサテライトを
受注明細の数量、価格、金額は、トランザクションそのものを説明する情報です。リンクの記事で説明したように受注明細にグレインハブを設ければ、これらはそのグレインハブ上の通常のサテライトに格納され、他の属性と同様に履歴化されます。
サテライトの分割方法
- ソースシステム別: CRM と ERP のデータが 1 つの Raw サテライトを共有することはありません。各ソースは、それぞれのデータリネージをそのまま保持します。
- 変更頻度別: 日次の残高と正式名称を 1 つのサテライトに入れると、毎日、名称が新しい行に複製されます。変化の速い属性と遅い属性は分けるべきです。
- 機密性別: 氏名、メールアドレス、生年月日といった個人データは、個人を特定しない属性とは分けて、専用のサテライトに格納します。そうすれば、GDPR に関する報告で確認すべき場所が 1 か所に明確になり、アクセス制御や削除要求もそのサテライトだけに適用できます。
- 決して削除しない: ソースでレコードが消えても、その履歴は残ります。レコードトラッキングサテライトが、そのキーがもう提供されていないことを記録します。例外は、GDPR に基づく消去要求のように、情報の削除が法的に義務付けられている場合です。機密性別の分割が効果を発揮するのは、まさにこの場面です。
Datavault Builder で何が変わるか
モデル上でソースのカラムをサテライトにマッピングします。変更検知、追記専用のロード、監査用カラムは自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。従来のロードパターンでは対応できない 2 つの状況にも、標準で対応しています。
- バイテンポラルなロード: 日次締め処理を行う金融機関には、2 つの時間軸があります。ビジネス上ある事実が有効だった時点と、データウェアハウスがそれをロードした時点です。Datavault Builder は日次締めの履歴とロードの履歴をまとめて処理し、バイテンポラルなサテライトを作成します。仕組みについては 『バイテンポラル(二重時間軸)データ処理の実践』 をご覧ください。バイテンポラル性についても、このシリーズの別の記事で取り上げます。
- 1 回のロードに複数の変更がある場合: データレイクは、同じレコードの複数のバージョンを 1 つのバッチでまとめて提供することがよくあります。従来のパターンでは、1 回の実行でキーごとに 1 つの変更しかロードしないため、データをループ処理する必要があり、しかもすべてのバージョンにロード時点の日時が付いてしまいます。Datavault Builder はすべての変更を 1 つのバッチでロードし、各レコードを、データレイクが記録した時点に従って時間軸上に配置します。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
サテライトを作る3つのステップ
-
1 つのハブだけに紐付ける
各サテライトはちょうど 1 つのハブを説明し、そのハブのハッシュキーと Load Date をキーとします。
-
必要に応じて適切に分割する
役立つ場合には、ソースシステム別、変更頻度別、または機密性別(個人データを分離)に分割します。
-
ロード処理は自動生成に任せる
Datavault Builder は、すべてのサテライトについて変更検知と追記専用のロード処理を自動生成します。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得
専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。
Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
Data Vault における技術キーとビジネスキー
ソースシステムはビジネスキーをマスターレコードに保持していますが、リレーションシップはすべて技術キーで成り立っています。これに対処する 4 つの方法とそれぞれの代償、そして私たちが使っているパターンを紹介します。技術キー用の PSA ハブを設け、それをビジネスキーのハブにマッピングするパターンです。
-
Data Vault のビジネスキーとは?
ビジネスキーとは、従業員や顧客が実際に使っている識別子です。顧客番号、請求書番号、契約 ID などがこれに当たります。安定していて、システムをまたいで共有されており、Data Vault のすべてのハブはこのキーを土台に構築されます。
-
Data Vault のリンクとは?
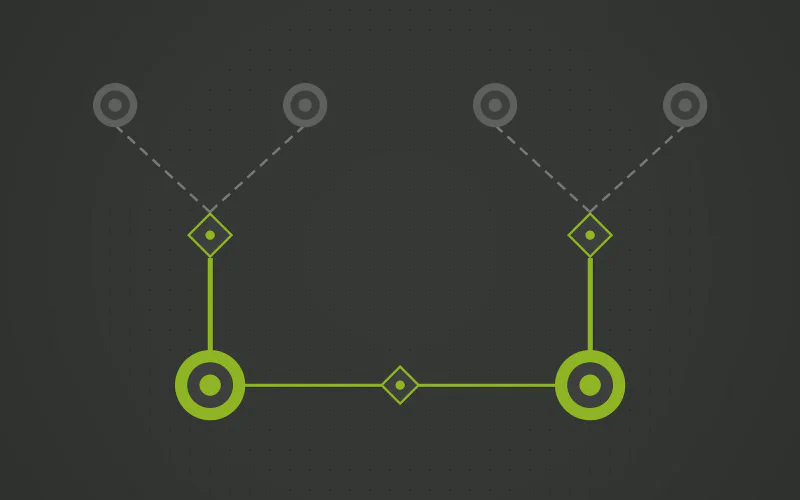
リンクはビジネスキー間のリレーションシップを記録します。この受注はこの顧客のものである、といった関係です。Datavault Builder は Data Vault の従来型のリンクに対応するとともに、グレインハブを基点とするトランザクションリンクを備えています。トランザクションリンクはトランザクションの粒度を固定し、トランザクション同士を関連付けられるようにします。
-
Data Vault のハブとは?
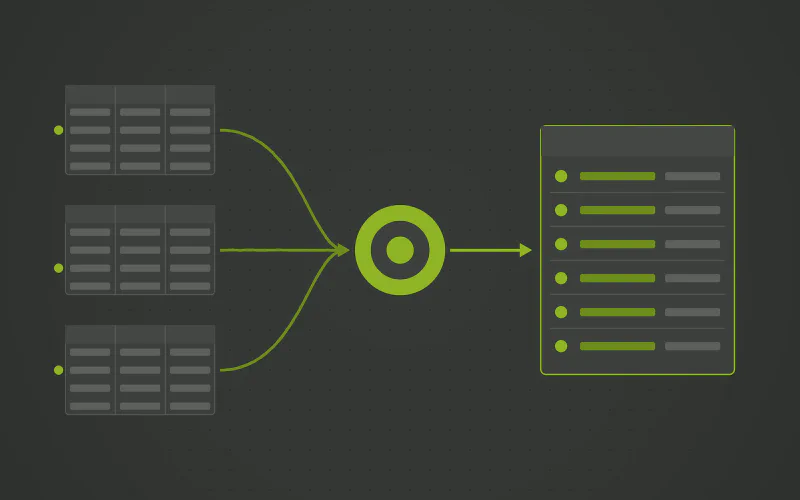
ハブは、顧客、製品、口座といったビジネス上の中核概念を、そのキーの一覧として表します。データウェアハウスがこれまでに受け取ったすべてのキーを、それぞれ一度だけ保持します。保存するのは状態ではなく識別情報であり、この割り切りによって、ハブはソースシステムごとのサイロが解消される場所になります。
よくあるご質問
- Dan Linstedt です。1990 年代にこの手法を開発し、2000 年ごろに公開しました。モデルにハッシュキー、方法論、アーキテクチャを加えた Data Vault 2.0 は 2013 年に登場しました。
- 標準的な参考書は、Dan Linstedt と Michael Olschimke による Building a Scalable Data Warehouse with Data Vault 2.0(Morgan Kaufmann、2015 年)です。
- いいえ。Bill Inmon は Data Vault を、第3正規形に基づくエンタープライズデータウェアハウスという自身の考え方を発展させたものと位置づけており、競合するアプローチとは見ていません。
- いいえ。ディメンショナルな出力は、多くの場合 Data Vault 実装の一部です。Vault が統合された履歴を保持し、その上にレポート用のスタースキーマを構築します。同じ Vault から、フラットなテーブルや Unified Star Schema を提供することもできます。
- 自動化を利用すれば、Data Vault の上に第3正規形のビューを完全に決定論的に生成できます。データは Vault に一度だけ保持され、3NF のレイヤーはモデルから導出されます。その仕組みはこちら。
- 自動化せずに取り組むことです。Data Vault は、少数の厳密で繰り返し現れるパターンの上に成り立っています。だからこそ手作業で書くと手間がかかり誤りも生じやすく、逆に生成するのは容易です。Datavault Builder を使うべき理由はそこにあります。
- はい。キー、リレーションシップ、履歴をハブ、リンク、サテライトに分けるため、正規化モデルやディメンショナルモデルよりもテーブルは多くなります。そのため物理レイヤーは、Datavault Builder のようなモデル駆動型のアプローチで抽象化すべきです。作業はビジネスモデルに対して行い、テーブルは自動生成されます。
- デモを予約して自社のソースで Data Vault が構築される様子をご覧いただくか、トレーニング環境を注文してご自身で試してみてください。
- Datavault Builder は年間ライセンスで、ソフトウェアを利用するためのサブスクリプションとして提供されます。永続ライセンスはご要望に応じてご用意します。各エディションとその内容は料金ページに掲載しています。