¿Sigue ejecutando SSIS sobre una máquina con licencia de SQL Server solo para cargar datos en Snowflake o en la nube?
SQL Server Integration Services (SSIS) se diseñó para el ecosistema on-premises de Microsoft. Utilizarlo para alimentar data warehouses en la nube como Snowflake, Databricks o Fabric implica servidores intermedios dedicados, conectores de terceros y licencias innecesarias de SQL Server. La solución es generar cargas nativas en el motor de destino.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- Cargar desde un origen o hacia un destino que no sea de Microsoft exige adquirir y mantener conectores ODBC/OLE DB de terceros con sus propias licencias y ciclos de parches.
- El servidor de integración requiere una licencia dedicada de SQL Server para ejecutar una carga de trabajo que no almacena datos de negocio.
- Las transformaciones ocurren en la memoria del servidor de SSIS antes de volcarse en la nube, lo que crea un embudo en la red y limita el rendimiento.
- La arquitectura global está migrando a Snowflake, Databricks o Fabric, pero la capa de datos continúa anclada a herramientas de hace dos décadas.
SQL Server Integration Services (SSIS) fue una solución extraordinaria para la era de los data warehouses locales basados en Microsoft SQL Server. Estaba profundamente optimizado para mover datos a través de buffers de memoria compartida dentro del mismo entorno de base de datos.
El panorama actual es radicalmente diferente: las organizaciones modernas almacenan y analizan sus datos en plataformas analíticas en la nube como Snowflake, Databricks, BigQuery o Microsoft Fabric.
Por qué SSIS se queda corto en la era del cloud
- El servidor ETL actúa como un cuello de botella innecesario. SSIS extrae filas del sistema de origen, las traslada a la memoria de un servidor intermedio para aplicar transformaciones (ordenaciones, búsquedas, derivaciones) y finalmente las envía a través de la red hacia el destino en la nube. Este patrón ETL clásico desperdicia ancho de banda y desaprovecha la potencia de cálculo de los data warehouses modernos.
- Licencias y mantenimiento adicionales. SSIS requiere una instancia licenciada de SQL Server para ejecutarse. Mantener una máquina dedicada exclusivamente a ejecutar paquetes obliga a pagar licencias, aplicar parches del sistema operativo y administrar infraestructura, sin aportar valor analítico directo.
- Fragilidad con conectores no Microsoft. Conectar SSIS a orígenes modernos o a data warehouses en la nube exige instalar controladores ODBC, adaptadores de terceros o componentes personalizados que complican la actualización y el soporte a largo plazo.
Del ETL en servidor intermedio al ELT nativo
La arquitectura analítica moderna descarta el procesamiento en servidores de tránsito:
- Carga directa (Extract & Load). Los datos en bruto se depositan en staging dentro del propio data warehouse o en almacenamiento de objetos en la nube (S3, ADLS).
- Transformación en el motor (Transform). Toda la integración, deduplicación, historización y generación de data marts se ejecuta directamente en el motor de datos mediante sentencias SQL basadas en conjuntos.
- Eliminación de la máquina intermedia. Sin servidores de ejecución de paquetes, sin buffers de memoria limitados y sin licencias adicionales de SQL Server.
Modernización con Datavault Builder
Datavault Builder proporciona un camino directo para dejar atrás las limitaciones de SSIS:
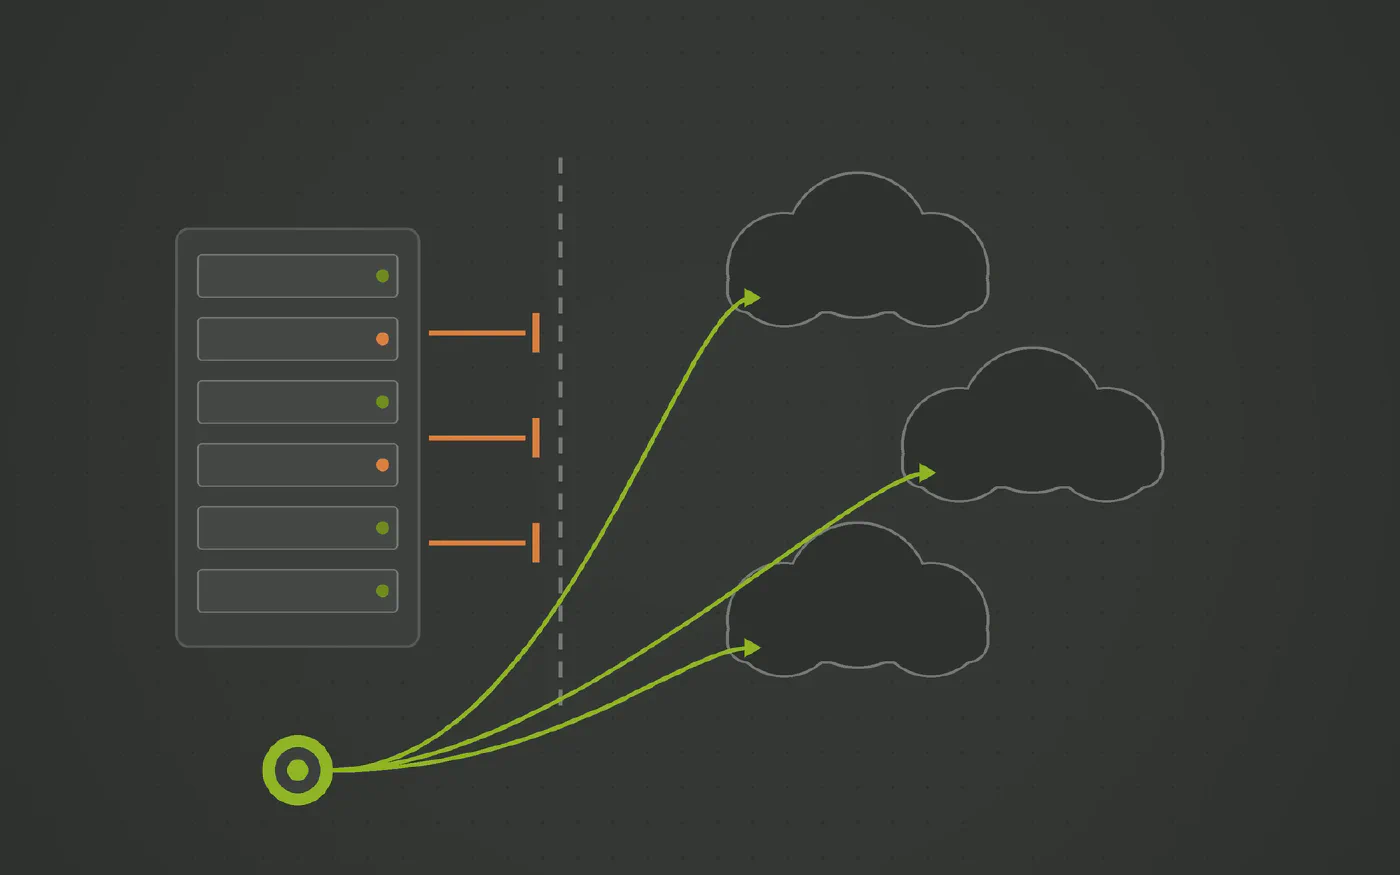
- Ejecución nativa (pushdown). El código de carga generado se ejecuta en el destino que usted elija: Snowflake, Databricks, Fabric, Azure SQL o PostgreSQL.
- Sin servidores intermedios de transformación. Elimine la infraestructura de SSIS y los costes de licencia asociados.
- Libertad para evolucionar. Si su empresa decide migrar de SQL Server on-premises a Snowflake o Fabric, el modelo de datos permanece intacto; Datavault Builder se limita a generar el código adaptado a la nueva sintaxis del motor de destino.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Identificar la dependencia del servidor SSIS
Evalúe los recursos y licencias dedicados exclusivamente a la máquina de SSIS y determine cuántos flujos terminan en destinos modernos.
-
Reemplazar ETL en memoria por ELT nativo
Cargue los datos directamente en el almacenamiento de destino y aproveche la potencia de computación del motor analítico moderno.
-
Generar el data warehouse a partir de un modelo independiente
Modele la lógica de negocio en una plataforma que compile código nativo para el motor que su empresa elija hoy o en el futuro.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
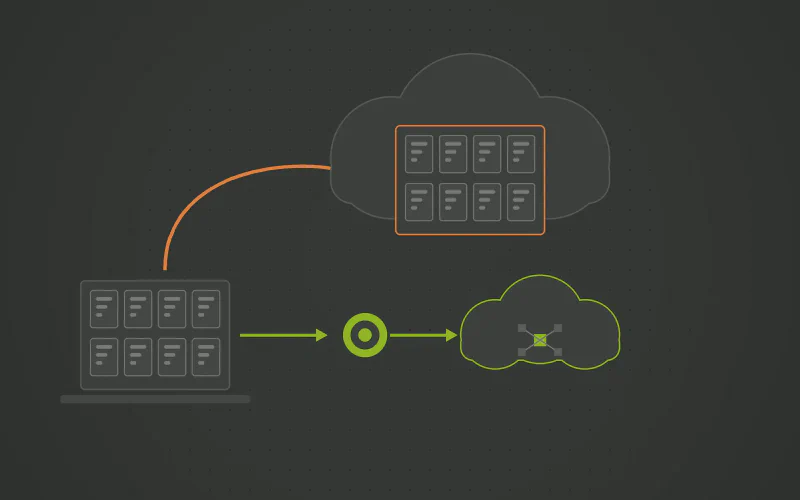
¿Está pensando en migrar sus paquetes SSIS a la nube mediante lift-and-shift?
Los proyectos heredados de SSIS arrastran tres problemas que una máquina virtual en la nube no resuelve: un paquete por tabla que nadie quiere tocar, releases ajenas a DevOps y un diseño ligado a SQL Server. Azure-SSIS Integration Runtime traslada los tres intactos a la nube. Un modelo que genere el data warehouse los hace innecesarios.
-
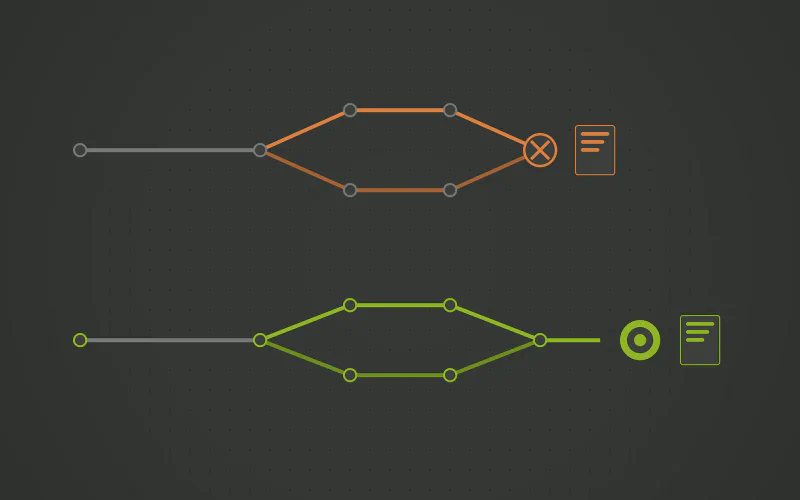
¿Es SSIS la única pieza de su stack técnico que sigue sin poder integrarse en CI/CD?
Un archivo .dtsx es código XML que se compara mal y se fusiona peor en Git; si dos ingenieros tocan el mismo paquete, suele terminar en reconstrucción manual. Los entornos residen en mapeos de variables de SSISDB que se mantienen a mano. Las releases deberían generarse a partir de un modelo, entorno por entorno, con rollback incluido.
-
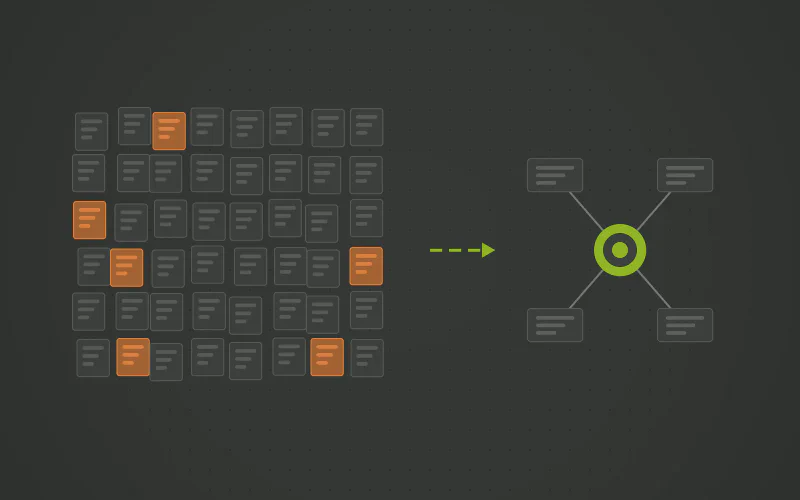
¿Hay más paquetes SSIS en su empresa que personas capaces de entenderlos?
Cientos de paquetes .dtsx, uno por cada tabla, construidos en Visual Studio por quien tuviera la tarea asignada en cada momento, con flujos de control y flujos de datos que solo se abren de uno en uno. Añadir una columna obliga a abrir los paquetes uno a uno. La solución no es una plantilla de paquetes, sino un modelo que genere las cargas, de forma nativa en SQL Server, Azure SQL o Fabric.
Preguntas y respuestas
- Ejecuta los paquetes existentes en Azure sin modificarlos, lo que traslada el problema a la nube en lugar de solucionarlo: el diseño de un paquete por tabla, el buffer de memoria y los conectores heterogéneos se mantienen. Es un puente provisional: la propia dirección estratégica de Microsoft apunta hacia Fabric Data Factory, no hacia SSIS en la nube.
- Genera código de carga nativo basado en conjuntos para Snowflake, Databricks, Google BigQuery, Microsoft Fabric, Azure Synapse, Azure SQL, PostgreSQL, Oracle y SQL Server, sin servidores intermedios de transformación.
- Entonces el almacén generado se ejecuta sobre SQL Server o Azure SQL, y la modernización se enfoca en el ETL, no en la plataforma de base de datos. Dar el salto a Fabric más adelante será simplemente un cambio de destino en la configuración.