¿Es SSIS la única pieza de su stack técnico que sigue sin poder integrarse en CI/CD?
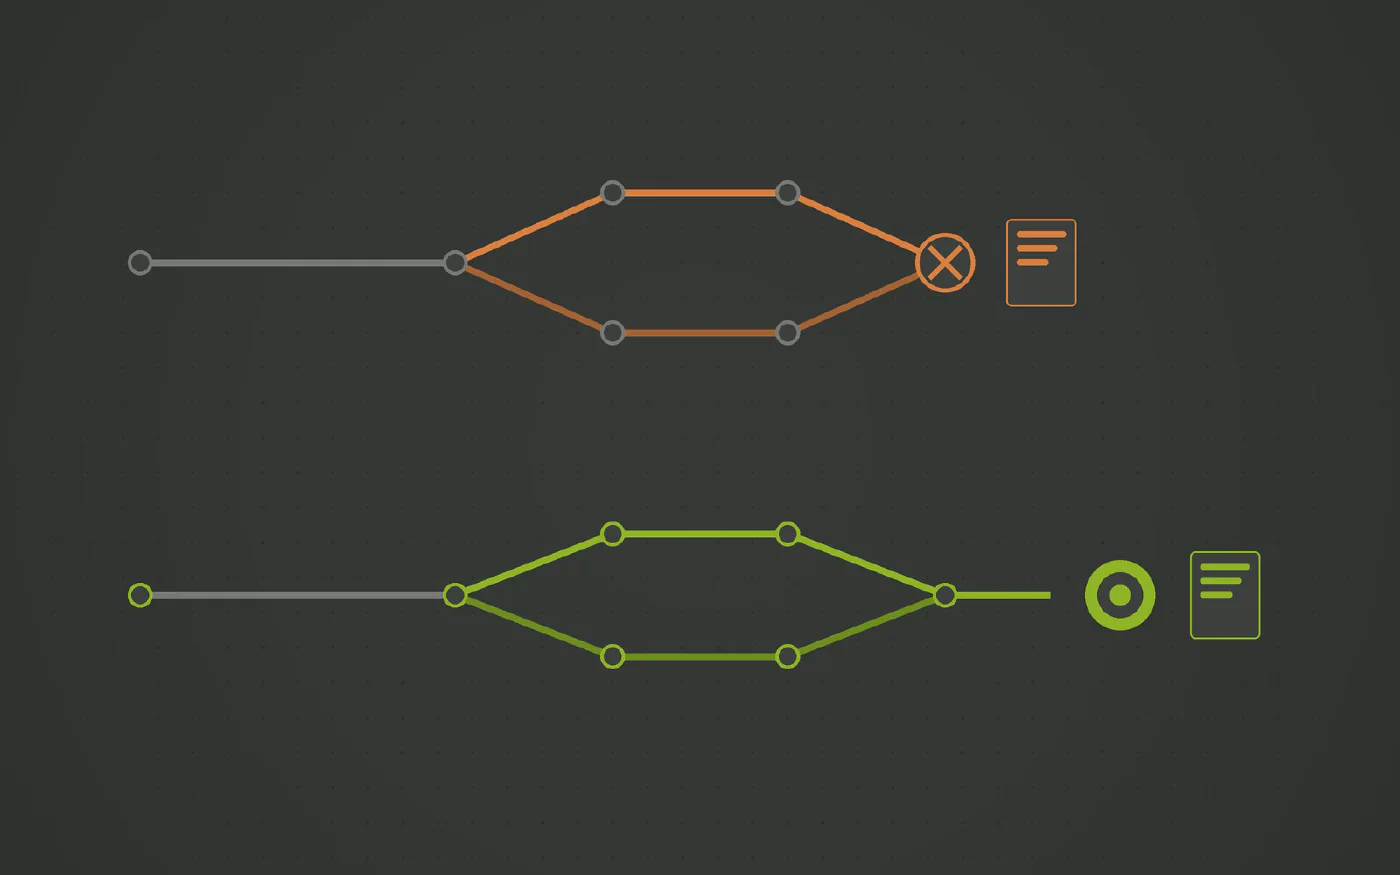
Un archivo .dtsx es código XML que se compara mal y se fusiona peor en Git; si dos ingenieros tocan el mismo paquete, suele terminar en reconstrucción manual. Los entornos residen en mapeos de variables de SSISDB que se mantienen a mano. Las releases deberían generarse a partir de un modelo, entorno por entorno, con rollback incluido.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- El pipeline de release despliega el archivo `.ispac`, y solo se sabe si ha funcionado cuando se ejecuta el primer trabajo.
- Para aplicar un rollback hay que rescatar el archivo `.ispac` anterior y confiar en que los mapeos de variables de entorno sigan coincidiendo.
- Dos desarrolladores modificaron el mismo paquete en ramas distintas de Git y el merge de los archivos XML resultó inviable, de modo que se conservó uno de los cambios y hubo que rehacer el otro a mano.
- Pasar los paquetes de Dev a Test y a Prod exige reconfigurar a mano las cadenas de conexión y las variables en la base de datos SSISDB.
En la ingeniería de software moderna, las prácticas de CI/CD (integración y entrega continuas) son la norma: control de versiones transparente, revisiones de código mediante diffs claros, pruebas automatizadas y despliegues incrementales con rollback incluido.
Para muchos equipos de datos, los proyectos de SSIS representan la excepción a estas prácticas.
Por qué SSIS se resiste a la integración continua
- Los paquetes
.dtsxson XML monolítico. Visual Studio guarda en un único archivo la posición de las cajas, los colores, los GUIDs internos y la lógica de flujo. Inspeccionar un pull request en GitHub o Azure DevOps muestra sobre todo ruido técnico, entre el que cuesta identificar el cambio real de negocio. - Los conflictos de merge rara vez se resuelven sin perder trabajo. Si dos ingenieros trabajan simultáneamente en el mismo paquete en ramas distintas, fusionar sus cambios en Git resulta casi inviable. En la mayoría de los casos, uno de los desarrolladores tiene que rehacer su trabajo a mano.
- Un despliegue reemplaza todo el proyecto. El formato estándar (
.ispac) sustituye el proyecto entero en el servidor. No existe la noción de entrega incremental de cambios. - El rollback es volver a desplegar un archivo antiguo. Revertir un error implica desplegar
de nuevo el archivo
.ispacprevio y comprobar que los entornos de ejecución y los parámetros de SSISDB sigan siendo compatibles.
Dónde debe residir el control de versiones
El fallo no está en los desarrolladores; está en versionar artefactos de diseño gráfico en lugar de intenciones arquitectónicas:
- Versionar la intención de negocio. Lo que debe guardarse en Git es la definición del modelo: qué entidades existen, qué satélites se añaden y qué reglas de cálculo se aplican.
- Diffs legibles para una persona. Una revisión de código debe mostrar claramente: “se añadió el atributo FechaNacimiento al satélite Cliente”, no páginas de metadatos XML.
- Generación de releases por entorno. El paquete para Test o Prod debe ser un script SQL generado a partir de la comparación entre el estado del modelo y el del entorno de destino.
Qué cambia con Datavault Builder
Datavault Builder incorpora soporte nativo para Git y Gitflow diseñado específicamente para la gestión de releases de data warehouse:
- Diferencias comprensibles. Las revisiones de código en Git muestran cambios semánticos en el modelo de datos, de modo que el equipo puede revisarlos con seguridad.
- Releases generadas por comparación. Seleccione dos estados (por ejemplo, su rama de desarrollo frente al entorno de Test) y la herramienta generará el script de migración con todas las dependencias resueltas.
- Rollback generado automáticamente. Cada release incorpora su correspondiente script inverso para devolver la base de datos a su estado anterior en caso de incidencia.
- Automatización en sus pipelines actuales. Integre los scripts generados en sus flujos existentes de Azure DevOps o GitHub Actions.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Separar la lógica del formato XML
La intención de negocio no debe residir en coordenadas visuales ni identificadores GUID mezclados en un archivo XML.
-
Versionar el modelo, no el paquete
Utilice Git sobre un modelo conceptual que produzca diferencias legibles y comprensibles en las revisiones de código.
-
Generar scripts de despliegue deterministas
Genere scripts SQL específicos para cada entorno, con sus variables ya aplicadas y con el script de rollback incluido.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
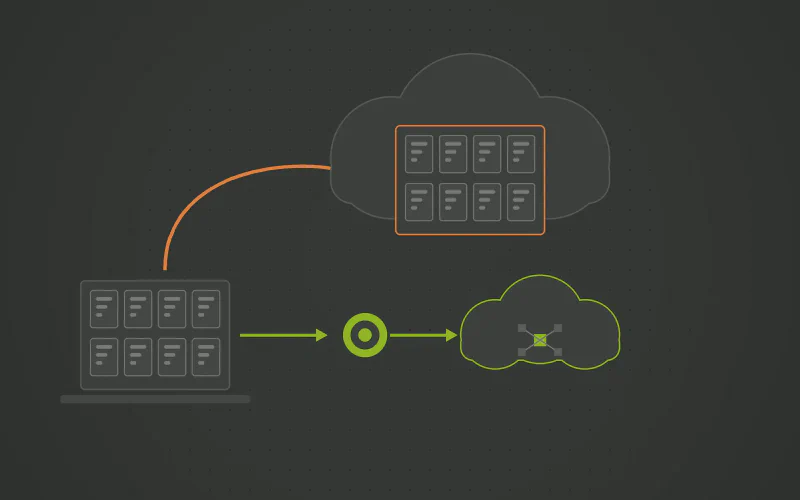
¿Está pensando en migrar sus paquetes SSIS a la nube mediante lift-and-shift?
Los proyectos heredados de SSIS arrastran tres problemas que una máquina virtual en la nube no resuelve: un paquete por tabla que nadie quiere tocar, releases ajenas a DevOps y un diseño ligado a SQL Server. Azure-SSIS Integration Runtime traslada los tres intactos a la nube. Un modelo que genere el data warehouse los hace innecesarios.
-
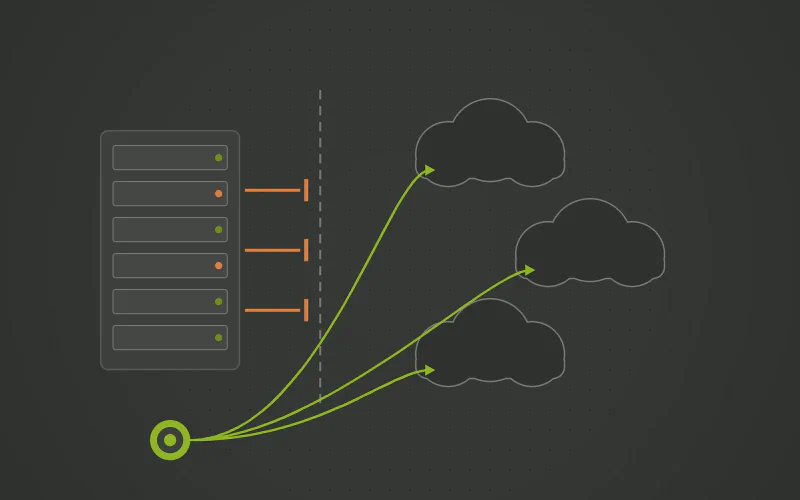
¿Sigue ejecutando SSIS sobre una máquina con licencia de SQL Server solo para cargar datos en Snowflake o en la nube?
SQL Server Integration Services (SSIS) se diseñó para el ecosistema on-premises de Microsoft. Utilizarlo para alimentar data warehouses en la nube como Snowflake, Databricks o Fabric implica servidores intermedios dedicados, conectores de terceros y licencias innecesarias de SQL Server. La solución es generar cargas nativas en el motor de destino.
-
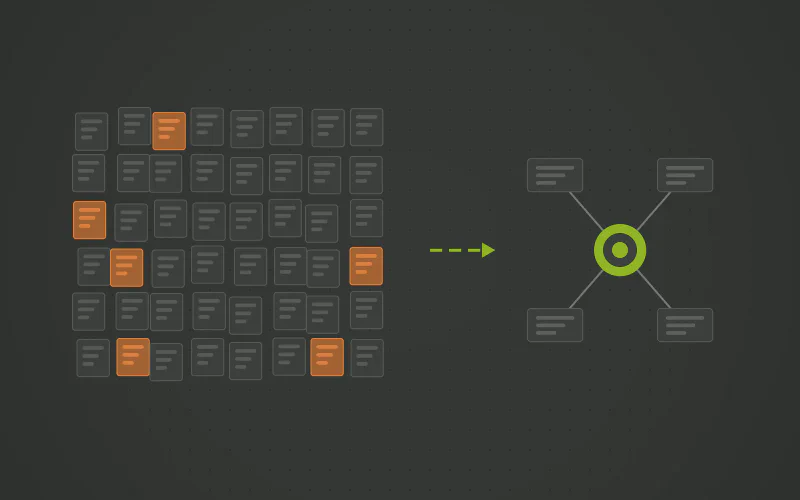
¿Hay más paquetes SSIS en su empresa que personas capaces de entenderlos?
Cientos de paquetes .dtsx, uno por cada tabla, construidos en Visual Studio por quien tuviera la tarea asignada en cada momento, con flujos de control y flujos de datos que solo se abren de uno en uno. Añadir una columna obliga a abrir los paquetes uno a uno. La solución no es una plantilla de paquetes, sino un modelo que genere las cargas, de forma nativa en SQL Server, Azure SQL o Fabric.
Preguntas y respuestas
-
Permite almacenar los archivos en Git, pero el problema fundamental reside en qué se versiona: un archivo
.dtsxmezcla la disposición gráfica, los metadatos internos y los GUIDs con la lógica real. Un diff en Git es casi puro ruido visual y resolver conflictos de merge entre dos desarrolladores sobre el mismo paquete rara vez es seguro. Versionar un modelo captura la intención del negocio; el código técnico de despliegue se genera a partir de él. - Scripts de despliegue generados y adaptados a cada entorno. Los detalles de conexión por entorno se definen una sola vez, y el paquete de despliegue para Test o Producción se genera a partir del mismo modelo con dichos valores aplicados y el rollback incluido.
-
Sí. Azure DevOps o GitHub Actions ejecutan el paquete de despliegue generado. Lo que desaparece es la compilación del archivo
.ispacy el mantenimiento manual de los mapeos de variables de entorno en SSISDB.