¿Está pensando en migrar sus paquetes SSIS a la nube mediante lift-and-shift?
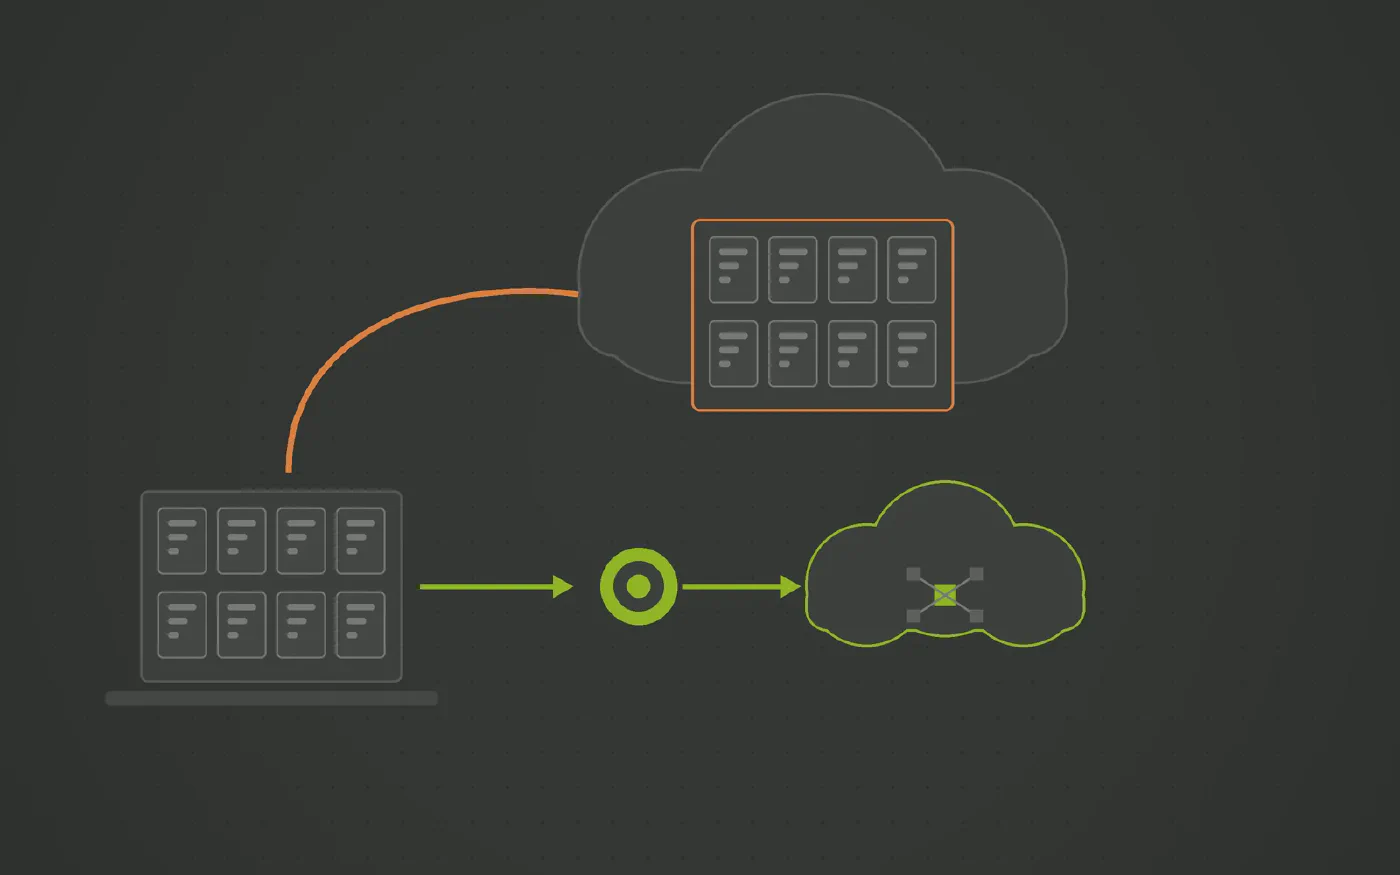
Los proyectos heredados de SSIS arrastran tres problemas que una máquina virtual en la nube no resuelve: un paquete por tabla que nadie quiere tocar, releases ajenas a DevOps y un diseño ligado a SQL Server. Azure-SSIS Integration Runtime traslada los tres intactos a la nube. Un modelo que genere el data warehouse los hace innecesarios.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- El plan de modernización del data warehouse consiste simplemente en mover los paquetes `.dtsx` actuales a un Azure-SSIS Integration Runtime en la nube.
- El equipo teme que modernizar la arquitectura exija reescribir manualmente cientos de paquetes de SSIS durante años.
- Los paquetes existentes siguen fallando por falta de memoria o bloqueos al procesar volúmenes crecientes de datos en la nube.
- La dirección exige adoptar Snowflake o Microsoft Fabric, pero el equipo de datos no ve cómo migrar sin rehacer todo el trabajo previo.
Frente a la necesidad imperiosa de cerrar centros de datos locales o modernizar infraestructuras obsoletas, muchas organizaciones optan por el camino en apariencia más rápido: el lift and shift.
En el caso de SSIS, esto suele traducirse en desplegar un Azure-SSIS Integration Runtime en
Azure Data Factory y migrar los paquetes .dtsx tal como están.
Por qué el lift-and-shift traslada los problemas en lugar de resolverlos
Un proyecto de SSIS maduro suele arrastrar tres debilidades estructurales:
- Deuda técnica acumulada. Cientos de paquetes construidos por muchas personas distintas a lo largo de los años, difíciles de auditar y con dependencias ocultas. Consulte el artículo sobre la deuda de paquetes.
- Releases incompatibles con CI/CD. Despliegues de archivos monolíticos
.ispacy mapeos manuales de variables. Consulte el artículo sobre despliegue y CI/CD. - Dependencia del motor de SQL Server. Incapacidad para explotar de forma eficiente las plataformas analíticas modernas como Snowflake o Databricks. Consulte el artículo sobre SSIS más allá de SQL Server.
El lift-and-shift lleva los tres problemas a la nube intactos. La máquina virtual en Azure es simplemente infraestructura que alguien debe seguir parcheando, licenciando y manteniendo. La deuda técnica no desaparece por cambiar de servidor.
La verdadera modernización: migrar la arquitectura, no la infraestructura interna
Reescribir cientos de paquetes a mano en otra herramienta ETL solo traslada la deuda acumulada a un nuevo entorno. La vía pragmática consiste en cambiar de nivel de abstracción:
- Rescatar la lógica del negocio. Lo valioso de sus paquetes de SSIS son las reglas de extracción, las tablas de origen y la definición de las entidades analíticas.
- Modelar en Data Vault 2.0. Organice esa lógica en un modelo estructurado en hubs, links y satélites.
- Generar el nuevo código. Deje que la plataforma automatizada compile todo el código ELT nativo para su base de datos de destino en la nube.
La propuesta de Datavault Builder
Datavault Builder ofrece una ruta de modernización limpia y acelerada:
- Ejecución nativa en la nube. Genere código optimizado para Microsoft Fabric, Snowflake, Databricks o Azure SQL.
- Menor sobrecarga operativa. Sin servidores de integración dedicados, sin buffers de memoria limitados y sin licencias extra de software intermedio.
- Despliegues deterministas. CI/CD integrado, control de versiones semántico con Git y rollback generado de forma automática.
- Historización sin código manual. El historial de los datos queda resuelto de forma estándar y uniforme en todo el data warehouse.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Identificar los tres problemas de SSIS
Reconozca la deuda técnica: el mantenimiento de un paquete por tabla, la incompatibilidad con DevOps moderno y el límite técnico del motor de SQL Server.
-
Reconocer que el lift-and-shift no moderniza
Mover código heredado a una máquina virtual en Azure conserva intactos todos los costes de mantenimiento y las limitaciones de desarrollo.
-
Migrar el modelo en lugar del código técnico
Extraiga los metadatos de sus paquetes existentes a un modelo Data Vault y genere cargas nativas para su nueva base de datos en la nube.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
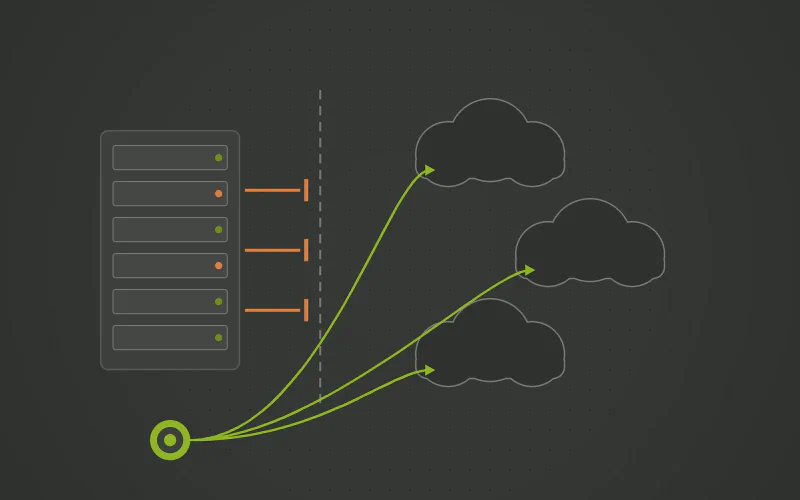
¿Sigue ejecutando SSIS sobre una máquina con licencia de SQL Server solo para cargar datos en Snowflake o en la nube?
SQL Server Integration Services (SSIS) se diseñó para el ecosistema on-premises de Microsoft. Utilizarlo para alimentar data warehouses en la nube como Snowflake, Databricks o Fabric implica servidores intermedios dedicados, conectores de terceros y licencias innecesarias de SQL Server. La solución es generar cargas nativas en el motor de destino.
-
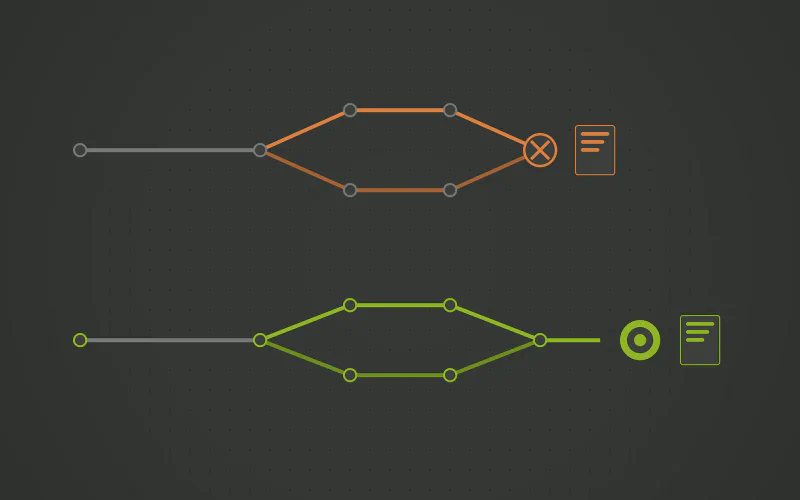
¿Es SSIS la única pieza de su stack técnico que sigue sin poder integrarse en CI/CD?
Un archivo .dtsx es código XML que se compara mal y se fusiona peor en Git; si dos ingenieros tocan el mismo paquete, suele terminar en reconstrucción manual. Los entornos residen en mapeos de variables de SSISDB que se mantienen a mano. Las releases deberían generarse a partir de un modelo, entorno por entorno, con rollback incluido.
-
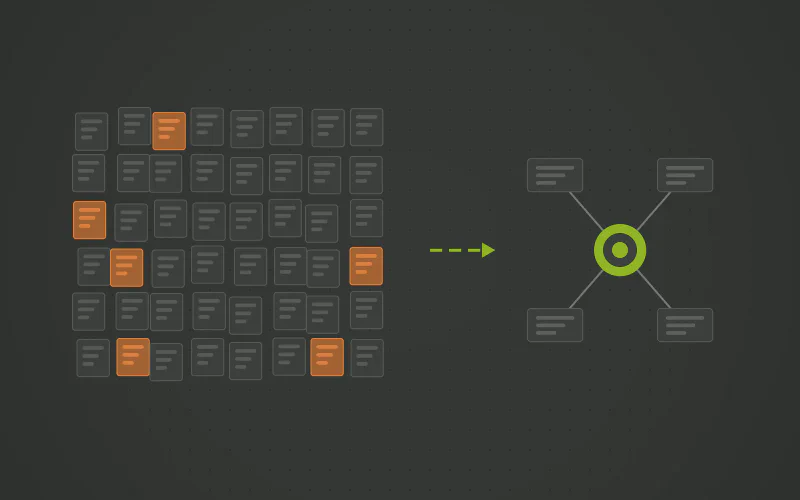
¿Hay más paquetes SSIS en su empresa que personas capaces de entenderlos?
Cientos de paquetes .dtsx, uno por cada tabla, construidos en Visual Studio por quien tuviera la tarea asignada en cada momento, con flujos de control y flujos de datos que solo se abren de uno en uno. Añadir una columna obliga a abrir los paquetes uno a uno. La solución no es una plantilla de paquetes, sino un modelo que genere las cargas, de forma nativa en SQL Server, Azure SQL o Fabric.
Preguntas y respuestas
- No. Argumenta contra la práctica de trasladar a Azure paquetes construidos a mano sin resolver su arquitectura. El data warehouse generado por Datavault Builder se ejecuta de forma nativa sobre Microsoft Fabric, Azure SQL o Azure Synapse, así como sobre SQL Server on-premises mientras sea necesario.
- Azure-SSIS Integration Runtime como puente y Fabric Data Factory como destino. El puente ejecuta los paquetes tal como están. El destino es un nuevo lienzo, lo que exige una reconstrucción manual. La generación a partir de un modelo es la tercera opción, y la única en la que los paquetes se retiran en lugar de ser reubicados o rediseñados.
- Es un mapeo por cada sistema de origen en lugar de una reescritura por cada paquete, y el parque de paquetes se reduce de mapeo en mapeo mientras los antiguos siguen ejecutándose. Ninguna cifra es honesta sin conocer el volumen del parque existente: lo que cambia es la naturaleza del trabajo.