¿Hay más paquetes SSIS en su empresa que personas capaces de entenderlos?
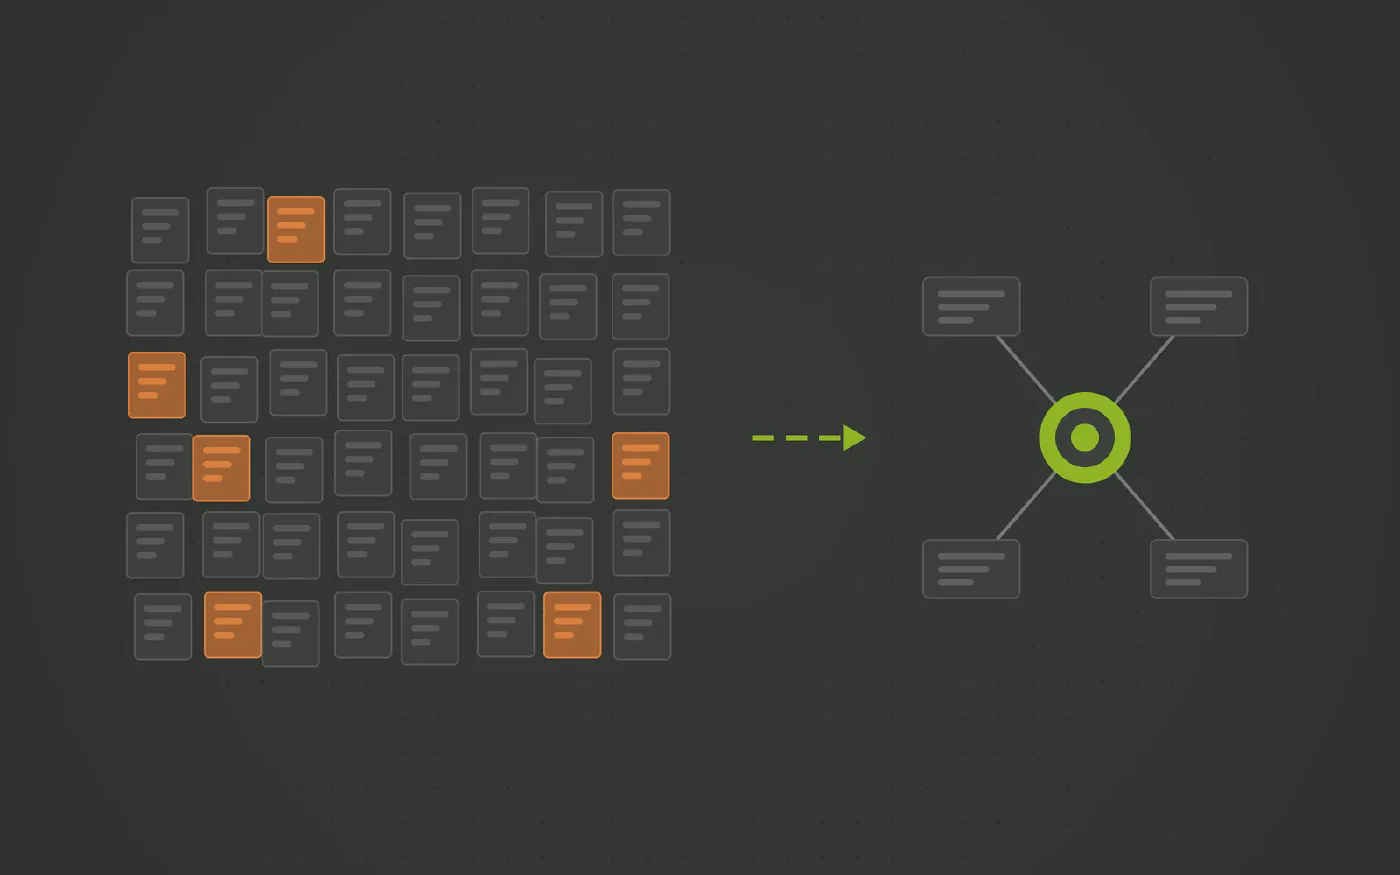
Cientos de paquetes .dtsx, uno por cada tabla, construidos en Visual Studio por quien tuviera la tarea asignada en cada momento, con flujos de control y flujos de datos que solo se abren de uno en uno. Añadir una columna obliga a abrir los paquetes uno a uno. La solución no es una plantilla de paquetes, sino un modelo que genere las cargas, de forma nativa en SQL Server, Azure SQL o Fabric.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- Una nueva columna de origen obliga a abrir en Visual Studio cada paquete que toca la tabla, uno a uno.
- Existe un paquete por tabla, y los construidos antes de que existieran los parámetros de proyecto todavía contienen sus propias cadenas de conexión.
- Nadie sabe con certeza qué paquetes siguen programados, y nadie se atreve a eliminar ninguno para averiguarlo.
- Añadir columnas de auditoría al almacén se estimó en semanas, porque implica la misma edición en cientos de flujos de datos.
SSIS fue la respuesta idónea durante dos décadas de almacenes sobre SQL Server, y un parque maduro lo refleja fielmente: cientos de paquetes construidos por muchas manos a lo largo de muchos años, abriéndose de uno en uno en Visual Studio. Los paquetes aún funcionan. El problema es modificarlos.
Por qué el parque existente es difícil de modificar
- Un paquete por tabla, cada uno construido a mano. El mismo flujo de control y flujo de datos, ensamblado de nuevo para cada origen según el criterio de quien tuviera la tarea esa semana.
- Los paquetes antiguos conservan su propia configuración. Los parámetros de proyecto y los administradores de conexiones compartidos existen desde 2012; los paquetes heredados creados antes o sin ellos todavía contienen cadenas de conexión y rutas fijas en su interior.
- Un cambio de esquema es un recorrido por los paquetes. Añadir una columna al data warehouse implica abrir cada paquete que interactúe con ella. La estimación se mide en semanas porque la edición se repite en cientos de flujos de datos.
- Una columna más ancha rompe el flujo de datos. Los metadatos de los flujos de datos tienen tipos fijos asignados en tiempo de diseño, por lo que una columna de origen que crezca o cambie de tipo hace fallar el componente hasta que alguien la reasigne en Visual Studio.
- Nadie sabe exactamente qué está en producción. Los paquetes se programan desde el Agente SQL, desde SSISDB o desde otros paquetes, y nadie quiere ser quien borre el equivocado.
Nada de esto es culpa de SSIS. Un paquete es una forma adecuada de construir una carga individual, pero una forma deficiente de mantener un almacén de datos completo.
Dónde debe residir la estructura
- En un modelo, no en paquetes. Claves de negocio, relaciones y atributos declarados una sola vez, con las cargas derivadas a partir de ellos.
- Generada, para que cada carga tenga un formato idéntico. Sin variaciones según el desarrollador, sin paquetes que solo su autor sepa interpretar.
- En la plataforma que ya utiliza. SQL Server y Azure SQL son destinos de primera clase, y Fabric está disponible cuando decida dar el paso.
Qué cambia con Datavault Builder
Datavault Builder mantiene el data warehouse en un modelo visual y genera a partir de él las cargas de staging, historización y entrega, de forma nativa para SQL Server, Azure SQL y Fabric.
- El paquete por tabla desaparece. Los hubs, links, satélites y sus respectivas cargas se generan desde el modelo. No hay nada que abrir en Visual Studio.
- Una columna es solo un cambio de mapeo. Se mapea, se regenera y cada estructura dependiente se actualiza de forma coherente. Las columnas que faltan se cargan como null con una advertencia; las columnas ampliadas se ensanchan.
- Cada carga comparte exactamente la misma estructura. El generador escribe el código, evitando desviaciones de estilo y paquetes crípticos.
- El modelo es el inventario central. Qué se carga, desde dónde, hacia dónde y con qué linaje es visible en un único lugar. Se acabaron las búsquedas manuales entre trabajos del Agente SQL.
- Nada tiene que abandonar SQL Server. El almacén generado se ejecuta donde ya corrían los paquetes, y la transición a Fabric se realiza simplemente cambiando el motor de destino cuando usted lo decida.
Qué decidir
Audite el parque de paquetes y cuente cuántos existen exclusivamente para cargar una tabla desde un origen hacia el staging o el almacén. Ese recuento define el tamaño de la capa que un modelo debería generar. Ordenada por fuente de origen, esa misma lista proporciona el orden exacto para ir retirando los paquetes de forma progresiva.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Contar los paquetes que solo cargan una tabla
La mayor parte de un parque maduro de SSIS es un paquete por tabla de origen que hace exactamente lo mismo. Eso es estructura, no lógica.
-
Modelar las fuentes en su lugar
Las claves de negocio, relaciones y atributos se definen en el modelo de Datavault Builder. Las cargas se generan de forma nativa para SQL Server, Azure SQL o Fabric.
-
Retirar paquetes mediante mapeo
Cada fuente mapeada en el modelo es un paquete que ya no es necesario abrir. El parque disminuye a medida que el modelo crece.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
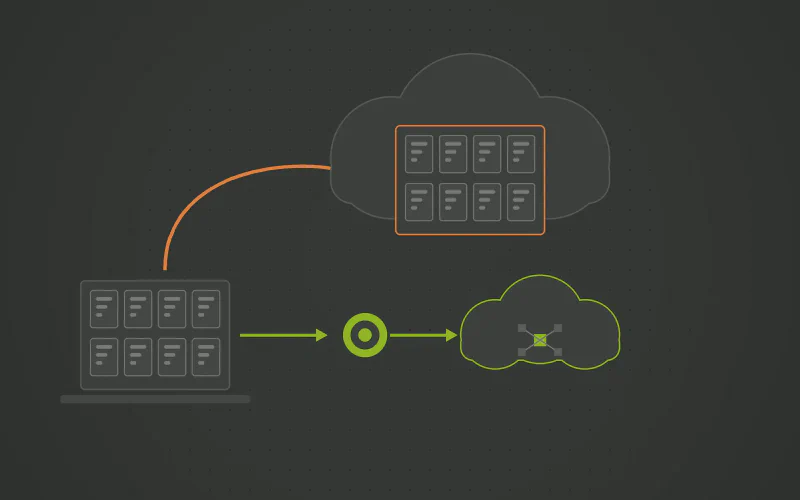
¿Está pensando en migrar sus paquetes SSIS a la nube mediante lift-and-shift?
Los proyectos heredados de SSIS arrastran tres problemas que una máquina virtual en la nube no resuelve: un paquete por tabla que nadie quiere tocar, releases ajenas a DevOps y un diseño ligado a SQL Server. Azure-SSIS Integration Runtime traslada los tres intactos a la nube. Un modelo que genere el data warehouse los hace innecesarios.
-
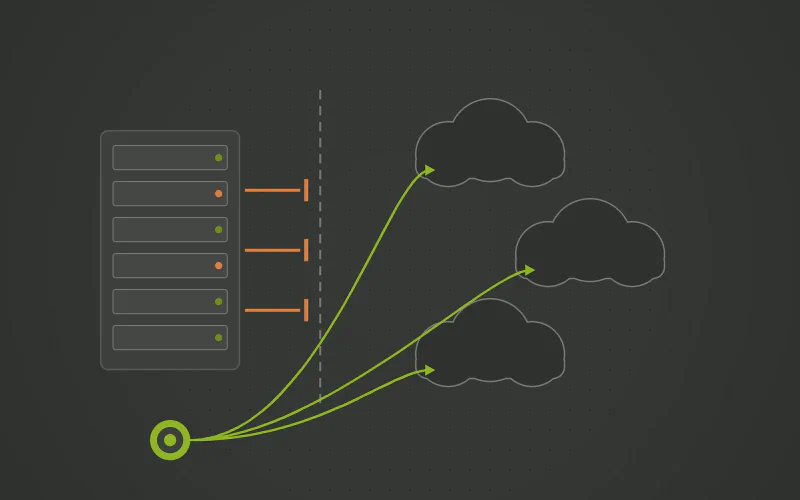
¿Sigue ejecutando SSIS sobre una máquina con licencia de SQL Server solo para cargar datos en Snowflake o en la nube?
SQL Server Integration Services (SSIS) se diseñó para el ecosistema on-premises de Microsoft. Utilizarlo para alimentar data warehouses en la nube como Snowflake, Databricks o Fabric implica servidores intermedios dedicados, conectores de terceros y licencias innecesarias de SQL Server. La solución es generar cargas nativas en el motor de destino.
-
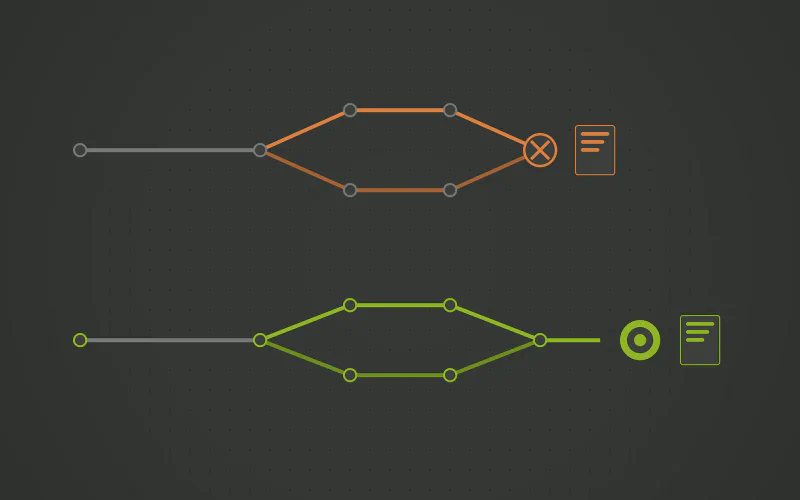
¿Es SSIS la única pieza de su stack técnico que sigue sin poder integrarse en CI/CD?
Un archivo .dtsx es código XML que se compara mal y se fusiona peor en Git; si dos ingenieros tocan el mismo paquete, suele terminar en reconstrucción manual. Los entornos residen en mapeos de variables de SSISDB que se mantienen a mano. Las releases deberían generarse a partir de un modelo, entorno por entorno, con rollback incluido.
Preguntas y respuestas
- No. Datavault Builder genera el almacén de forma nativa para SQL Server y Azure SQL, y para Fabric cuando decida migrar. El ETL se moderniza sin que la plataforma tenga que cambiar.
- Elimina el trabajo de diseño gráfico manual, y eso es un avance real. Lo que deja intacto es el parque de paquetes: BIML produce paquetes .dtsx, por lo que siguen existiendo cientos de ellos para desplegar, programar, fusionar y ejecutar en un servidor SSIS. La diferencia radica en generar cargas basadas en conjuntos que se ejecutan dentro de la base de datos a partir de un modelo, eliminando por completo los paquetes.
- Continúan ejecutándose hasta que su fuente queda mapeada en el modelo, y entonces se retiran. No hay una transición brusca (big bang); el parque se reduce mapeo a mapeo.
- Las reglas de negocio pasan al business vault, donde están versionadas y visibles en el modelo. La lógica de carga, que representa la mayor parte de un paquete típico, se genera automáticamente y no vuelve a escribirse a mano jamás.