Hat Ihr dbt-Projekt mehr Modelle, als irgendjemand erklären kann?
ref() macht ein neues Modell zu einer Entscheidung von einer Zeile, und ein Projekt aus Hunderten kaum kontrollierter SQL-Dateien ist das Ergebnis. Einen Business-Key weiter oben zu ändern heißt dann, jedes Modell zu finden, das ihn geerbt hat. Die Lösung lautet nicht, noch mehr Tests zu schreiben. Es ist ein Modell, das die Struktur generiert, statt sie anzuhäufen.
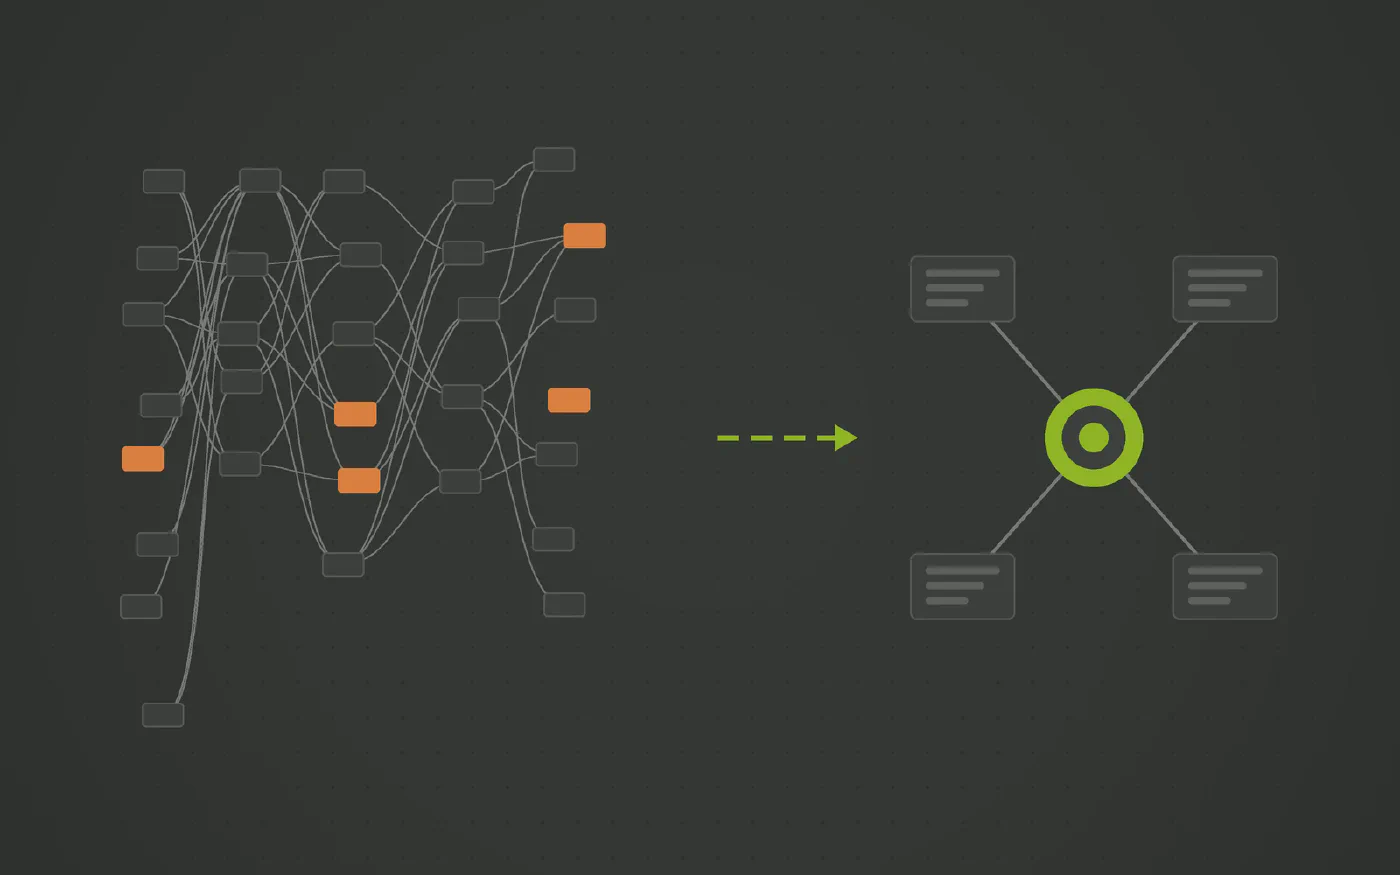
Die Data-Warehouse-Automationsplattform, der Datenteams aus vielen Branchen vertrauen









Kommt Ihnen das bekannt vor?
- Der DAG hat Hunderte Modelle und eine Handvoll Leute, die wissen, warum die Hälfte davon existiert.
- Eine Änderung an einem Business-Key weiter oben bricht Modelle drei Ebenen tiefer, von denen niemand mehr wusste, dass sie davon abhängen.
- Dieselbe Staging-Logik existiert in leicht unterschiedlichen Versionen, weil ein Modell zu kopieren schneller war, als eines wiederzuverwenden.
- Das Refactoring wird für jedes Quartal eingeplant und in keinem jemals abgeschlossen.
dbt, inzwischen gemeinsam mit Fivetran unter einem Dach, hat das Anlegen eines Modells trivial gemacht.
select * from ref('...'), und ein neuer Knoten existiert. Das ist das Feature, und über zwei
oder drei Jahre ist es auch der Weg, auf dem ein Projekt in Hunderte Modelle wächst, mit einer
Lineage, die niemand mehr im Kopf behalten kann. Wenn neuer Code keinen Aufwand bedeutet,
wächst der Bestand ganz von allein.
Warum Projekte wuchern
- Kopieren ist einfacher, als bestehenden Code anzupassen. dbt hat Makros und Packages für die Standard-Patterns, aber jeder Entwickler kann sie bearbeiten, und ein gemeinsames sauber zu ändern bedeutet Regressionstests und Migrationsskripte. Also bekommt ein Pattern, das nicht ganz passt, eine zweite Version.
- Struktur und Logik leben in denselben Dateien. Ein Modell, das eine Quelle staged, eines, das Historie behandelt, und eines, das Marge berechnet, sehen im DAG alle gleich aus.
- Abhängigkeiten werden deklariert, nicht entworfen.
ref()hält fest, dass ein Modell ein anderes liest; es sagt nicht, warum, oder was bricht, wenn sich der Schlüssel weiter oben ändert. - Governance kommt im Nachhinein. Namenskonventionen, Ordner und Tests werden auf ein Projekt angewendet, das bereits groß war, als jemand sie aufschrieb.
Das Tooling trägt keine Schuld. Ein Framework, das SQL modular macht, wird benutzt werden, um viel modulares SQL zu schreiben.
Wo die Struktur hingehört
- Die meisten Modelle sind strukturell. Staging, Deduplizierung, Schlüsselerzeugung, Historienverfolgung: dasselbe Pattern pro Quelle, nur mit anderen Spaltennamen.
- Struktureller Code sollte generiert werden, nicht angehäuft. Business-Key, Beziehungen und Attribute einmal deklarieren und den Ladecode aus einem Pattern ableiten, das kein Projekt bearbeitet.
- Logik ist der Teil, den es sich lohnt von Hand zu schreiben. Geschäftsregeln, Kennzahlen und Mart-Strukturen sind ein kleiner Anteil des Projekts und der Teil, der ein Code-Review verdient.
Was sich mit Datavault Builder ändert
Datavault Builder hält die Struktur in einem visuellen Modell und generiert daraus Hubs, Links, Satelliten und ihre Loads, sodass der wiederholte Teil des Projekts aufhört, aus Dateien zu bestehen.
- Eine Definition pro Konzept. Ein Kunden-Hub mit fünf Quellen ist ein Hub und fünf Mappings im Modell, nicht fünfzehn Modelle in einem Ordner.
- Abhängigkeiten werden abgeleitet. Ladereihenfolge und Lineage folgen aus dem Modell, eine Schlüsseländerung weiter oben ist also sichtbar, bevor sie deployt wird, nicht danach.
- Metadaten wandern durch die Schichten. Typen, Schlüssel und Beschreibungen werden einmal deklariert und vom Staging bis zu den Marts mitgeführt, statt in jeder Modelldatei wiederholt zu werden.
- Refactoring ist eine Modelländerung. Mapping ändern, neu generieren, und jede abhängige Struktur wird konsistent neu gebaut.
- Das Modell ist die Dokumentation. Lineage, Definitionen und Historienregeln sind an einem Ort lesbar, ganz ohne manuellen dbt-Docs-Build.
- Geschäftsregeln werden im Modell verwaltet, mit Versionen. Die Auslieferungsschicht wird per Drag-and-Drop auf der semantischen Schicht gebaut, Regeln und Datenprodukte haben also ein Zuhause und eine Historie.
- dbt kann bleiben, generiert. Wenn der Betrieb in dbt bleibt, werden die dbt-Modelle aus demselben Modell generiert und bei Änderungen neu generiert, was ein viel einfacherer Weg ist, sie zu aktualisieren, als Hunderte Dateien zu bearbeiten.
Was zu entscheiden ist
Prüfen Sie das Projekt und sortieren Sie jedes Modell danach, was es tut: staged, gekeyt, historisiert oder berechnet. Wenn die ersten drei den Großteil der Liste ausmachen, ist das der strukturelle Anteil, und genau den sollte ein Generator übernehmen.
Erleben Sie es live mit Ihren eigenen Datenquellen
Buchen Sie eine kostenlose Demo und bringen Sie den Connector mit, der Sie am meisten kostet, an Geld oder an Zeit.
In drei Schritten zu einer Pipeline, die Sie kontrollieren
-
Struktur von Logik trennen
Staging, Schlüssel und Historie sind Struktur. Regeln und Kennzahlen sind Logik. Der Großteil des Wildwuchses ist Struktur.
-
Die Struktur generieren
Hubs, Links und Satelliten und ihre Loads kommen in Datavault Builder aus dem Modell, eine Definition pro Geschäftskonzept.
-
Aus dem Modell ausliefern
Marts und Datenprodukte per Drag-and-Drop, Regeln versioniert in der Plattform. Oder dbt-Modelle generieren, wenn der Betrieb dort bleibt.
Wie Datavault Builder die Reibungsverluste in der Ingestion beseitigt
-
Ingestion ist eingebaut
Batch-, Delta- und CDC-Ladevorgänge aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen, mit Streams wie Kafka, die als Micro-Batches ankommen. Dieselbe Plattform, die das Warehouse generiert, keine zweite Rechnung.
-
Ihr Schema, nicht das des Anbieters
Quelltabellen werden auf ein Data-Vault-2.0-Modell gemappt, das Sie entworfen haben. Eine neue Spalte oder eine umbenannte Tabelle ändert ein Mapping, keine Kette von Skripten nach dem Load.
-
Nur Deltas bewegen sich
Hubs, Links und Satelliten laden, was sich geändert hat. Vollständige Ladevorgänge bleiben im Staging, statt jede Nacht weiter unten neu verarbeitet zu werden.
-
Historie wird von Haus aus behalten
Jede Änderung wird so festgehalten, wie sie eintrifft. Historien- und Stichtagsabfragen funktionieren also auch dort, wo die Quelle ihre eigenen Zeilen überschreibt.
-
Code, den Sie nie von Hand schreiben
Laden, Historisierung und Lineage werden in Echtzeit aus dem Modell generiert und laufen nativ auf Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle oder PostgreSQL.
-
Eine Plattform, bis zu neun Tools weniger
Modellierung, ETL, CI/CD, Dokumentation und Lineage an einem Ort. Das ist es, was 14,7 Minuten von der Anforderung bis zur Produktion möglich macht.
Ausgezeichnet von BARC im Data Fabric Survey 26







Sprechen Sie mit unserem Experten
Zwanzig Minuten mit unserem Sales Director und eine ehrliche Antwort, ob das zu Ihrem Stack passt.

Matt Collett
Sales Director
Perfekt, wählen Sie einen passenden Termin:
Weitere Probleme in dieser Serie
-
Der dbt Kompromiss: Code-Wildwuchs, versteckte TCO und das Argument für automatisierte Modellierung
dbt hat Software Engineering in SQL gebracht, und Teams wollen das zu Recht. Der Preis ist eine Transformationsschicht, die in Code, Kosten und Compute wächst, auf einem Ingestion-Tool, das weiterhin ein separates Produkt ist. Ein generierter Data Vault nimmt diese ganze Schicht aus der Codebasis. Er braucht dbt nicht, lässt sich aber damit kombinieren.
-
Überlässt dbt es weiterhin Ihnen, die Daten selbst zu landen?
dbt ist von seinem Design her ein Transformationstool. Es setzt voraus, dass die Rohdaten bereits im Warehouse liegen, der Landing-Schritt ist also ein zweites Produkt mit einer zweiten Rechnung, auch jetzt, wo Fivetran und dbt Labs ein Unternehmen sind. Eine Warehouse-Plattform, die an einem Ort lädt und modelliert, schließt die Lücke ohne zweiten Vertrag.
-
Treibt Ihr dbt-Run still und leise die Warehouse-Compute-Kosten hoch?
dbt führt alles im Warehouse aus, ein Full Refresh, wo ein inkrementeller Lauf reichen würde, oder eine Tabellen-Materialisierung, die jede Nacht neu gebaut wird, zeigt sich also als Credits, nicht als Fehler. Inkrementelle Logik ist in dbt optional. In einem generierten Data Vault ist sie die einzige Art, wie Loads geschrieben werden.
Fragen und Antworten
- AutomateDV generiert Hub, Link und Satelliten SQL aus Makros, die Sie pro Modell konfigurieren, und das ist ein echter Fortschritt gegenüber handgeschriebenem Vault Code. Was bei Ihnen bleibt, sind die Staging-Schicht, die Metadaten für jeden Makroaufruf, die Orchestrierungsreihenfolge und der Umgang mit Historie bei Änderungen in der Quelle. In Datavault Builder werden diese aus einem visuellen Modell abgeleitet und aktualisiert, wenn sich das Modell ändert, und das Modell selbst ist die Dokumentation. Es gibt auch einen direkten Weg hinüber: Der Migration Vault ist ein Datenmodell aus Hubs, Links, Satelliten, Quellen und Business-Keys. Mappen Sie die Metadaten, die ein AutomateDV Projekt bereits hat, hinein, und Datavault Builder generiert aus diesem Mapping ein Deployment Paket.
- Das Modell hat einen Eintrag pro Geschäftskonzept und Quell Mapping, nicht eine Datei pro Transformationsschritt. Ein Kunden-Hub mit fünf Quellen ist ein Hub und fünf Mappings, nicht fünfzehn Modelle.
- Ja, auf zwei Arten. Der generierte Vault und die Marts sind gewöhnliche Tabellen und Views, bestehende dbt-Modelle können sie also lesen. Und wenn Sie den Betrieb weiter über dbt laufen lassen wollen, generiert Datavault Builder die dbt-Modelle aus seinem eigenen Modell, der Wildwuchs kommt also nicht zurück: Eine Änderung wird im Modell gemacht und das dbt-Projekt neu generiert.