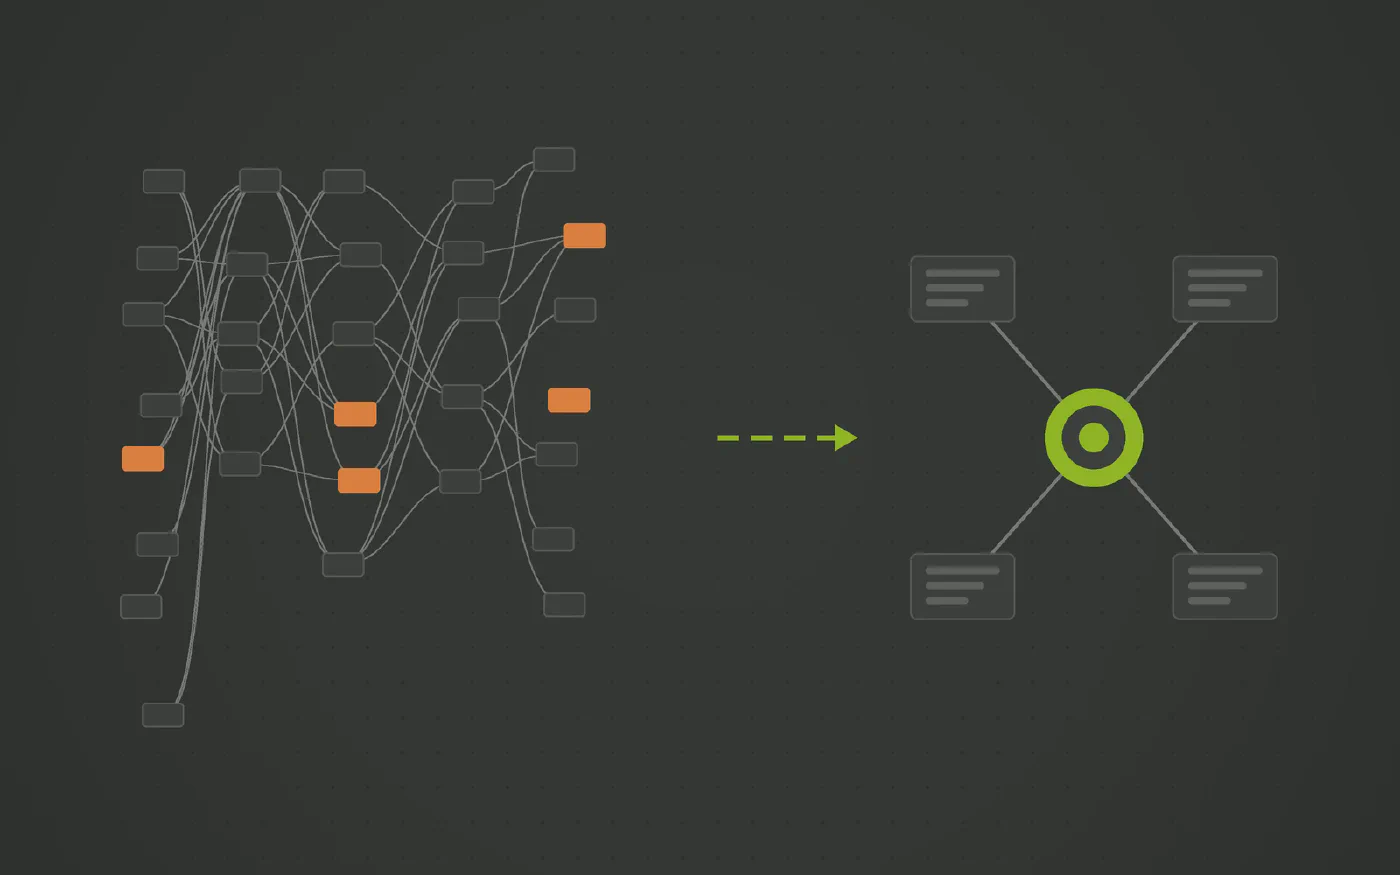
¿Se ha convertido su DAG de dbt en una maraña imposible de depurar?
Crear un nuevo modelo en dbt es tan fácil que los repositorios acumulan rápidamente cientos de archivos SQL y dependencias difíciles de rastrear. Cuando un informe falla, seguir el rastro de un dato a través de capas intermedias encadenadas consume horas de trabajo. La solución es una arquitectura estructurada basada en modelos con reglas de derivación claras.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- El grafo acíclico dirigido (DAG) de dbt contiene cientos de nodos y nadie en el equipo comprende el impacto total de modificar un modelo base.
- Existen múltiples modelos intermedios con nombres similares (`stg_customers_v2`, `int_customers_clean`) creados para solucionar problemas puntuales.
- Los tiempos de compilación y ejecución del proyecto crecen con cada sprint, obligando a aplicar filtros y particiones complejas para ejecutar en local.
- El linaje muestra tablas intermedias que ningún informe consume, pero que nadie se atreve a eliminar por precaución.
La facilidad con la que se añade un modelo en dbt es su mayor atractivo y, al mismo tiempo,
la semilla de su mayor problema a largo plazo. Un simple archivo .sql con una consulta
select * from {{ ref('...') }} basta para introducir un nuevo nodo en el DAG.
Tras un par de años de evolución y la rotación natural de miembros en el equipo, el proyecto suele encontrarse en un estado crítico: un grafo gigantesco con cientos de modelos entrelazados, donde cada cambio requiere precauciones extremas para no provocar fallos imprevistos en producción.
Cómo se produce la proliferación descontrolada
- Falta de restricciones estructurales. dbt no impone una metodología de modelado de datos; es un motor de compilación y ejecución de plantillas SQL. La arquitectura depende enteramente de la disciplina individual de los desarrolladores.
- Creación de modelos intermedios ad-hoc. Cuando un analista necesita un campo adicional o un filtrado especial, resulta más rápido crear un nuevo modelo intermedio que refactorizar los modelos existentes y arriesgarse a romper las entregas en curso.
- Lógica empresarial fragmentada. Las reglas de negocio quedan distribuidas a lo largo de múltiples capas (un cálculo en staging, un join en una tabla intermedia y una condición en el mart), lo que dificulta enormemente la auditoría y la validación de las cifras.
- Costes de computación desmedidos. Cada modelo materializado intermedio consume espacio de almacenamiento y créditos de procesamiento en cada ejecución de la orquestación.
La alternativa: arquitectura determinista basada en modelos
Un almacén de datos empresarial requiere reglas de diseño claras y consistentes:
- Separación total entre integración y entrega. La capa de integración (Data Vault) almacena los datos históricos en su máximo nivel de detalle, organizada por conceptos clave del negocio.
- Derivación predecible. Las tablas de staging, los links y los satélites siguen un patrón uniforme, generado automáticamente a partir de las entidades del negocio.
- Marts de consumo desacoplados. Los paneles de BI y los productos de datos consumen vistas o tablas dimensionales construidas sobre el vault, sin encadenar dependencias cruzadas entre sí.
Ventajas con Datavault Builder
Datavault Builder elimina la dispersión descontrolada de modelos mediante automatización rigurosa:
- Estructura estandarizada por diseño. Cada dato tiene un lugar preciso y definido dentro del modelo Data Vault 2.0. Desaparecen los debates sobre dónde ubicar una transformación.
- Mantenimiento simplificado. El modelo visual refleja con exactitud la realidad de su negocio. Si una entidad evoluciona, el cambio se aplica en el modelo y el código correspondiente se regenera de inmediato.
- Documentación y linaje automáticos. No requiere mantener archivos YAML manuales ni descripciones desactualizadas; la trazabilidad de extremo a extremo es intrínseca a la plataforma.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Auditar los modelos huérfanos
Identifique modelos en el repositorio que no tengan dependencias descendentes y que no alimenten ningún panel de BI ni producto de datos activo.
-
Adoptar una taxonomía estricta
Limite las transformaciones a capas bien definidas: staging de datos brutos, modelo de integración empresarial (Data Vault) y marts de entrega.
-
Generar la arquitectura desde el modelo
Utilice una herramienta que derive las capas intermedias de forma sistemática en lugar de permitir que cada desarrollador invente su propia jerarquía.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
La otra cara de dbt: Proliferación de código, costes ocultos y automatización
dbt aportó modularidad y Git al código SQL y transformó la ingeniería analítica. A medida que los proyectos crecen, surge el dilema: la sobrecarga de infraestructura de Core frente a las tarifas por desarrollador de Cloud, a lo que se suman la brecha de ingesta y la acumulación de modelos manuales. Una plataforma basada en modelos supera esa contrapartida.
-
¿Por qué dbt le obliga a buscar otra herramienta antes de poder empezar a modelar?
dbt transforma datos que ya residen en su data warehouse. No extrae, no conecta ni carga nada desde los sistemas de origen. Para construir un data warehouse completo necesita una segunda herramienta para la ingesta, una tercera para la orquestación y una integración que las conecte. Una plataforma basada en modelos resuelve la ingesta y la transformación en un solo lugar.
-
¿Están los modelos de dbt disparando su factura de computación en Snowflake o BigQuery?
dbt ejecuta todo su código dentro de su motor de datos analítico. Cuando los modelos son reconstrucciones completas de tablas o aplican estrategias incrementales artesanales, el consumo de computación escala con cada ejecución. Una arquitectura Data Vault generada aplica cargas incrementales por diseño, manteniendo los costes estables.
Preguntas y respuestas
- AutomateDV genera el SQL de hubs, links y satélites a partir de macros que usted configura para cada modelo, lo que representa un avance frente al código manual. Sin embargo, deja bajo su responsabilidad la capa de staging, los metadatos de cada llamada a macro, el orden de orquestación y la gestión de cambios históricos en el origen. En Datavault Builder, todos estos elementos se derivan de un único modelo visual y se actualizan al modificarlo, sirviendo el propio diseño como documentación viva. Además, existe una vía directa de migración: Migration Vault permite mapear los metadatos existentes de un proyecto AutomateDV para generar automáticamente los paquetes de despliegue correspondientes.
- Al aplicar estrictamente la metodología Data Vault 2.0 de forma automatizada, los datos siempre siguen una ruta predecible: Staging → Hubs/Links/Satellites → Capa de Negocio / Marts. No hay espacio para capas intermedias arbitrarias inventadas sobre la marcha.
- Sí, de dos maneras. El vault y los data marts generados son tablas y vistas ordinarias, por lo que los modelos existentes de dbt pueden leer directamente de ellos. Y si prefiere seguir gestionando la operativa a través de dbt, Datavault Builder genera los modelos de dbt a partir de su propio modelo, impidiendo que la proliferación reaparezca: el cambio se realiza en el modelo visual y el proyecto dbt se regenera.