Co je satelit v Data Vaultu?
Satelit obsahuje vše, co popisuje hub: jména, stavy, částky a každou jejich změnu, která se připojí jako nový řádek a nikdy se nepřepisuje. Je to Slowly Changing Dimension typu 2 bez příkazu UPDATE, se zabudovanou úplnou auditní stopou.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory
Zní vám to povědomě?
- Zákazníkovi se změnila adresa a ta stará je pryč, protože ji načítání přepsalo.
- Kvůli zůstatku, který se mění každý den, se každou noc kopíruje oficiální název zákazníka do nového řádku.
- Záznam ve zdroji zmizel a datový sklad s ním smazal i jeho historii.
Huby říkají, co existuje. Linky říkají, jak k sobě věci patří. Žádný z nich neukládá jméno, zůstatek ani stav. To je úkol satelitu.
Řečeno jazykem klasického modelování: z atributů entity, tedy z jejího kontextu, se stane
satelit. Tam, kde tabulka Customer obsahuje vedle customer_number také name, address
a segment, uloží Data Vault číslo do hubu zákazníků a atributy do satelitu na tomto hubu.
Co je satelit
Satelit obsahuje popisné atributy hubu a každou jejich změnu v čase. Když se zákazník přestěhuje, satelit adresu nepřepíše: připojí nový řádek a ten starý zůstane. Každý řádek zaznamenává, kdy se dostal do vaultu a který systém ho dodal, takže každou verzi lze dohledat.
Pokud znáte dimenzionální modelování, satelit je Slowly Changing Dimension typu 2, aniž by se kdy spouštěl UPDATE. Historizaci lze na přání také vypnout, čímž vznikne nehistorizovaný satelit.
Anatomie satelitu
| Část | Sloupce | Účel |
|---|---|---|
| Nadřazený hub | Hash klíč hubu | Který záznam nadřazeného hubu tento řádek popisuje |
| Čas a audit | Load Date, Record Source | Kdy řádek dorazil a odkud |
| Obsah | Popisné atributy | Ulice, e-mail, částka, stav |
| Detekce změn (volitelná) | Hash diff | Jeden hash přes celý obsah |
Primárním klíčem je hash klíč nadřazeného hubu plus Load Date.
Hash diff je volba, ne pravidlo
Podle učebnicového Data Vaultu se má pro detekci změn u každého řádku satelitu počítat hash diff. V praxi záleží na typu načítání:
- Inkrementální načítání: uložené řádky už svůj hash mají, takže hashovat jen příchozí řádky je levné. Hash diff vítězí.
- Plné načítání: hashovat při každém běhu miliony řádků stojí hodně výpočetního výkonu. Přímé
porovnání sloupců (
IS DISTINCT FROM) bývá na moderních enginech rychlejší. - Široké tabulky: běžně se tvrdí, že z hashování nejvíce těží široké tabulky. Pravdě je blíž opak: širší řádky znamenají delší řetězce, které se musí spojit a zahashovat.
Datavault Builder podporuje hash diff jako možnost, ne jako povinnost. Hash diff dostane v této sérii vlastní článek.
Transakce mají vlastní satelit
Množství, ceny a částky řádku objednávky popisují samotnou transakci. Pokud má řádek objednávky svůj grain hub, jak popisuje článek o linku, patří tyto hodnoty do běžného satelitu na tomto grain hubu, kde se historizují jako jakýkoli jiný atribut.
Jak satelity rozdělit
- Podle zdrojového systému. Data z CRM a ERP nikdy nesdílejí jeden raw satelit. Každý zdroj si zachovává vlastní původ dat, beze změny.
- Podle rychlosti změn. Denní zůstatek a oficiální název v jednom satelitu znamenají, že se název každý den zkopíruje do nového řádku. Rychle a pomalu se měnící atributy patří do samostatných satelitů.
- Podle citlivosti. Osobní údaje, jako je jméno, e-mail a datum narození, patří do vlastního satelitu, odděleně od atributů, které nikoho neidentifikují. Pro reporting podle GDPR pak existuje jedno jasné místo, kam se podívat, a přístupová pravidla nebo žádost o výmaz se týkají jen tohoto satelitu.
- Nikdy nemazat. Když záznam ve zdroji zmizí, jeho historie zůstane. Record tracking satelit označí, že klíč už se nedodává. Výjimkou je zákonná povinnost informace odstranit, například žádost o výmaz podle GDPR, a právě tam se rozdělení podle citlivosti vyplatí.
Co se mění s Datavault Builderem
Zdrojové sloupce mapujete na satelit v modelu. Detekce změn, načítání, které pouze připojuje nové řádky, i auditní sloupce se vygenerují a běží nativně na Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle nebo PostgreSQL. Dvě situace, které klasické načítací vzory nezvládají, jsou pokryty hned od začátku:
- Bitemporální načítání. Finanční instituce se zpracováním na konci dne má dvě časové osy: kdy něco platilo pro byznys a kdy to datový sklad načetl. Datavault Builder zpracovává historii konce dne a historii načítání společně a vytváří bitemporální satelity. Jak to funguje, popisuje článek „Bi-temporální zpracování dat“; bitemporalita dostane v této sérii také vlastní článek.
- Více než jedna změna na jedno načtení. Data lake často dodá v jedné dávce několik verzí téhož záznamu. Klasické vzory načítají jednu změnu na klíč a běh, takže byste museli data procházet ve smyčce a každá verze by dostala datum okamžiku načtení. Datavault Builder načte všechny změny v jedné dávce a každý záznam umístí na časovou osu tam, kde ho data lake zaznamenal.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k satelitu
-
Připojit ho k právě jednomu hubu
Každý satelit popisuje právě jeden hub a jeho klíčem je hash klíč tohoto hubu plus Load Date.
-
V případě potřeby ho rozumně rozdělit
Tam, kde to pomáhá: podle zdrojového systému, podle rychlosti změn nebo podle citlivosti (osobní údaje odděleně).
-
Nechat načítání vygenerovat
Datavault Builder vygeneruje pro každý satelit detekci změn i načítání, které pouze připojuje nové řádky.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26
Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.
Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Technické klíče vs. business klíče v Data Vaultu
Zdrojové systémy uchovávají business klíč v kmenovém záznamu, ale každý vztah běží přes technické klíče. Čtyři způsoby, jak s tím naložit, co který stojí, a vzor, který používáme my: PSA hub pro technické klíče, namapovaný na hub business klíčů.
-
Co je business klíč v Data Vaultu?
Business klíč je identifikátor, který vaši zaměstnanci a zákazníci skutečně používají: číslo zákazníka, číslo faktury, ID smlouvy. Je stabilní, sdílí ho více systémů a staví na něm každý hub v Data Vaultu.
-
Co je link v Data Vaultu?
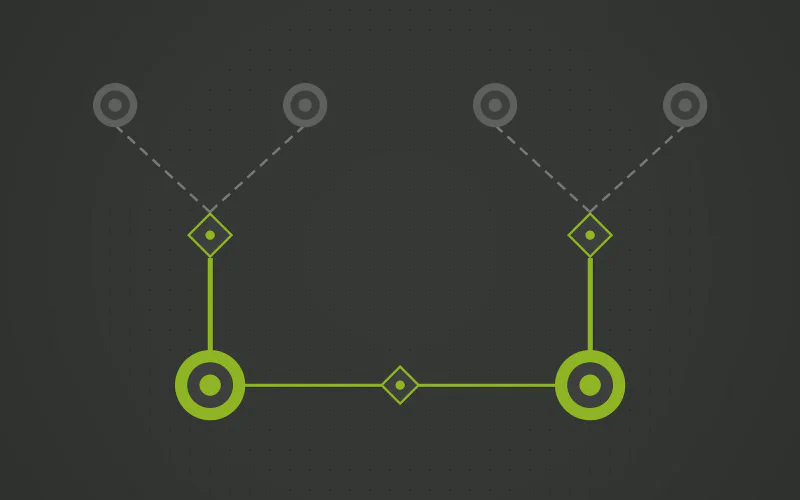
Link zaznamenává vztah mezi business klíči: tato objednávka patří tomuto zákazníkovi. Datavault Builder pokrývá klasický link Data Vaultu a přidává transakční link ukotvený na grain hubu, který určuje granularitu transakce a umožňuje vztahy mezi transakcemi.
-
Co je hub v Data Vaultu?
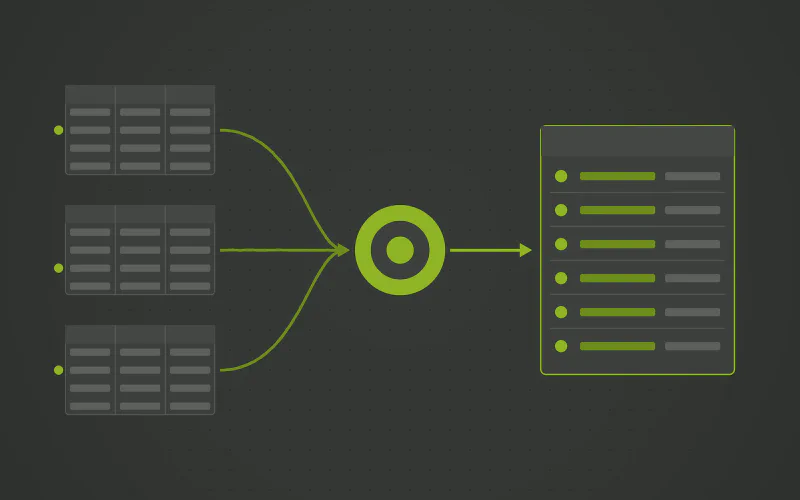
Hub představuje jeden klíčový obchodní pojem, například zákazníka, produkt nebo účet, jako seznam jeho klíčů: všech, které datový sklad kdy obdržel, každého právě jednou. Ukládá identitu, ne stav, a právě díky této střídmosti v něm zanikají datová sila zdrojových systémů.
Otázky a odpovědi
- Dan Linstedt. Metodu vyvinul v 90. letech a zveřejnil ji kolem roku 2000. Data Vault 2.0, který k modelu přidává hash klíče, metodiku a architekturu, následoval v roce 2013.
- Standardní referencí je kniha Building a Scalable Data Warehouse with Data Vault 2.0 od Dana Linstedta a Michaela Olschimkeho (Morgan Kaufmann, 2015).
- Ne. Bill Inmon vidí v Data Vaultu další vývoj svého pojetí podnikového datového skladu ve třetí normální formě, nikoli konkurenční přístup.
- Ne. Dimenzionální výstup bývá součástí implementace Data Vaultu: vault uchovává integrovanou historii a nad ním se pro reporting stavějí hvězdicová schémata. Tentýž vault může dodávat i ploché tabulky nebo Unified Star Schema.
- Díky automatizaci lze pohled ve třetí normální formě nad Data Vaultem vygenerovat zcela deterministicky. Vault ukládá data jen jednou a vrstva 3NF se odvozuje z modelu. Jak to funguje.
- Pokusit se o něj bez automatizace. Data Vault stojí na malé sadě přísných, opakujících se vzorů. Právě proto je ruční psaní zdlouhavé a náchylné k chybám, kdežto generování je přímočaré. Proto byste měli používat Datavault Builder.
- Ano. Rozdělení klíčů, vztahů a historie do hubů, linků a satelitů znamená více tabulek než u normalizovaného nebo dimenzionálního modelu. Proto by fyzickou vrstvu měl odstínit přístup řízený modelem, jako je Datavault Builder: pracujete s modelem obchodních pojmů a tabulky se generují.
- Objednejte si demo a podívejte se, jak vzniká Data Vault nad vašimi vlastními zdroji, nebo si objednejte školicí prostředí a vyzkoušejte si to sami.
- Tady. Datavault Builder je řešení pro automatizaci Data Vaultu: podívejte se na ceny nebo si objednejte demo.
- Datavault Builder se licencuje ročně, formou předplatného práva na užívání softwaru. Trvalé licence jsou k dispozici na vyžádání. Edice a jejich obsah najdete na stránce s cenami.