¿Están los modelos de dbt disparando su factura de computación en Snowflake o BigQuery?
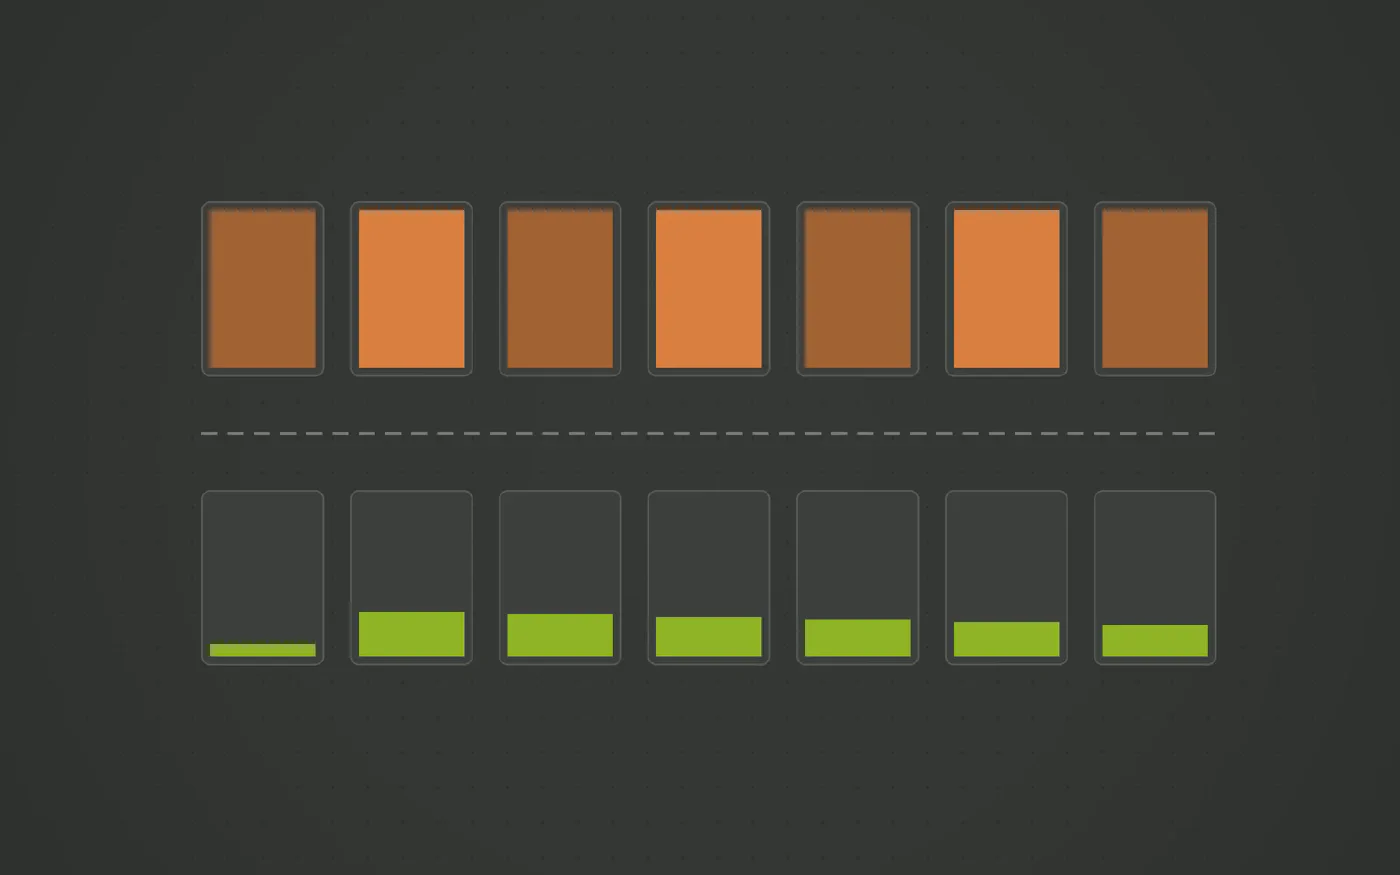
dbt ejecuta todo su código dentro de su motor de datos analítico. Cuando los modelos son reconstrucciones completas de tablas o aplican estrategias incrementales artesanales, el consumo de computación escala con cada ejecución. Una arquitectura Data Vault generada aplica cargas incrementales por diseño, manteniendo los costes estables.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- La ejecución nocturna funciona correctamente, pero la factura de Snowflake o BigQuery aumenta cada trimestre sin que se hayan añadido nuevas fuentes significativas.
- Muchos modelos del repositorio siguen configurados como `table` completa porque implementar la versión `incremental` resultaba demasiado complejo o arriesgado.
- Para acelerar las ejecuciones se opta por aumentar el tamaño del almacén de computación (de M a L o XL), multiplicando el coste por hora.
- Los entornos de desarrollo y pruebas generan costes desproporcionados al recrear conjuntos completos de datos para verificar cambios mínimos.
Una de las premisas atractivas del paradigma moderno de datos es trasladar toda la computación al interior del data warehouse cloud. Motores como Snowflake, Google BigQuery, Databricks o Amazon Redshift ofrecen una capacidad de escalado prácticamente ilimitada.
La contrapartida de esa abundancia es económica: cuando un proyecto de dbt crece sin controles estrictos, el motor de base de datos factura cada segundo de cómputo consumido por consultas ineficientes.
Por qué dbt puede inflar la factura de computación
- Reconstrucciones completas por omisión. El valor predeterminado más seguro en dbt es
materialized='table', lo que implica destruir y recrear la tabla completa en cada ejecución. A medida que la tabla acumula millones de filas, el coste de reescribirla a diario se dispara. - Complejidad de los modelos incrementales. Configurar correctamente un modelo incremental
manual exige controlar marcas de agua, gestionar registros tardíos y definir estrategias de
fusión (
merge). Ante el riesgo de generar inconsistencias, muchos equipos posponen esta optimización. - Recálculo redundante de históricos. Si un modelo une dimensiones que cambian en el tiempo, suele reevaluar todo el historial en cada ejecución, repitiendo cálculos que ya se habían resuelto la víspera.
- Costes ocultos en entornos no productivos. Cuando múltiples desarrolladores ejecutan
dbt builden sus ramas locales sobre clones de datos reales, el consumo se multiplica en paralelo.
Nada de esto es un fallo de diseño de dbt en sí mismo; es la consecuencia inevitable de dejar la eficiencia del código SQL en manos del tiempo y la experiencia de cada desarrollador.
La respuesta: diseño incremental automatizado
En una arquitectura de datos bien diseñada, el volumen de computación consumido debe ser proporcional al cambio en los datos de origen, no al tamaño histórico acumulado en el almacén:
- Detección automática de deltas. La capa de integración identifica únicamente las filas nuevas o modificadas desde la última extracción.
- Historización en satélites. Los cambios se insertan en satélites Data Vault sin alterar ni reescribir los registros precedentes.
- Entrega eficiente. Las vistas de negocio leen directamente del vault optimizado o materializan data marts mediante deltas controlados.
El modelo de Datavault Builder
Datavault Builder garantiza eficiencia de procesamiento mediante automatización:
- Cargas incrementales nativas por diseño. Cada carga generada para hubs, links y satélites es incremental por defecto. No hay que programar lógica de merge manual.
- Código adaptado a cada motor. El SQL generado aprovecha las capacidades específicas de particionado, clustering y microparticiones de Snowflake, Databricks o BigQuery.
- Previsibilidad y control del gasto. El coste de computación refleja fielmente la actividad del negocio, eliminando picos de facturación imprevistos por reprocesamientos completos.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Identificar los modelos de reconstrucción completa
Localice los modelos materializados como tablas completas que procesan millones de registros idénticos a los de la noche anterior.
-
Estandarizar las cargas incrementales
Asegúrese de que cada carga filtre estrictamente por deltas reales en el origen, evitando escaneos completos de tablas históricas.
-
Aislar la historización en satélites
Almacene el historial en satélites Data Vault optimizados, de forma que los data marts de consulta solo lean el estado consolidado necesario.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
La otra cara de dbt: Proliferación de código, costes ocultos y automatización
dbt aportó modularidad y Git al código SQL y transformó la ingeniería analítica. A medida que los proyectos crecen, surge el dilema: la sobrecarga de infraestructura de Core frente a las tarifas por desarrollador de Cloud, a lo que se suman la brecha de ingesta y la acumulación de modelos manuales. Una plataforma basada en modelos supera esa contrapartida.
-
¿Por qué dbt le obliga a buscar otra herramienta antes de poder empezar a modelar?
dbt transforma datos que ya residen en su data warehouse. No extrae, no conecta ni carga nada desde los sistemas de origen. Para construir un data warehouse completo necesita una segunda herramienta para la ingesta, una tercera para la orquestación y una integración que las conecte. Una plataforma basada en modelos resuelve la ingesta y la transformación en un solo lugar.
-
¿Se ha convertido su DAG de dbt en una maraña imposible de depurar?
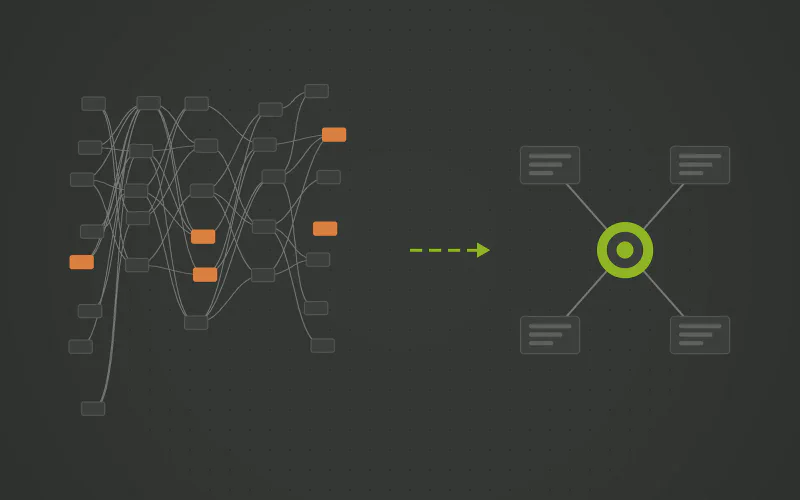
Crear un nuevo modelo en dbt es tan fácil que los repositorios acumulan rápidamente cientos de archivos SQL y dependencias difíciles de rastrear. Cuando un informe falla, seguir el rastro de un dato a través de capas intermedias encadenadas consume horas de trabajo. La solución es una arquitectura estructurada basada en modelos con reglas de derivación claras.
Preguntas y respuestas
- Porque son opcionales y deben escribirse a mano modelo a modelo, requiriendo definir correctamente una clave única, un filtro y a menudo una estrategia de merge compleja. En la práctica, muchos modelos se quedan como reconstrucciones completas porque la versión incremental nunca se finalizó. Una carga generada a satélite es incremental por su propio diseño.
- dbt State, introducido con el motor Fusion, omite los modelos cuyas entradas no han cambiado, y dbt Labs reporta ahorros significativos de cómputo gracias a ello. Decide si ejecutar un modelo, pero no cambia lo que hace el modelo cuando se ejecuta, de modo que una reconstrucción completa que se dispare sigue ejecutándose por entero.
- Las cargas son operaciones delta basadas en conjuntos generadas específicamente para el motor de destino. Solo procesan los registros que han cambiado, lo que en una noche típica representa una pequeña fracción de la fuente.