Zwingt Sie Ihr Fivetran-Schema, Ihr Datenmodell nach jedem Load neu aufzubauen?
Fivetran legt jede Quelle in ihrem eigenen standardisierten Schema ab. Business-Keys, eigene Felder und Legacy-Strukturen müssen danach in SQL umgeformt werden, das bricht, sobald sich der Connector ändert. Die Lösung ist kein besseres Skript, sondern ein Modell, das die Datenstruktur vorgibt.
Die Data-Warehouse-Automationsplattform, der Datenteams aus vielen Branchen vertrauen









Kommt Ihnen das bekannt vor?
- Jeder Connector legt sein eigenes Schema ab, und die Joins dazwischen werden von Hand geschrieben, pro Quelle, in SQL nach dem Load.
- Eine Spalte, die auf der Quellseite hinzugefügt oder umbenannt wird, bricht eine Woche später eine Transformation, in Produktion.
- Kunde, Produkt und Konto existieren dreimal mit drei verschiedenen Schlüsseln, und jeder Entwickler hat sie in seinem eigenen Stil abgeglichen.
- Die eigentliche Geschäftslogik ist über dbt-Modelle, Views und Notebooks verstreut, und niemand kann zeigen, wo eine Regel definiert ist.
Ein standardisiertes Schema pro Connector ist das, was eine Managed Pipeline schnell einrichtbar macht. Es ist auch das, was den zweiten Monat schwerer macht als den ersten. Die Form der Daten entscheidet der Connector, und alles, was Ihr Business tatsächlich braucht, konforme Schlüssel, eigene Felder, Regeln über drei Quellen hinweg, muss obendrauf gebaut werden, in dbt oder von Hand.
Warum das feste Schema gegen Sie arbeitet
- Das Schema gibt der Anbieter vor, nicht Ihr Fachbereich. Es spiegelt die API des Quellsystems, nicht die Art, wie das Business über Kunden, Aufträge oder Konten spricht.
- Die eigentliche Transformationslogik steckt in nachgelagerten SQL-Skripten, und die sind ungesteuert. Harmonisierung der Schlüssel, Deduplizierung, Umgang mit Historie und Regeln landen in Skripten, die niemand als Ganzes entworfen hat, jedes im Stil dessen, der es geschrieben hat.
- Änderungen im Quellsystem schlagen als Produktionsvorfälle auf. Eine im Quellsystem umbenannte Spalte ist eine gebrochene Transformation weiter unten, entdeckt erst, wenn ein Management-Report scheitert oder falsche Zahlen zeigt.
- Dieselbe Entität landet in Silos. Kunde aus dem CRM, Kunde aus dem ERP und Kunde aus dem Webshop sind drei Tabellen mit drei Schlüsseln, bis jemand den Join schreibt.
Nichts davon ist ein Fehler des Connectors. Es ist das, was passiert, wenn das Tool, das die Daten ablegt, ihnen auch noch eine Form geben soll, die das Business nutzen kann.
Wo die Form hingehört
- Die Datenstruktur ist eine Modellierungsaufgabe, keine Skriptaufgabe. Business-Keys, Beziehungen und Attribute sollten einmal deklariert werden, in einem Modell, und der Ladecode daraus abgeleitet werden.
- Die Rohschicht sollte Änderungen aufnehmen. Data Vault 2.0 trennt Schlüssel, Beziehungen und Kontext genau deshalb, damit ein neues Quellattribut ein neuer Satellit ist, kein Umbau.
- Regeln gehören über die Rohschicht. Konforme Dimensionen und Geschäftslogik sitzen im Business Vault und in den Marts, wo eine Änderung des Quellschemas sie nicht erreichen kann.
Was sich mit Datavault Builder ändert
Datavault Builder ersetzt das feste Zielschema durch eine modellgetriebene Data Vault 2.0 Schicht und generiert den Ladecode aus dem Modell.
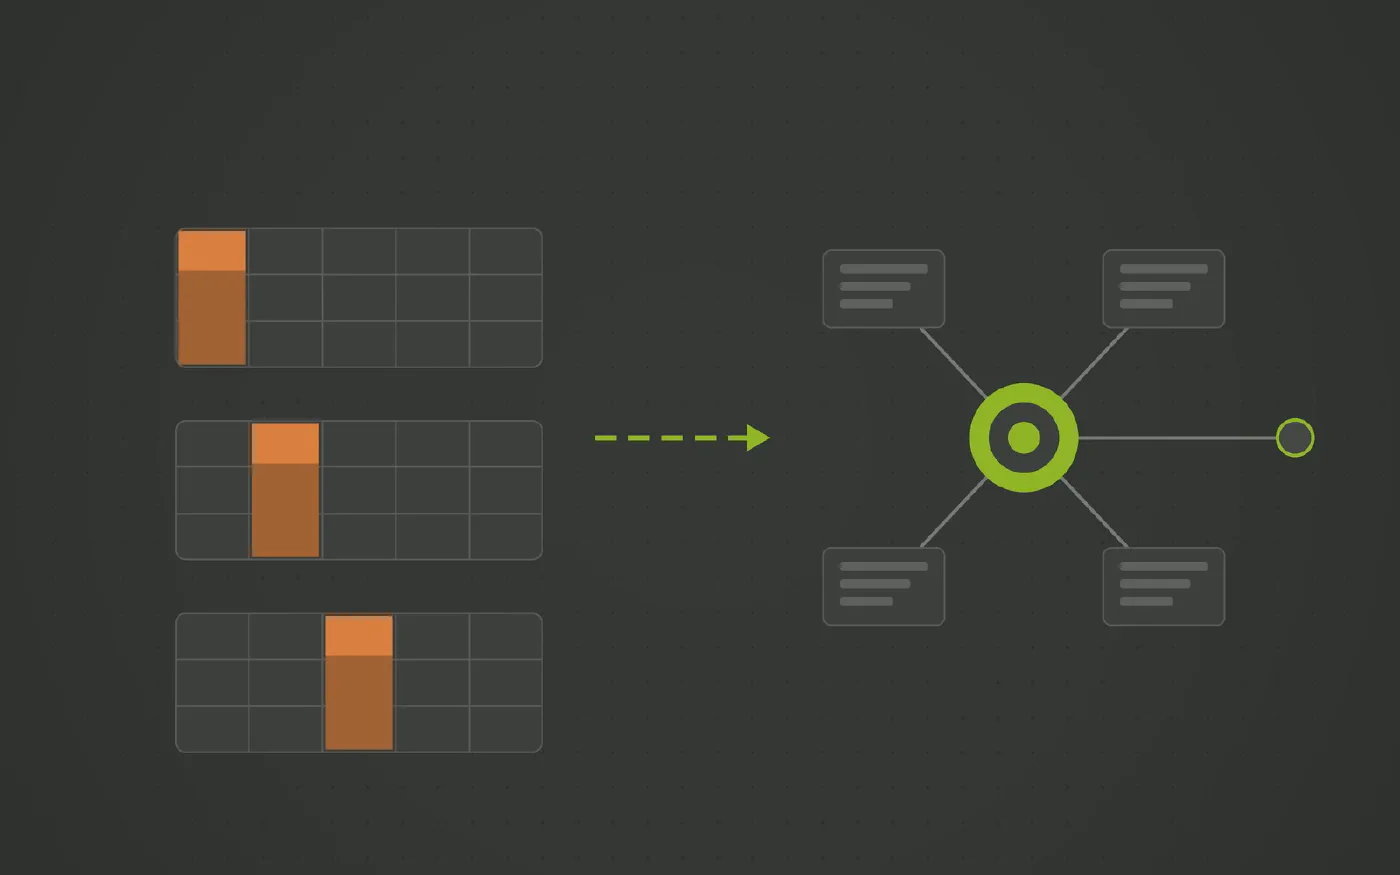
- Landing-Tabellen bleiben, wie der Connector sie liefert. Nichts wird von Hand umgeformt. Das Mapping von Landing-Tabelle auf Hub, Link und Satellit passiert visuell.
- Business-Keys werden zentral im Modell konsolidiert. Kunde aus drei Systemen wird ein Hub, mit dem Kontext jeder Quelle in ihrem eigenen Satelliten. Der Join wird einmal deklariert.
- Eine Quelländerung ist ein Mapping-Update. Mapping aktualisieren, neu generieren, und Business Vault und Marts darüber bleiben unberührt.
- Kleine Schema-Abweichungen werden automatisch abgefangen. Eine Spalte, die verschwindet, wird als Null mit einer Warnung geladen, nicht als gescheiterter Lauf. Ein Varchar, der wächst, wird verbreitert, nicht abgeschnitten.
- Jede Pipeline hat dieselbe Form. Die Loads sind generiert, es gibt also keinen Stil pro Entwickler zu reviewen und kein Skript, das nur sein Autor versteht.
- Dokumentation und Data Lineage entstehen automatisch mit. Jede Regel sitzt im Business Vault oder in der Mart-Schicht, ist im Modell sichtbar und lässt sich vom Report bis zur Quelle zurückverfolgen, ohne dass jemand sie aufschreibt.
- Das Ergebnis ist weiterhin ein Star-Schema. Dimensionale Marts werden obendrauf generiert, die BI-Schicht sieht also konforme Dimensionen, keine Vault-Interna.
Was zu entscheiden ist
Analysieren Sie die Post-Load-Skripte, die nur existieren, um den Connector-Output aufzubereiten: Harmonisierung der Schlüssel, Dedupe, Historie, Joins über Quellen hinweg. Diese Liste ist das Modell, das Sie bisher von Hand gepflegt haben. Es ist das Erste, was umziehen sollte.
Erleben Sie es live mit Ihren eigenen Datenquellen
Buchen Sie eine kostenlose Demo und bringen Sie den Connector mit, der Sie am meisten kostet, an Geld oder an Zeit.
In drei Schritten zu einer Pipeline, die Sie kontrollieren
-
Das Landing-Schema lassen, wie es ist
Was der Connector liefert, bleibt unverändert im Staging. Nichts wird von Hand umgeformt.
-
Auf das Modell abbilden, das Ihnen gehört
Business-Keys, Beziehungen und Attribute werden visuell in Hubs, Links und Satelliten gemappt.
-
Regeln in den Business Vault legen
Konforme Dimensionen und eigene Logik sitzen über dem Raw Vault, wo eine Quelländerung sie nicht erreichen kann.
Wie Datavault Builder die Reibungsverluste in der Ingestion beseitigt
-
Ingestion ist eingebaut
Batch-, Delta- und CDC-Ladevorgänge aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen, mit Streams wie Kafka, die als Micro-Batches ankommen. Dieselbe Plattform, die das Warehouse generiert, keine zweite Rechnung.
-
Ihr Schema, nicht das des Anbieters
Quelltabellen werden auf ein Data-Vault-2.0-Modell gemappt, das Sie entworfen haben. Eine neue Spalte oder eine umbenannte Tabelle ändert ein Mapping, keine Kette von Skripten nach dem Load.
-
Nur Deltas bewegen sich
Hubs, Links und Satelliten laden, was sich geändert hat. Vollständige Ladevorgänge bleiben im Staging, statt jede Nacht weiter unten neu verarbeitet zu werden.
-
Historie wird von Haus aus behalten
Jede Änderung wird so festgehalten, wie sie eintrifft. Historien- und Stichtagsabfragen funktionieren also auch dort, wo die Quelle ihre eigenen Zeilen überschreibt.
-
Code, den Sie nie von Hand schreiben
Laden, Historisierung und Lineage werden in Echtzeit aus dem Modell generiert und laufen nativ auf Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle oder PostgreSQL.
-
Eine Plattform, bis zu neun Tools weniger
Modellierung, ETL, CI/CD, Dokumentation und Lineage an einem Ort. Das ist es, was 14,7 Minuten von der Anforderung bis zur Produktion möglich macht.
Ausgezeichnet von BARC im Data Fabric Survey 26







Sprechen Sie mit unserem Experten
Zwanzig Minuten mit unserem Sales Director und eine ehrliche Antwort, ob das zu Ihrem Stack passt.

Matt Collett
Sales Director
Perfekt, wählen Sie einen passenden Termin:
Weitere Probleme in dieser Serie
-
Unerwartete Fivetran-Kosten und Schema-Probleme? Wie automatisierte Modellierung die Reibungsverluste in der Ingestion beseitigt
Plug-and-Play-ELT ist schnell gestartet und schwer zu kontrollieren. Zwei Dinge erodieren mit der Zeit: was die Pipeline kostet, und wer über die Struktur der Daten entscheidet. Eine automatisierte Data Vault Schicht gibt beides zurück, ohne die Connectors aufzugeben, die funktionieren.
-
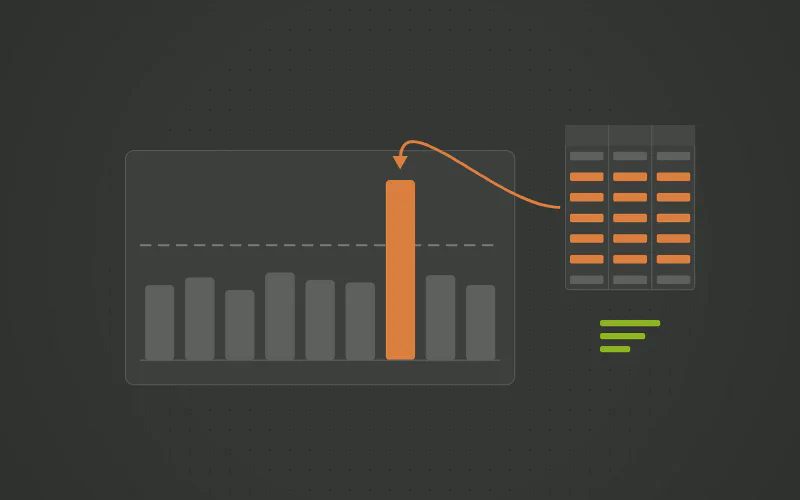
Explodiert Ihre Fivetran-Rechnung jedes Mal, wenn sich in einer Quelltabelle viel bewegt?
Fivetran rechnet nach Monthly Active Rows ab. Ein Bulk-Update oder eine Schemamigration im Quellsystem berührt jede Zeile erneut, und die Rechnung folgt. Die Zeilen waren nie das Problem. Teuer wird es, wenn Sie pro Zeile für Daten zahlen, die Sie anschließend ohnehin selbst noch einmal verarbeiten.
Fragen und Antworten
- Es ersetzt den handgeschriebenen Teil: die Staging-Modelle, die Harmonisierung der Schlüssel und die Historisierung, die am Ende jedes Team schreibt. Der generierte Vault und die Marts sind gewöhnliche Tabellen und Views in Ihrem Warehouse, alles, was Sie in dbt behalten, kann also daraus lesen.
- Die Landing-Tabelle ändert sich, das Mapping wird im Modell aktualisiert, und der Ladecode wird neu generiert. Nichts unterhalb des Raw Vault wird angefasst, weil Business Vault und Marts das Modell lesen, nicht die Quelle.
- Die Rohschicht ist Data Vault 2.0, und genau das lässt sie Quelländerungen aufnehmen. Darüber generiert Datavault Builder dimensionale oder 3NF Marts, das Business sieht also ein Star-Schema.