Unerwartete Fivetran-Kosten und Schema-Probleme? Wie automatisierte Modellierung die Reibungsverluste in der Ingestion beseitigt
Plug-and-Play-ELT ist schnell gestartet und schwer zu kontrollieren. Zwei Dinge erodieren mit der Zeit: was die Pipeline kostet, und wer über die Struktur der Daten entscheidet. Eine automatisierte Data Vault Schicht gibt beides zurück, ohne die Connectors aufzugeben, die funktionieren.
Die Data-Warehouse-Automationsplattform, der Datenteams aus vielen Branchen vertrauen









Der erste Fivetran-Monat ist ein guter Monat. Connectors sind an einem Nachmittag live, das Warehouse füllt sich, und das Team macht sich ans Bauen. Die Rechnung, die nach der ersten ERP Migration eintrifft, ist der Moment, in dem sich das Gespräch ändert, und das Gespräch über das Schema beginnt meist im selben Quartal.
Der Tausch, den Plug-and-Play-ELT eingeht
Managed Ingestion tauscht zwei Dinge gegen Komfort, und keines davon zeigt sich am ersten Tag.
- Keine Kostensicherheit. Monthly Active Rows messen, was sich ändert, und was sich ändert, entscheiden Quellsystem-Teams mit ihren Migrationen und Bulk-Updates. Die Rechnung folgt deren Projektkalender, nicht Ihrem Budget. Die Details stehen in dem Artikel über MAR-Kosten.
- Schemakontrolle. Jeder Connector legt sein eigenes standardisiertes Schema ab. Konforme Schlüssel, eigene Felder und Regeln über Quellen hinweg müssen obendrauf gesetzt werden und brechen, wenn sich die Quelle ändert. Die Details stehen in dem Artikel über feste Schemata.
Beides ist dasselbe zugrunde liegende Problem. Das Tool, das die Zeilen bewegt, wurde auch dafür verantwortlich gemacht, was sie kosten und welche Form sie annehmen, und es war immer nur für die erste Aufgabe gebaut.
Zwei Auswege, und Sie können beide nehmen
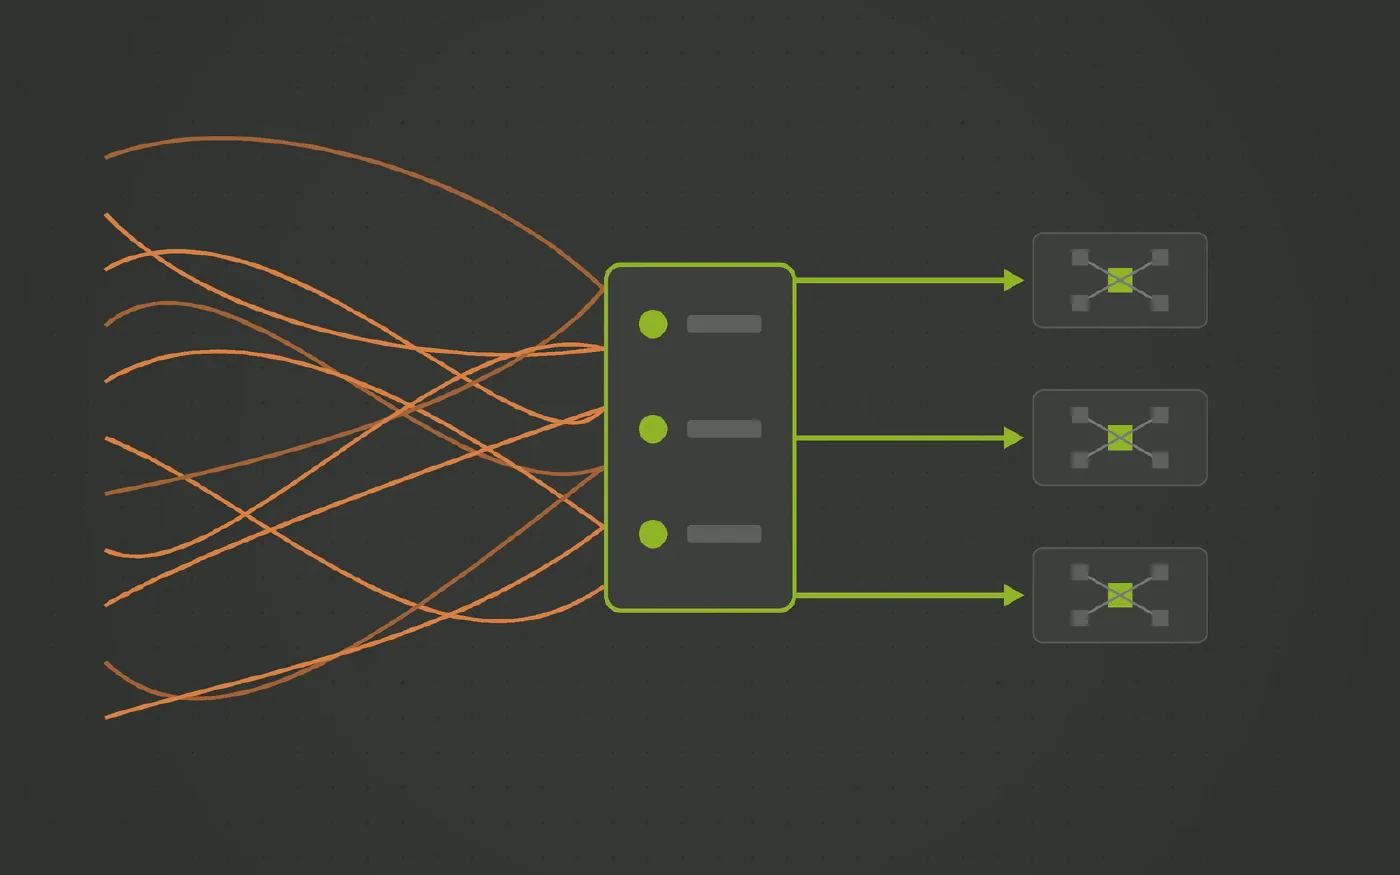
Übernehmen Sie die Ingestion für die datenintensiven Tabellen selbst. Datavault Builder bringt Batch, Delta und CDC Loads aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen mit, mit Streams wie Kafka, die als Micro-Batches ankommen. Die Handvoll Tabellen, die den Großteil der MAR tragen, landen über die Plattform, auf Compute, das Ihnen bereits gehört. Der Long-Tail der SaaS-Quellen bleibt auf dem Connector, wo er günstig ist.
Legen Sie ein Modell, das Ihnen gehört, hinter alles. Was immer im Staging landet, per Connector oder per direktem Load, wird visuell in ein Data Vault 2.0 Modell gemappt: Hubs für Business-Keys, Links für Beziehungen, Satelliten für Kontext und Historie. Der Ladecode wird aus diesem Modell generiert. Eine Quelländerung ist ein Mapping-Update, und Business Vault und Marts darüber bewegen sich nicht.
Was das in der Praxis ändert
- Full Rebuilds bleiben auf das Staging beschränkt. Nur das Delta wird in den Vault geladen, ein Full Reload im Quellsystem ist also kein Full Reload jeder Schicht.
- Ein Kunde ist ein zentraler Hub, nicht drei verstreute Tabellen. Schlüssel über Quellen hinweg werden im Modell harmonisiert, einmal, mit Lineage.
- Geschäftslogik hat einen festen Ort. Geschäftslogik lebt im Business Vault oder in der Mart-Schicht, sichtbar im Modell, nicht verstreut über Skripte und Notebooks.
- Die BI-Schicht sieht ein Star-Schema. Dimensionale Marts werden obendrauf generiert, nichts vom Vault erreicht also einen Reporting-Autor.
- Kosten werden zu einer Entscheidung über die Dimensionierung. Warehouse Compute ist messbar und reservierbar. Zeilenaktivität im System von jemand anderem nicht.
Wo Sie anfangen
Zwei Analysen, ein Nachmittag Aufwand: Der nach Tabelle sortierte MAR-Report sagt Ihnen, welche Quellen auf direkte Ingestion umziehen sollten. Das Inventar der Skripte nach dem Load, die nur existieren, um den Connector-Output aufzubereiten, sagt Ihnen, was das Modell enthalten muss. Beide Listen sind meist kürzer als erwartet, und beide sind das ganze Projekt.
Erleben Sie es live mit Ihren eigenen Datenquellen
Buchen Sie eine kostenlose Demo und bringen Sie den Connector mit, der Sie am meisten kostet, an Geld oder an Zeit.
Wie Datavault Builder die Reibungsverluste in der Ingestion beseitigt
-
Ingestion ist eingebaut
Batch-, Delta- und CDC-Ladevorgänge aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen, mit Streams wie Kafka, die als Micro-Batches ankommen. Dieselbe Plattform, die das Warehouse generiert, keine zweite Rechnung.
-
Ihr Schema, nicht das des Anbieters
Quelltabellen werden auf ein Data-Vault-2.0-Modell gemappt, das Sie entworfen haben. Eine neue Spalte oder eine umbenannte Tabelle ändert ein Mapping, keine Kette von Skripten nach dem Load.
-
Nur Deltas bewegen sich
Hubs, Links und Satelliten laden, was sich geändert hat. Vollständige Ladevorgänge bleiben im Staging, statt jede Nacht weiter unten neu verarbeitet zu werden.
-
Historie wird von Haus aus behalten
Jede Änderung wird so festgehalten, wie sie eintrifft. Historien- und Stichtagsabfragen funktionieren also auch dort, wo die Quelle ihre eigenen Zeilen überschreibt.
-
Code, den Sie nie von Hand schreiben
Laden, Historisierung und Lineage werden in Echtzeit aus dem Modell generiert und laufen nativ auf Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle oder PostgreSQL.
-
Eine Plattform, bis zu neun Tools weniger
Modellierung, ETL, CI/CD, Dokumentation und Lineage an einem Ort. Das ist es, was 14,7 Minuten von der Anforderung bis zur Produktion möglich macht.
Ausgezeichnet von BARC im Data Fabric Survey 26







Sprechen Sie mit unserem Experten
Zwanzig Minuten mit unserem Sales Director und eine ehrliche Antwort, ob das zu Ihrem Stack passt.

Matt Collett
Sales Director
Perfekt, wählen Sie einen passenden Termin:
Weitere Probleme in dieser Serie
-
Zwingt Sie Ihr Fivetran-Schema, Ihr Datenmodell nach jedem Load neu aufzubauen?
Fivetran legt jede Quelle in ihrem eigenen standardisierten Schema ab. Business-Keys, eigene Felder und Legacy-Strukturen müssen danach in SQL umgeformt werden, das bricht, sobald sich der Connector ändert. Die Lösung ist kein besseres Skript, sondern ein Modell, das die Datenstruktur vorgibt.
-
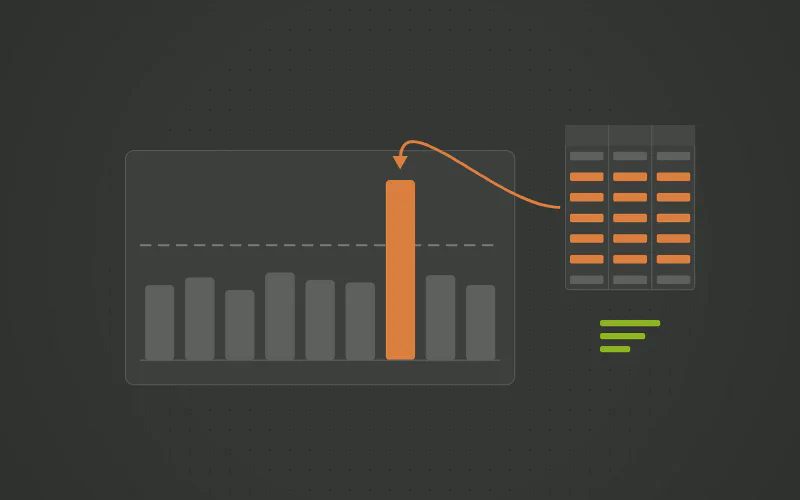
Explodiert Ihre Fivetran-Rechnung jedes Mal, wenn sich in einer Quelltabelle viel bewegt?
Fivetran rechnet nach Monthly Active Rows ab. Ein Bulk-Update oder eine Schemamigration im Quellsystem berührt jede Zeile erneut, und die Rechnung folgt. Die Zeilen waren nie das Problem. Teuer wird es, wenn Sie pro Zeile für Daten zahlen, die Sie anschließend ohnehin selbst noch einmal verarbeiten.
Fragen und Antworten
- Nein. Es ist ein Argument dafür, den Connector nicht länger über Ihre Kosten und Ihr Schema entscheiden zu lassen. Behalten Sie ihn dort, wo er günstig und bequem ist, verlagern Sie die teuren Tabellen auf direkte Ingestion, und legen Sie ein Modell, das Ihnen gehört, hinter beides.
- Die Landing-Tabellen existieren bereits, die Arbeit ist also Modellierung, nicht Extraktion. Die 14,7 Minuten von der Anforderung bis zur Produktion beziehen sich auf das Hinzufügen einer Änderung, sobald das Modell steht; das initiale Mapping einer Quelle wird in Tagen gemessen, nicht in Quartalen.