¿Provocan las Monthly Active Rows (MAR) de Fivetran sustos en su presupuesto mensual?
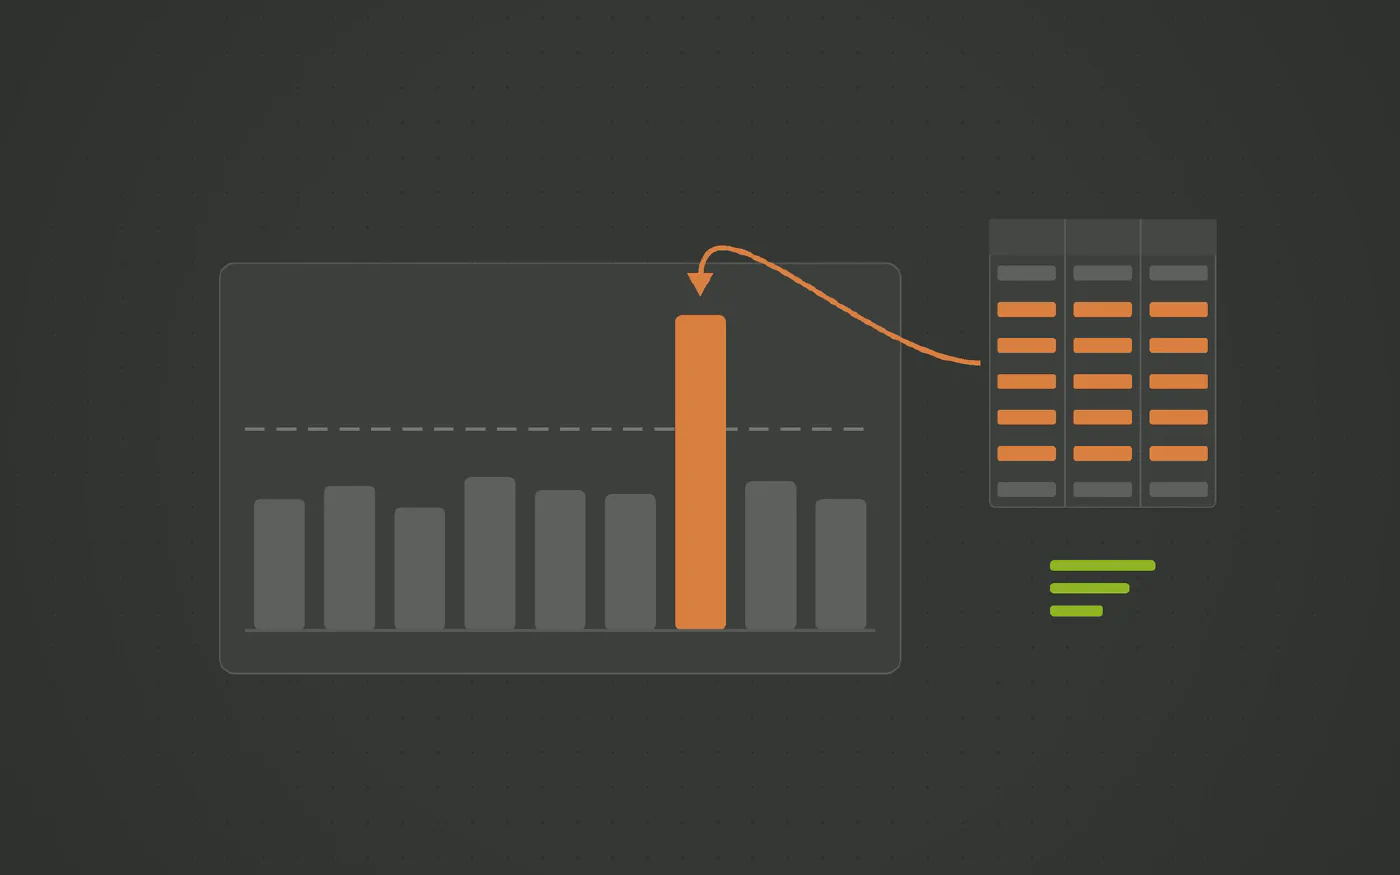
Fivetran factura por Monthly Active Rows (MAR): filas insertadas o actualizadas en cada mes. Una actualización masiva en el origen, una migración o una recarga histórica multiplican el recuento y disparan la factura. La ingesta directa en el warehouse, unida a un vault que solo mueva deltas, mantiene los costes predecibles.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- La factura mensual de Fivetran aumentó abruptamente tras una actualización masiva de datos en el ERP o CRM de origen.
- El equipo de ingeniería evita deliberadamente sincronizar tablas históricas completas por temor al impacto en el recuento de MAR.
- Resulta imposible anticipar con exactitud el coste del servicio para el siguiente trimestre, lo que complica la planificación presupuestaria.
- Se pagan licencias por fila para mover datos entre bases de datos internas que residen en la misma red o nube de la empresa.
El modelo de facturación basado en Monthly Active Rows (MAR) es comprensible desde la óptica de un proveedor SaaS: mide el volumen de datos en movimiento contabilizando cada fila distinta insertada o modificada a lo largo del mes.
El problema surge cuando ese modelo choca con los ritmos reales de los sistemas empresariales.
Por qué las MAR generan volatilidad presupuestaria
- Actualizaciones masivas operacionales. Una simple actualización en el CRM para corregir un prefijo telefónico o reasignar códigos postales modifica millones de registros existentes. Para el negocio no hay datos nuevos, pero para el conector representa millones de MAR a facturar.
- Migraciones y limpiezas de datos. Migrar de versión de ERP o aplicar una limpieza de datos en origen toca prácticamente todas las filas de las tablas maestras, multiplicando la factura de ese periodo.
- Incentivos perversos para el equipo de datos. Los ingenieros se ven obligados a filtrar columnas o restringir sincronizaciones para contener costes, privando al negocio de datos valiosos para el análisis.
- Pagar peajes por datos propios. Facturar por fila tiene sentido al extraer datos de APIs SaaS complejas; pagar por fila para mover datos entre dos bases de datos que residen en su propia infraestructura resulta ineficiente.
Hacia un modelo de costes predecible
Un entorno de datos sostenible requiere desacoplar el crecimiento analítico del pago variable por fila:
- Ingesta nativa para fuentes de alto volumen. Las bases de datos operacionales, los archivos masivos y los flujos continuos deben cargarse directamente mediante conexiones de base de datos (JDBC) o CDC sin intermediarios que cobren por registro.
- Filtrado estricto de deltas en el warehouse. Una recarga completa en staging no debe provocar una reescritura completa en el almacén histórico. El modelado Data Vault compara huellas hash y almacena únicamente las filas que realmente presentan cambios de contenido.
- Coste basado en capacidad, no en transacciones. El dimensionamiento de la infraestructura analítica se gestiona en su propio almacén cloud, con presupuestos fijos y reservas previsibles.
La solución con Datavault Builder
Datavault Builder devuelve la predictibilidad económica a su arquitectura:
- Ingesta incorporada sin peajes por fila. Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST y streaming (Kafka en micro-batches) incluidas en la plataforma.
- Absorción inteligente de recargas. Si una fuente vuelca una tabla completa, los satélites de Datavault Builder identifican los registros auténticamente modificados, evitando reprocesar datos redundantes en los marts.
- Coste de software transparente. Licenciamiento de servidor claro y fijo, sin sorpresas a fin de mes por fluctuaciones en el volumen transaccional de sus aplicaciones.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Identificar los generadores de MAR
Localice las tablas con altas frecuencias de actualización o procesos masivos que concentran la mayor parte de las filas activas mensuales.
-
Ingestar bases de datos sin peaje por fila
Asuma la ingesta de bases de datos internas mediante conexiones directas (JDBC, CDC) integradas en la plataforma de automatización.
-
Aislar las recargas completas en staging
Almacene las recargas brutas en staging y utilice Data Vault para mover únicamente los deltas reales hacia el modelo histórico.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
¿Problemas de coste y rigidez de esquema en Fivetran? La automatización del modelado es la respuesta
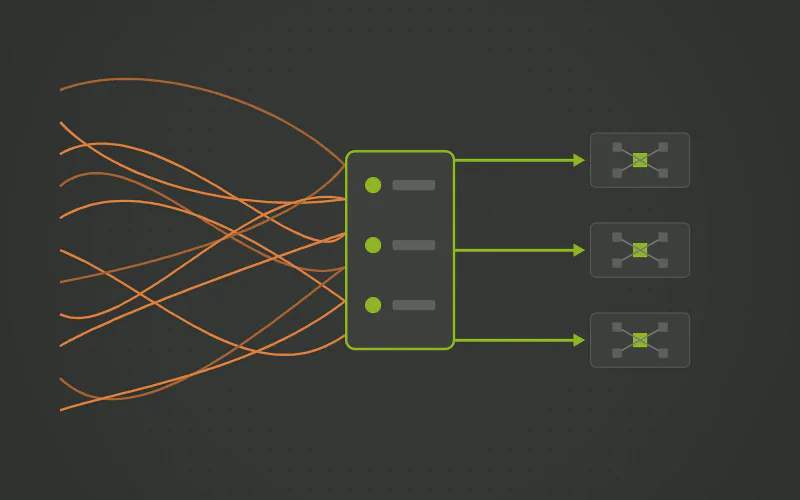
El ELT plug and play es rápido de iniciar y complejo de controlar a escala. Dos factores se degradan con el tiempo: el coste del pipeline y el control sobre la estructura de los datos. Una capa de Data Vault automatizada recupera ambos sin renunciar a los conectores existentes.
-
¿Sigue limpiando a mano en SQL los esquemas que Fivetran carga de forma automática?
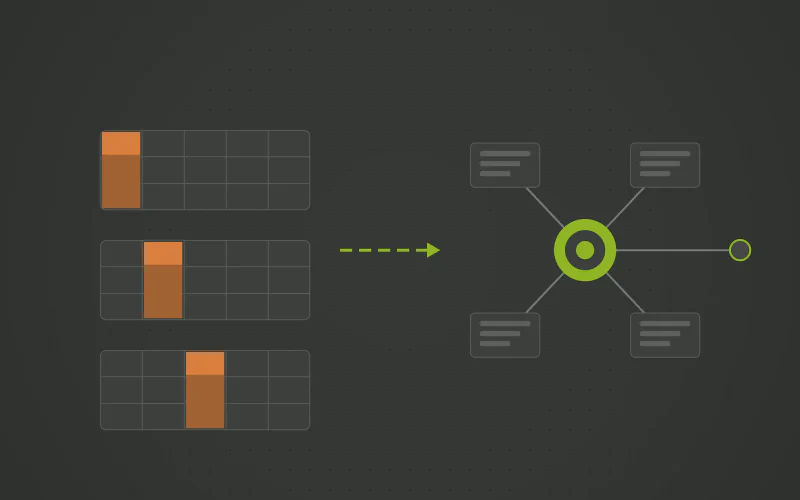
Fivetran carga cada fuente en un esquema predefinido por el proveedor. Las claves de negocio, los campos personalizados y las estructuras históricas deben remodelarse mediante SQL manual que se rompe cuando el conector cambia. La solución no es un script más elaborado, sino un modelo que gobierne la estructura.
Preguntas y respuestas
- No necesariamente. Muchos equipos conservan los conectores para la larga cola de fuentes SaaS y trasladan a ingesta directa únicamente las tablas voluminosas y costosas. El vault se sitúa detrás de ambas opciones, por lo que al modelo de negocio le es indiferente la vía por la que llegaron los datos.
- La documentación de Fivetran establece que la sincronización histórica inicial y las recargas forzadas por el conector están exentas de MAR. Sin embargo, las actualizaciones masivas ejecutadas en los sistemas de origen, las migraciones de datos operacionales y los procesos de backfill sí modifican filas y se facturan íntegramente como MAR. Además, aguas abajo en el warehouse, cualquier recarga no incremental obliga a pagar computación adicional para reprocesar datos inalterados.
- Consumen computación en su propio data warehouse, una capacidad que ya paga y puede dimensionar. Lo que desaparece por completo es el recargo por fila facturado por un proveedor intermediario, así como el reprocesamiento innecesario de filas sin cambios aguas abajo.