¿Ha superado el lienzo de Azure Data Factory la capacidad de gestión de su equipo?
Un pipeline construido mediante arrastrar y soltar se crea rápido, pero se adapta con lentitud. Al superar unas docenas de actividades, el lienzo se convierte en la documentación, las conexiones reemplazan a la lógica de negocio y cada nuevo origen es otra actividad de copia que nadie quiere tocar. La solución no es un lienzo más ordenado, sino un modelo que genere los pipelines.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- Abrir el pipeline principal de orquestación lleva varios minutos, y localizar una actividad concreta dentro del lienzo, otros tantos.
- Una pequeña modificación en una tabla exige abrir y editar manualmente tres pipelines y dos datasets compartidos.
- Nadie en el equipo se atreve a eliminar actividades antiguas por miedo a romper dependencias ocultas.
- Incorporar una nueva fuente implica clonar pipelines existentes, propagando errores y convenciones desactualizadas.
El editor visual de Azure Data Factory es una excelente herramienta para crear los primeros flujos de datos. La interfaz es intuitiva y permite conectar orígenes con destinos en pocos pasos. El problema surge con el paso del tiempo: cuando el data warehouse crece y acumula cientos de tablas, el lienzo visual deja de ser una ayuda y se convierte en un cuello de botella.
El límite del desarrollo visual en cajas
- El lienzo se convierte en la documentación. Al no existir código explícito, la única manera de entender qué hace un pipeline es abrir decenas de cajas una por una, inspeccionar parámetros, revisar las consultas y seguir las líneas de conexión.
- El mantenimiento es artesanal. Añadir una columna común o modificar un formato de auditoría obliga a actualizar decenas de actividades repartidas por muchos pipelines.
- Las dependencias cruzadas son un riesgo. Los datasets y linked services compartidos facilitan la reutilización inicial, pero ocultan qué otros pipelines dependen de ellos cuando se aplica un cambio.
- Revisar los cambios es casi imposible. Comparar dos versiones de un pipeline en Git obliga a leer miles de líneas de JSON generado por la herramienta visual, en lugar de un diff comprensible de lógica de negocio.
Por qué ordenar el lienzo no es la respuesta
Muchos equipos intentan solucionar esto mediante plantillas estándar, subpipelines o marcos basados en metadatos y tablas de control. Aunque estas iniciativas ayudan, terminan consumiendo semanas de desarrollo en mantener la infraestructura interna de la plataforma en lugar de entregar datos fiables al negocio.
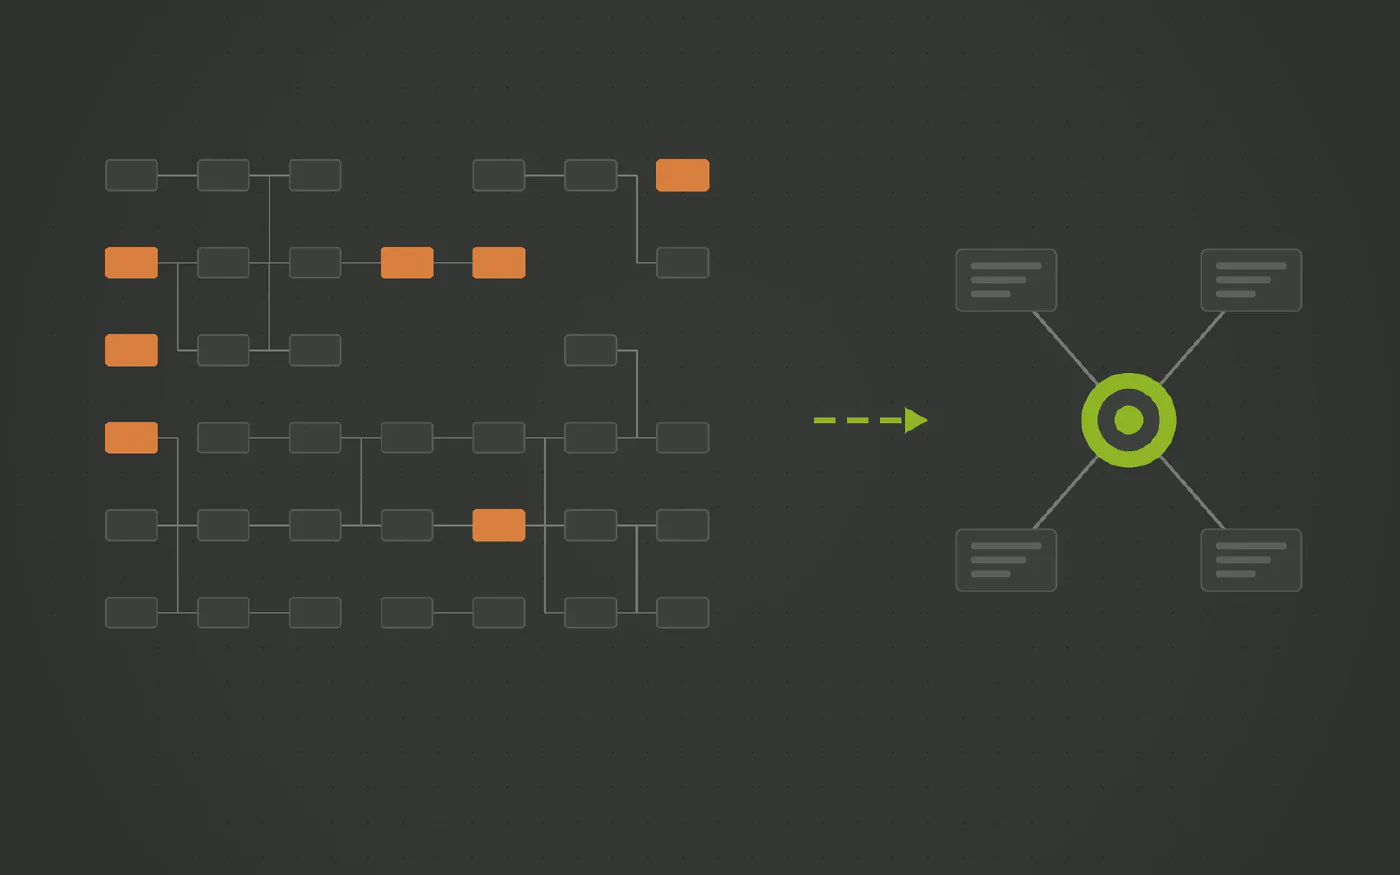
La solución estructural es sencilla: separar la definición del negocio de su implementación técnica. Los ingenieros de datos deben modelar qué datos existen y cómo se relacionan; los pipelines técnicos que los mueven y los transforman deben generarse a partir de ese modelo.
Qué cambia con Datavault Builder
Datavault Builder proporciona un entorno de modelado conceptual que genera automáticamente todas las cargas de datos necesarias para su base de datos.
- Diseño centrado en el modelo. Las tablas se mapean visualmente a conceptos de negocio (hubs, links, satélites). Las relaciones se declaran una sola vez.
- Pipelines autogenerados y uniformes. Cada carga sigue exactamente los mismos estándares de ingeniería, gestión de errores y rendimiento, de modo que desaparecen los estilos distintos de cada desarrollador.
- Gestión automática de cambios. Si una fuente cambia o se amplía un campo, el modelo actualiza la carga sin tener que modificar a mano ningún diagrama de flujo.
- Trazabilidad y documentación viva. El linaje de extremo a extremo se obtiene directamente del propio modelo, sin depender de anotaciones manuales en un lienzo.
Evaluación práctica
Revise el pipeline más complejo de su entorno de producción actual. Pregúntese cuánto tiempo le llevaría a un ingeniero recién incorporado al equipo entender su funcionamiento y modificarlo con total seguridad. Si la respuesta se mide en días o semanas, su equipo ha superado la escala para la que fue concebido el desarrollo visual en cajas.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Contar los pipelines que solo mueven y cargan datos
Distinga entre el mero transporte de datos y las transformaciones de negocio. La mayoría de los pipelines solo mueven filas sin aportar valor analítico.
-
Declarar el modelo una sola vez
Defina las entidades y relaciones del negocio visualmente en un modelo centralizado, en lugar de dispersarlas en decenas de diagramas de flujo.
-
Generar los flujos técnicos automáticamente
Permita que la plataforma genere los pipelines de carga, historización y publicación directamente desde el modelo validado.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
Puntos débiles de Azure Data Factory: el coste oculto de los pipelines visuales y de Spark
Azure Data Factory es una buena capa de transporte dentro de Azure y un lugar inadecuado para almacenar la lógica de un data warehouse. Usarlo como suite de modelado y transformación genera lienzos imposibles de interpretar, releases que fallan en plantillas ARM y clústeres Spark para cargas que caben en una consulta SQL. Y cada pipeline queda atado a Azure.
-
¿Cuestan sus Mapping Data Flows de Azure Data Factory más que los datos que mueven?
Los Mapping Data Flows se ejecutan sobre un clúster de Spark gestionado que tarda varios minutos en arrancar y factura por hora de vCore. Para una gran transformación nocturna tiene sentido. Para unos pocos cientos de miles de filas, es un clúster arrancado para hacer lo que una sola sentencia SQL resolvería dentro del data warehouse.
-
¿Cada release de Azure Data Factory se convierte en una batalla de plantillas ARM?
Bajo el editor visual, una Azure Data Factory es puro código JSON: pipelines, datasets, linked services y la plantilla ARM que los despliega. Pasar un cambio de Dev a Prod exige archivos de parámetros, parámetros globales y una plantilla que falla ante el menor conflicto de tipos. Las releases deberían generarse a partir de un modelo, con el rollback incluido.
Preguntas y respuestas
- No. ADF es una buena capa de transporte y disparador dentro de Azure. El argumento es que utilizarla como capa de modelado y transformación sitúa cientos de actividades conectadas a mano donde debería haber un modelo generado.
- Eliminan la necesidad de duplicar pipelines por cada fuente, lo cual es un avance. Sin embargo, dejan en sus manos un framework hecho a medida que debe mantener manualmente: tablas de control, pipelines genéricos dinámicos y convenciones que solo su equipo conoce. Además, solo cubren la copia de datos; las claves, la historización y los data marts siguen residiendo en otra parte. Un generador especializado es ese mismo framework, pero probado y mantenido como producto para todo el data warehouse.
- Datavault Builder orquesta sus propias cargas: un trabajo ejecuta un conjunto de ellas en el orden adecuado, con registro y reinicio integrados. ADF puede disparar ese trabajo y seguir moviendo archivos entre servicios de Azure. Podría invocar cargas individuales a través de la API, pero no tiene sentido reconstruir la orquestación fuera de la plataforma que ya la incluye. Usted describe el negocio en el modelo y las estructuras y cargas se generan a partir de él. Lo que queda en el lienzo es el movimiento de archivos y un disparador.
- La dirección de Microsoft es Fabric, y Fabric Data Factory mantiene exactamente el mismo lienzo: las mismas actividades, bucles y expresiones, por lo que el argumento de este artículo es el mismo con cualquiera de las dos Data Factory. Lo que no mantiene es el resto: sin paso de publicación ARM, sin Mapping Data Flows, con Dataflow Gen2 y elementos sincronizados con Git, facturados por unidades de capacidad. El data warehouse generado se ejecuta en Fabric de forma nativa en cualquiera de los casos.