¿Cuestan sus Mapping Data Flows de Azure Data Factory más que los datos que mueven?
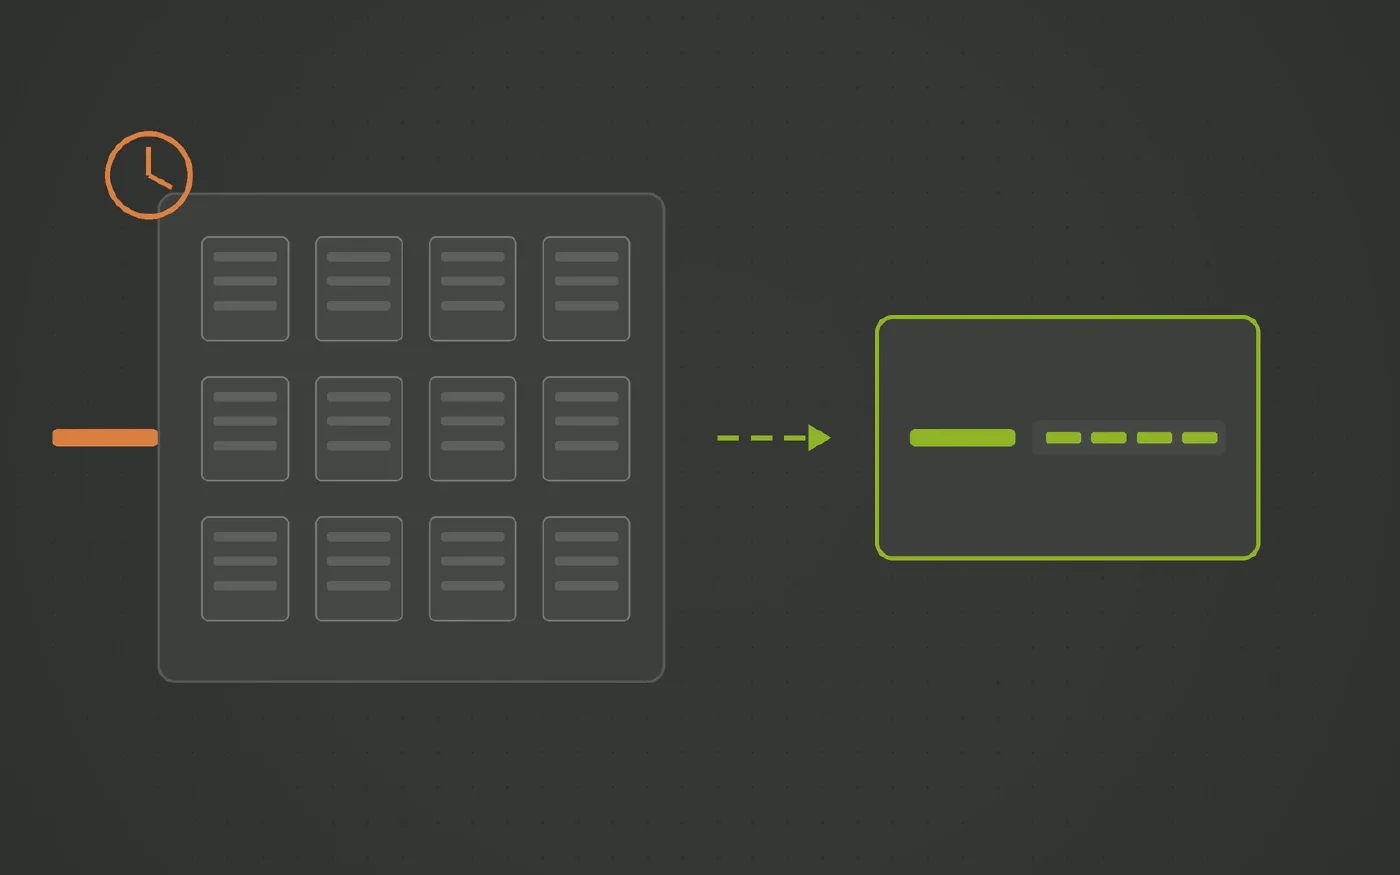
Los Mapping Data Flows se ejecutan sobre un clúster de Spark gestionado que tarda varios minutos en arrancar y factura por hora de vCore. Para una gran transformación nocturna tiene sentido. Para unos pocos cientos de miles de filas, es un clúster arrancado para hacer lo que una sola sentencia SQL resolvería dentro del data warehouse.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
- La factura de Azure Data Factory está dominada por Data Factory Runtime, no por las actividades de copia ni las orquestaciones.
- Un pipeline tarda siete minutos en procesar 50.000 filas: cuatro minutos y medio esperando el arranque de Spark y dos minutos y medio de ejecución.
- Para evitar arranques en frío se habilita el Time to Live (TTL), y la factura sigue aumentando incluso cuando no hay datos en movimiento.
- Escribir joins y transformaciones en la interfaz visual parecía más rápido que SQL, pero nadie puede auditar lo que se genera por debajo.
Los Mapping Data Flows son la vía que ofrece Azure Data Factory para transformar datos sin código, y en las demostraciones resultan impecables: columnas calculadas, joins y agregaciones configuradas visualmente que por debajo se compilan en código Spark.
Por qué la factura se dispara
- Cada ejecución arrastra un coste de arranque fijo. Un clúster de Spark tarda minutos en adquirir nodos y arrancar su runtime. Para procesar 50 millones de filas ese arranque se diluye. Para 50.000 filas, el arranque representa la mayor parte de la factura.
- La inactividad también se paga. Si habilita Time to Live (TTL) para evitar arranques en frío recurrentes, pagará por el clúster mientras permanece inactivo esperando el siguiente pipeline.
- Los datos salen de la base de datos. Un join entre dos tablas que ya residen en su base de datos extrae los datos hacia Spark, los combina en memoria fuera de ella y los vuelve a escribir en la base de datos. Está pagando por computación externa y movimiento de datos para una operación que la base de datos ejecuta de forma nativa.
- Las cargas pequeñas y frecuentes son la norma. La mayoría de las cargas de data warehouse son incrementales: unos pocos miles de filas modificadas en la última hora. Spark está dimensionado para la excepción, no para este patrón diario.
Nada de esto es un fallo de los Data Flows. Spark está pensado para transformaciones pesadas. Las cargas estándar de un data warehouse no son pesadas; son simplemente constantes.
Dónde debe ejecutarse la transformación
- Donde ya residen los datos. Si la tabla de staging y el modelo residen en Snowflake, Fabric, Azure SQL o Databricks, la transformación debe ser una sentencia SQL en el motor.
- Basada en conjuntos, no en memoria distribuida. Un merge relacional estándar aprovecha los índices y las particiones que la base de datos ya optimiza.
- Generada, no escrita a mano. La ventaja del Data Flow era no escribir código a mano. Un generador de data warehouse ofrece esa misma ventaja visual, pero genera SQL optimizado para el motor en lugar de llamadas a clústeres Spark.
Qué cambia con Datavault Builder
Datavault Builder modela el data warehouse visualmente y genera código SQL de carga basado en conjuntos que se ejecuta directamente en su base de datos de destino.
- Sin clúster que arrancar. Las cargas son consultas e inserciones ejecutadas por el motor que ya contiene los datos. Sin tiempos de arranque ni costes por inactividad.
- Las transformaciones residen en el motor. Staging a vault, vault a marts: cada carga es SQL adaptado a las capacidades nativas de Snowflake, Azure SQL, Fabric o Databricks.
- El cómputo es una decisión de dimensionamiento. La capacidad del data warehouse es algo que usted ya reserva y planifica, no una tarifa por hora de vCore que fluctúa con cada ejecución de un pipeline.
- Spark solo donde aporta valor. Conserve Spark o Databricks para analítica avanzada, machine learning o procesamiento no estructurado; retire de allí las cargas relacionales estándar.
Qué decidir
Revise las diez actividades de Mapping Data Flows más costosas de su entorno. Compare el volumen de filas que procesan con los vCores que consumen. Si la mayoría procesa menos de un millón de filas por ejecución, una plataforma basada en modelos puede devolver esa carga al motor de datos existente y reducir la factura de Data Factory.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Listar los Data Flows según las filas procesadas
Ordene los Mapping Data Flows por volumen. Cualquier flujo por debajo de un millón de filas por ejecución probablemente esté pagando un sobrecoste de Spark innecesario.
-
Trasladar la ejecución al data warehouse
Ejecute las transformaciones de forma nativa en la base de datos de destino mediante sentencias SQL basadas en conjuntos generadas desde un modelo.
-
Reservar Spark para lo que realmente lo exige
Las transformaciones verdaderamente masivas o no estructuradas pueden permanecer en un clúster. Las cargas estándar de data warehouse no lo necesitan.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
Puntos débiles de Azure Data Factory: el coste oculto de los pipelines visuales y de Spark
Azure Data Factory es una buena capa de transporte dentro de Azure y un lugar inadecuado para almacenar la lógica de un data warehouse. Usarlo como suite de modelado y transformación genera lienzos imposibles de interpretar, releases que fallan en plantillas ARM y clústeres Spark para cargas que caben en una consulta SQL. Y cada pipeline queda atado a Azure.
-
¿Cada release de Azure Data Factory se convierte en una batalla de plantillas ARM?
Bajo el editor visual, una Azure Data Factory es puro código JSON: pipelines, datasets, linked services y la plantilla ARM que los despliega. Pasar un cambio de Dev a Prod exige archivos de parámetros, parámetros globales y una plantilla que falla ante el menor conflicto de tipos. Las releases deberían generarse a partir de un modelo, con el rollback incluido.
-
¿Ha superado el lienzo de Azure Data Factory la capacidad de gestión de su equipo?
Un pipeline construido mediante arrastrar y soltar se crea rápido, pero se adapta con lentitud. Al superar unas docenas de actividades, el lienzo se convierte en la documentación, las conexiones reemplazan a la lógica de negocio y cada nuevo origen es otra actividad de copia que nadie quiere tocar. La solución no es un lienzo más ordenado, sino un modelo que genere los pipelines.
Preguntas y respuestas
- Elimina la espera manteniendo el clúster caliente, y factura por ese clúster caliente. El coste se traslada del tiempo de arranque al tiempo de inactividad. La verdadera pregunta es por qué una carga estándar de data warehouse necesita un clúster en primer lugar.
- No. Azure Data Factory ejecuta los Mapping Data Flows sobre su propio clúster de Spark gestionado, no sobre un área de trabajo de Databricks existente. Si ya cuenta con Databricks, está pagando dos entornos de Spark independientes.
- Las actividades de Stored Procedure y Script hacen exactamente eso y representan una comparación justa. El problema radica en usar Mapping Data Flows para cargas comunes, y en que los procedimientos que dichas actividades invocan se escriben y mantienen a mano, tabla por tabla. Una carga generada ofrece ejecución nativa en el motor sin necesidad de procedimientos manuales.
- Para cargas relacionales basadas en conjuntos, casi siempre: el motor ya contiene los datos y su precio está pensado exactamente para ese trabajo. Spark tiene su lugar en transformaciones muy grandes o no relacionales, que son una minoría de las cargas habituales del data warehouse.