Sind Ihre Qlik-Set-Analysis-Ausdrücke zu lang und zu langsam?
Set Analysis ist präzise für echte Vergleiche. Die meisten langen Ausdrücke in Ihrer App stehen dort, weil das Modell nie Historie, Flags oder eine einheitliche Granularität geliefert hat, und das Diagramm baut sie bei jeder Selektion neu.
Die Data-Warehouse-Automationsplattform, der Datenteams aus vielen Branchen vertrauen
Kommt Ihnen das bekannt vor?
- Ein einzelner Ausdruck zieht sich über mehrere Zeilen verschachtelter Set-Modifier und Aggr-Aufrufe.
- Diagramme zeigen nach jeder Selektion das Ladesymbol.
- Sie nutzen Set Analysis, um herauszufinden, welchen Wert etwas zu einem bestimmten Zeitpunkt hatte.
- Nur die Person, die die Master-Kennzahl geschrieben hat, traut sich, sie zu ändern.
Set Analysis ist das richtige Werkzeug für einen echten Vergleich, etwa dieses Jahr gegen das letzte. Es ist aber auch der Ort, an dem der Fix am Ende gemacht wird, wenn dem Modell etwas fehlt. Und diese Sorte macht die App langsam.
Wofür die langen Ausdrücke einspringen
- Historie. Datums-Modifier und
Aggrrekonstruieren den Zustand, den ein Datensatz letzten März hatte. - Flags.
If()-Bedingungen im Ausdruck entscheiden bei jeder Berechnung, was als aktiv oder gültig zählt. - Granularität.
AggrundOnlymachen Duplikate aus einer Tabelle rückgängig, die zwei Granularitäten gleichzeitig enthält. - Fehlende Beziehungen. Verschachtelte Modifier wie
{<Year={2024}>}kombiniert mitP()erledigen, was eine saubere Dimension tun würde.
Jeder davon wird pro Diagramm, pro Selektion, pro Nutzer ausgewertet. Das ist das Ladesymbol.
Warum es zu Ihrem Problem wird
- Jeder Ausdruck war in dieser Woche der schnellste Weg zu einer korrekten Zahl.
- Die Logik steckt in der
.qvf-Datei, also kann niemand außerhalb der App sie prüfen oder wiederverwenden. - Sie können den Ausdruck vereinfachen. Die Historie, die das Modell nie bewahrt hat, können Sie nicht ergänzen.
Die Arbeit passiert am falschen Ort
- Historie, Flags und Granularität sind Warehouse-Arbeit. In Set Analysis werden sie bei jeder Selektion neu berechnet.
- Sie gehört an einen zentralen Ort: ein Data Warehouse oder einen Data Hub, einmal gebaut und von jeder App gelesen.
- Wenn das teuer klingt, geht die Schätzung vermutlich von handgebauten Pipelines aus. Eine spezialisierte Automatisierungsplattform generiert sie aus einem Modell. Das ändert sowohl die Kosten als auch die Dauer.
Was sich ändert, wenn das Modell fertig geliefert wird
Datavault Builder generiert Vault und Star-Schema nativ in der Datenbank, die Sie bereits nutzen, darunter SQL Server, Azure SQL, Oracle, Snowflake und Databricks.
- Historie liegt in Satelliten, und Point-in-Time-Tabellen beantworten “wie sah es im März aus” mit einem Join.
- Flags sind Spalten, einmal im Warehouse berechnet statt in jedem Ausdruck.
- Eine Granularität pro Faktentabelle, das erspart den Großteil der
Aggr-Arbeit komplett. - Konforme Dimensionen geben Set-Modifiern echte Felder zum Selektieren.
- Übrig bleiben echte Vergleiche, und die sind kurz genug, dass eine Kollegin sie lesen kann.
Worum Sie bitten sollten
Nicht “das Dashboard ist langsam”, sondern:
“Unsere Set-Analysis baut bei jeder Selektion den Zustand zu einem Zeitpunkt und Status-Flags nach. Kann uns das Warehouse eine Point-in-Time-Tabelle und die Flags als Spalten liefern, damit die Ausdrücke einfache Summen werden?”
Das trennt die Set-Analysis, die Sie wirklich brauchen, von der, die Sie als Flicken benutzen.
Erleben Sie es live mit Ihren eigenen Daten
Buchen Sie eine kostenlose Demo und bringen Sie den Report mit, der Ihnen die meisten Probleme macht.
In drei Schritten zu Zahlen, die aufgehen
-
Bestehende Logik herauslösen
Sammeln Sie Berechnungen, Joins und Filter, die heute in Ihren Reports stecken.
-
An einem Ort zentralisieren
Die Logik kommt einmal ins Warehouse-Modell, und jeder Report liest dieselbe Definition.
-
Zahlen, die aufgehen
Jeder Report zeigt dieselbe Zahl, und “Woher kommt diese Zahl” hat eine sichtbare Antwort.
Wie Datavault Builder Ihrem Report ein fertiges Modell liefert
-
Das Modell kommt fertig an
Datavault Builder generiert Vault und Star-Schema so, dass sie nativ in der Datenbank laufen, die Sie bereits haben: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks oder BigQuery.
-
Die Arbeit verlässt den Report
Kein Merge, kein Parsen, kein Fuzzy Match. Diese Arbeit ist aus dem Report verschwunden.
-
Quellen kommen integriert an
Kunden aus ERP, CRM und Webshop werden zu einem Satz konformer Dimensionen zusammengeführt. Der Join passiert einmal im Warehouse, nicht erneut in jedem Report.
-
Historie, die abfragbar ist
Jede Änderung wird so festgehalten, wie sie eintrifft. Sie können den Stand von damals genauso auswerten wie den von heute, auch wenn das Quellsystem seine eigenen Sätze überschreibt.
-
Jede Zahl hat Lineage
Die Logik bekommt Lineage. “Woher kommt diese Zahl” hat damit eine sichtbare Antwort.
-
Historisierung im Warehouse
Historisierung übernimmt das Warehouse als Vault-Satelliten, statt sie zu approximieren.
Ausgezeichnet von BARC im Data Fabric Survey 26
Sprechen Sie mit unserem Experten
Zwanzig Minuten mit unserem Sales Director und eine ehrliche Antwort, ob das zu Ihrer Situation passt.
Matt Collett
Sales Director
Perfekt, wählen Sie einen passenden Termin:
Weitere Probleme in dieser Serie
-
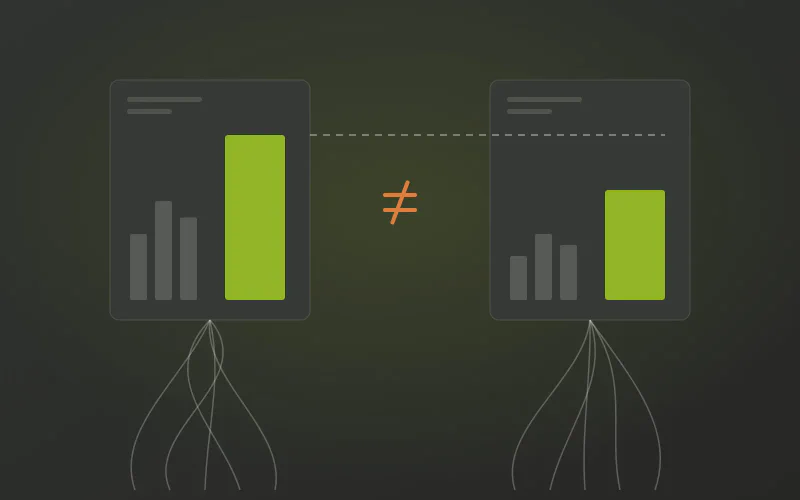
Zeigen Ihre Qlik-Apps und Power-BI-Reports unterschiedliche Zahlen?
Weder Qlik noch Power BI liegt falsch. Jedes Tool hat seine eigene Ladelogik, seine eigenen Definitionen und seine eigene Lineage, also wird dieselbe Kennzahl zweimal berechnet und niemand kann sie abgleichen. Die Regeln gehören in ein zentral verwaltetes Warehouse-Modell, das beide Tools lesen.
-
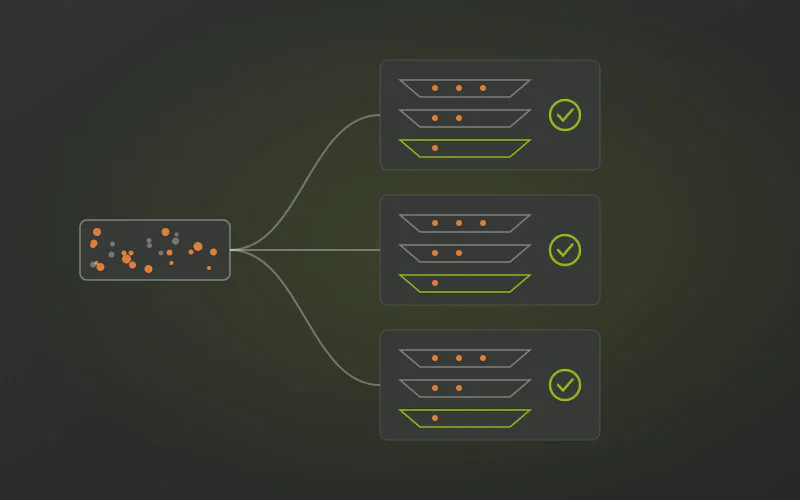
Bereinigen Sie dieselben Daten in jedem Qlik-Ladeskript erneut?
Dieselben Mapping-Loads, String-Korrekturen und Deduplizierungen werden in jeder App und jeder QVD-Schicht neu geschrieben, und die Kopien laufen auseinander. Die Bereinigung wiederholt sich pro Skript, weil keine integrierte Warehouse-Schicht sie einmal erledigt.
-
Erzeugen Ihre Qlik-Apps immer wieder synthetische Schlüssel?
Synthetische Schlüssel und zirkuläre Referenzen sind Qlik, das genau das verknüpft, was es bekommen hat. Sie entstehen, weil die Daten ohne konforme Dimensionen oder echte Schlüssel ankommen, und deshalb muss jede App sie selbst erfinden.