Wird jedes Azure Data Factory Release zu einem Kampf mit ARM-Templates?
Unter dem visuellen Editor ist eine Azure Data Factory JSON: Pipelines, Datasets, Linked Services und das ARM-Template, das sie deployt. Eine Änderung von Dev nach Prod zu bringen heißt Parameterdateien, globale Parameter und ein Template, das an einem einzigen Typkonflikt scheitert. Releases sollten aus einem Modell generiert werden, mit dem Rollback inklusive.
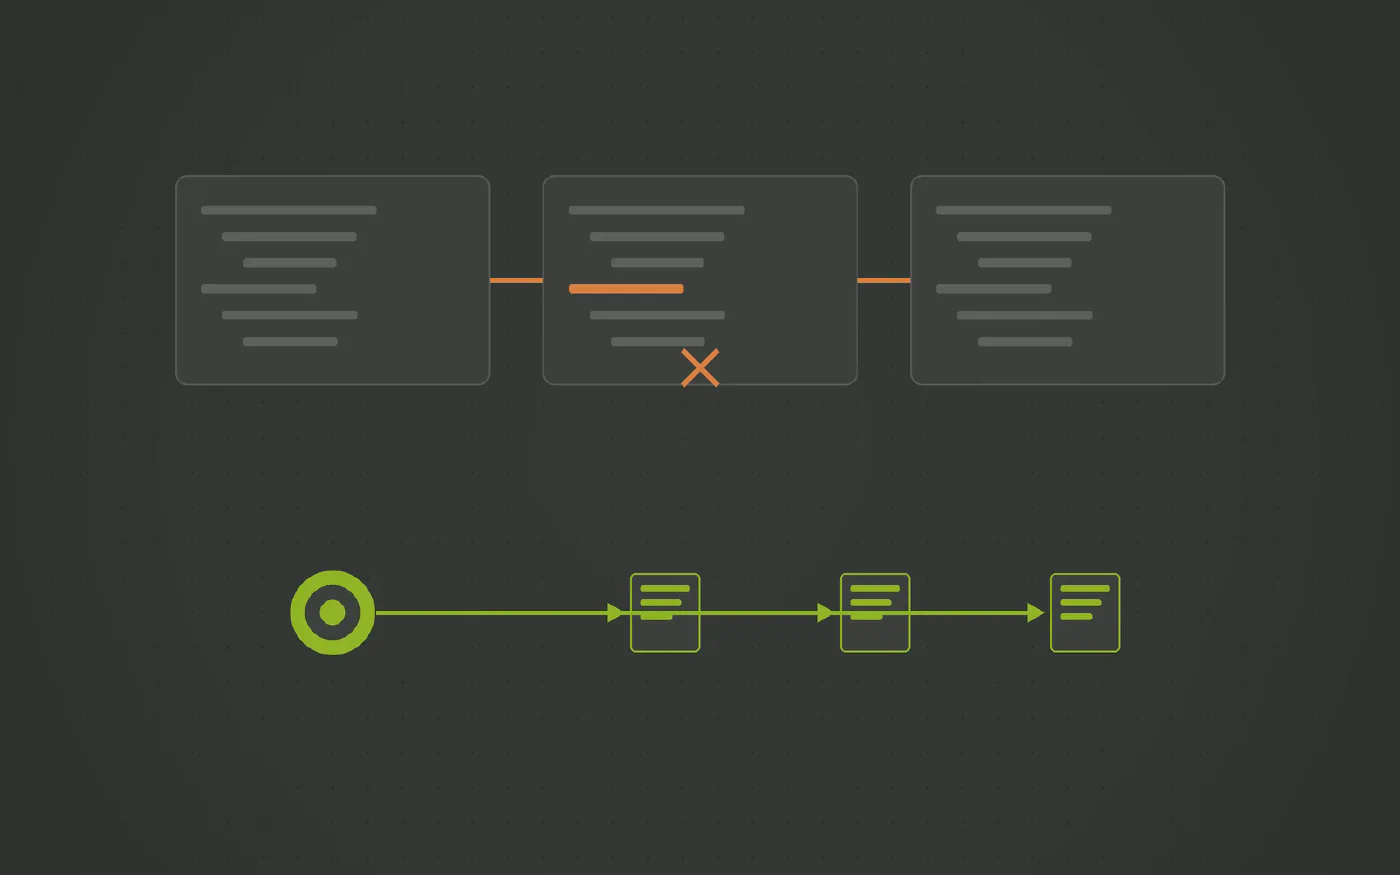
Die Data-Warehouse-Automationsplattform, der Datenteams aus vielen Branchen vertrauen









Kommt Ihnen das bekannt vor?
- Ein Release nach Prod scheitert am ARM-Deployment-Schritt, und der Fix ist eine Parameterdatei, an deren Bearbeitung sich niemand erinnert.
- Dev, Test und Prod haben jeweils eine leicht unterschiedliche Linked-Service-Konfiguration, von Hand an drei Stellen gepflegt.
- Eine Dataset-Definition wurde in einer Pipeline geändert und hat eine andere gebrochen, weil beide darauf verwiesen und nur eine getestet wurde.
- Für einen Rollback deployen Sie das vorherige ARM-Template neu und hoffen, dass die Datasets, auf die es verweist, noch existieren.
Azure Data Factory versteckt sein JSON gut, bis zum Tag eines Release. Dann kommen das ARM Template, die Parameterdateien, die globalen Parameter und die Linked-Service-Überschreibungen alle auf einmal zum Vorschein, und ein einziger Typkonflikt hält das Deployment an, bis jemand ihn findet.
Warum Releases fragil sind
- Die Pipeline ist JSON, ob Sie es sehen oder nicht. Der visuelle Editor schreibt Pipeline-, Dataset- und Linked-Service-Definitionen, und Publizieren kompiliert sie in ein ARM-Template. Manche Teams verpacken das in Bicep; das Artefakt darunter ist dasselbe.
- Umgebungsunterschiede werden über Parameterdateien gesteuert. Dev, Test und Prod unterscheiden sich in Connection Strings, Schlüsseln und Namen, und diese Unterschiede leben in Dateien, die von Hand gepflegt werden.
- Abhängigkeiten sind implizit. Datasets und Linked Services werden über Pipelines hinweg geteilt; eine für die getestete Pipeline zu ändern, ändert sie auch für die nicht getesteten.
- Ein Rollback ist ein erneutes Deployment des alten Standes. Zurückgehen heißt das vorherige Template, und alles, worauf es verweist, muss noch existieren.
ADF verhält sich wie jede Azure-Ressource: Es wird als Template ausgerollt. Templates sind für die Bereitstellung statischer Infrastruktur gebaut, Storage Accounts und Netzwerke. Ein Warehouse Schema ist zustandsbehaftet und ändert sich mit jedem Release, und das ist die falsche Form für dieses Werkzeug.
Wo Release-Management hingehört
- In den Generator. Wenn das Warehouse aus einem Modell kommt, ist ein Release der Unterschied zwischen zwei Zuständen dieses Modells, und das Tool weiß, wovon jeder Unterschied abhängt.
- Mit dem Rollback inklusive. Ein generiertes Release weiß, was es geändert hat, das Umkehrskript existiert also, bevor das Release läuft.
- Verglichen statt gehofft. Der Unterschied zwischen Test und Prod sollte ein Bericht sein, keine Entdeckung.
Was sich mit Datavault Builder ändert
Datavault Builder baut ein Release, indem es zwei Zustände vergleicht, mit Git und Gitflow Unterstützung eingebaut. Ein Zustand ist Ihre lokale Umgebung, ein in Git gespeicherter Zustand, eine andere Live-Umgebung, eine ZIP-Datei oder ein Ordner; der Vergleich listet die Unterschiede, und Sie wählen, welche deployt werden.
- Kein Template zu pflegen. Das Release ist die Menge der Unterschiede, die Sie ausgewählt haben, generiert für die Zielumgebung. Wählen Sie ein Datenprodukt, und das Tool schlägt den Hub, den Satelliten, die Staging-Tabelle und die Quelle vor, die es braucht.
- Der Rollback wird mitgeneriert. Jedes Release trägt seine Umkehrung, und die Modellversion, zu der es gehört.
- Umgebungen werden verglichen statt auf gut Glück deployt. Was Prod gleich erhält, ist die Liste der Unterschiede zwischen seinem Zustand und dem, den Sie deployen.
- Schema-Änderungen an den Quellen brauchen kein Release. Fehlende Spalten werden als Null mit Warnung geladen, wachsende Spalten werden verbreitert, neue Spalten sind ein Mapping-Update.
- Ihre bestehende CI/CD-Toolchain bleibt erhalten. Azure DevOps oder GitHub Actions führen das generierte Paket aus; sie müssen das Warehouse nicht mehr verstehen.
Was zu entscheiden ist
Analysieren Sie Ihren Release-Prozess und prüfen Sie zwei Punkte: die Parameterdateien und Überschreibungen pro Umgebung, die er pflegt, und die Releases im letzten Quartal, die am Template-Schritt gescheitert sind. Das ist die Wartung, die ein generiertes Release beseitigt.
Erleben Sie es live mit Ihren eigenen Datenquellen
Buchen Sie eine kostenlose Demo und bringen Sie den Connector mit, der Sie am meisten kostet, an Geld oder an Zeit.
In drei Schritten zu einer Pipeline, die Sie kontrollieren
-
Modell von Deployment trennen
Die Warehouse Struktur ist ein Modell. Das Deployment ist ein generiertes Skript für eine Zielumgebung, kein von Hand gepflegtes Template.
-
Das Release generieren
Datavault Builder vergleicht zwei Zustände, wählt die zu deployenden Unterschiede aus und schlägt die Abhängigkeiten vor, die jeder braucht. Der Rollback kommt mit.
-
Vergleichen, bevor Sie befördern
Zwei beliebige Zustände lassen sich vergleichen: Ihre lokale Umgebung, ein Zustand in Git, eine andere Live-Umgebung, eine ZIP-Datei oder ein Ordner.
Wie Datavault Builder die Reibungsverluste in der Ingestion beseitigt
-
Ingestion ist eingebaut
Batch-, Delta- und CDC-Ladevorgänge aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen, mit Streams wie Kafka, die als Micro-Batches ankommen. Dieselbe Plattform, die das Warehouse generiert, keine zweite Rechnung.
-
Ihr Schema, nicht das des Anbieters
Quelltabellen werden auf ein Data-Vault-2.0-Modell gemappt, das Sie entworfen haben. Eine neue Spalte oder eine umbenannte Tabelle ändert ein Mapping, keine Kette von Skripten nach dem Load.
-
Nur Deltas bewegen sich
Hubs, Links und Satelliten laden, was sich geändert hat. Vollständige Ladevorgänge bleiben im Staging, statt jede Nacht weiter unten neu verarbeitet zu werden.
-
Historie wird von Haus aus behalten
Jede Änderung wird so festgehalten, wie sie eintrifft. Historien- und Stichtagsabfragen funktionieren also auch dort, wo die Quelle ihre eigenen Zeilen überschreibt.
-
Code, den Sie nie von Hand schreiben
Laden, Historisierung und Lineage werden in Echtzeit aus dem Modell generiert und laufen nativ auf Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle oder PostgreSQL.
-
Eine Plattform, bis zu neun Tools weniger
Modellierung, ETL, CI/CD, Dokumentation und Lineage an einem Ort. Das ist es, was 14,7 Minuten von der Anforderung bis zur Produktion möglich macht.
Ausgezeichnet von BARC im Data Fabric Survey 26







Sprechen Sie mit unserem Experten
Zwanzig Minuten mit unserem Sales Director und eine ehrliche Antwort, ob das zu Ihrem Stack passt.

Matt Collett
Sales Director
Perfekt, wählen Sie einen passenden Termin:
Weitere Probleme in dieser Serie
-
Azure Data Factory Schwachstellen: Die versteckten Kosten von UI-Pipelines und Spark-Transformationen
Azure Data Factory ist eine solide Transportschicht innerhalb von Azure, eignet sich jedoch nicht für die Modellierung und Transformation eines Data Warehouse. Als All-in-One-Lösung führt es zu unübersichtlichen Pipeline-Diagrammen, fehleranfälligen ARM-Deployments und teuren Spark-Clustern für einfache SQL-Loads – und bindet die gesamte Logik unwiderruflich an Azure.
-
Kosten Ihre Azure Data Factory Mapping Data-Flows mehr als die Daten, die sie bewegen?
Mapping Data-Flows laufen auf einem verwalteten Spark-Cluster, der Minuten zum Starten braucht und pro vCore-Stunde abgerechnet wird. Für eine große nächtliche Transformation ist das vernünftig. Für ein paar Hunderttausend Zeilen ist es ein Cluster, der hochgefahren wird, um zu tun, was ein einziges SQL-Statement im Warehouse tun würde.
-
Ist Ihr Azure Data Factory Canvas dem Team entwachsen, das ihn aufgebaut hat?
Eine Drag-and-Drop-Pipeline ist schnell zusammengeklickt, aber nur langsam anzupassen. Ab ein paar Dutzend Aktivitäten wird das Canvas zur Dokumentation, die visuelle Verdrahtung ersetzt die Fachlogik, und jede neue Quelle ist eine weitere Copy-Aktivität, die niemand anfassen will. Die Lösung ist kein aufgeräumterer Canvas. Es ist ein Modell, das die Pipelines generiert.
Fragen und Antworten
- Es ist Versionskontrolle plus ein Publish-Schritt, und das Utilities-Paket kann diesen Schritt bei jedem Merge headless ausführen statt per Klick in der UI. Was es validiert, ist das Template. Das Artefakt ist weiterhin Pipeline-JSON mit einer Parameterdatei pro Umgebung, und eine Referenz, die in Dev existiert, aber nicht in Prod, wird zur Deployment-Zeit gefunden. Der Unterschied ist ein Release, das aus einem Modell generiert wird, das weiß, wovon jede Änderung abhängt, mit dem Rollback inklusive.
- Nein. Es generiert das Datenbank Deployment Paket; Azure DevOps oder GitHub Actions können das Release weiterhin ausführen. Was verschwindet, ist das von Hand gepflegte Template und die Parameterdateien pro Umgebung.
- Eine Quellspalte, die verschwindet, wird als Null mit einer Warnung geladen, nicht als gescheiterter Lauf, und eine Spalte, die wächst, wird verbreitert. Eine neue Spalte ist ein Mapping-Update. Nichts davon braucht ein Release der Pipeline Schicht.